
 WulingTăng trưởng bền vững từ chiến lược SEO
 SCGNghiệm thu dự án sớm 2 tháng
 cirCOVượt KPI trước 3 tháng
Bạn muốn kiểm tra toàn bộ website để biết trang nào đang hỏng, trang nào Google không đọc được, trước khi những lỗi đó làm giảm lượng khách?
Tôi là Thái Doãn Kiên. Screaming Frog đi qua từng trang của website giống cách Google đọc website, rồi gom các trang hỏng, trang thiếu thông tin vào một bảng, nên bạn biết cần sửa chỗ nào trước thay vì đợi lượng khách giảm mới đi tìm.
Đọc xong, bạn cài được Screaming Frog SEO Spider, đọc được giao diện và tự làm 12 việc audit website theo mức ưu tiên, với bản miễn phí đủ cho website dưới 500 URL.
Tóm tắt nhanh
- Screaming Frog là gì: phần mềm cài trên máy tính, đi qua từng trang của website rồi gom trang hỏng, trang thiếu thông tin vào một bảng.
- Dùng để làm gì: biết trang nào hỏng, trang nào Google khó đọc để sửa trước khi lượng khách giảm.
- Có miễn phí không: bản miễn phí đủ cho website dưới 500 URL, website lớn hơn cần bản quyền 279 USD mỗi người mỗi năm (giá tháng 10/2026).
- Bắt đầu thế nào: chỉ tải từ trang của hãng và không dùng bản crack, vì bản crack có rủi ro lộ dữ liệu.
- Sửa gì trước: lỗi khiến Google không vào được trang hoặc không đưa trang lên Google, sau đó mới đến liên kết và nội dung.
- Lưu ý: Screaming Frog không phải Google, nên trang có trên Google hay chưa vẫn phải xem trong Search Console.
1. Screaming Frog là gì?
Hiểu Screaming Frog làm được gì và không làm được gì giúp bạn dùng đúng công cụ cho đúng câu hỏi khi audit.
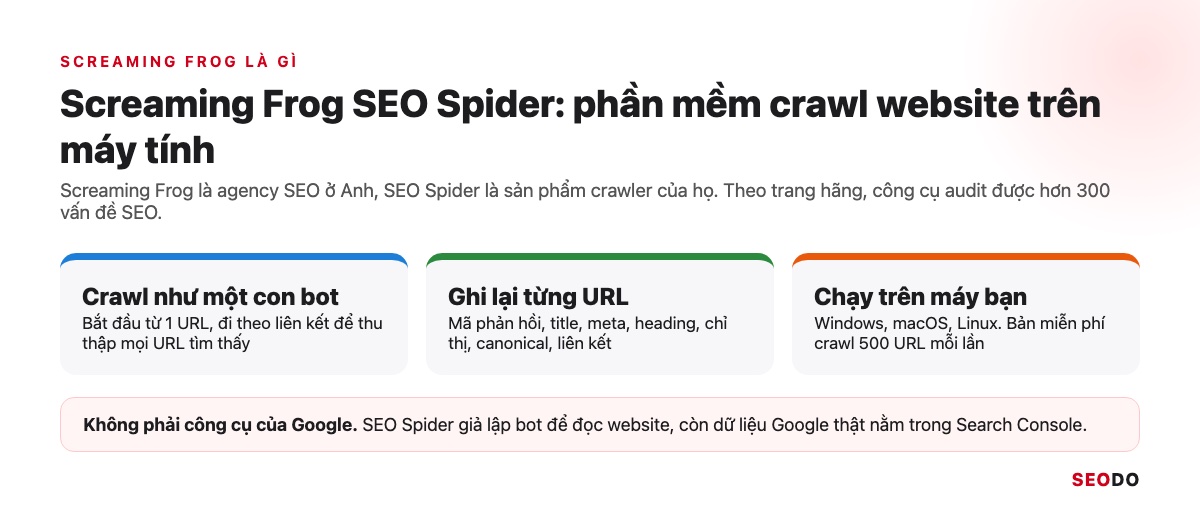
Screaming Frog SEO Spider là crawler cài trên máy tính, đi theo liên kết và ghi mã phản hồi, thẻ, chỉ thị của từng URL. Đây không phải công cụ của Google, dữ liệu Google thật nằm trong Search Console.
Screaming Frog là công ty agency SEO ở Anh, và sản phẩm nổi tiếng nhất của họ là Screaming Frog SEO Spider, phần mềm crawl website cài trên máy tính. Theo trang SEO Spider của hãng, công cụ audit được hơn 300 vấn đề SEO và chạy trên Windows, macOS lẫn Linux.
Trong bộ công cụ SEO của SEODO, Screaming Frog giữ vai trò thu thập dữ liệu kỹ thuật. Nó trả lời câu hỏi website đang có gì, còn việc xếp ưu tiên sửa lỗi nằm trong quy trình SEO audit.
1.1. Screaming Frog SEO Spider hoạt động như thế nào
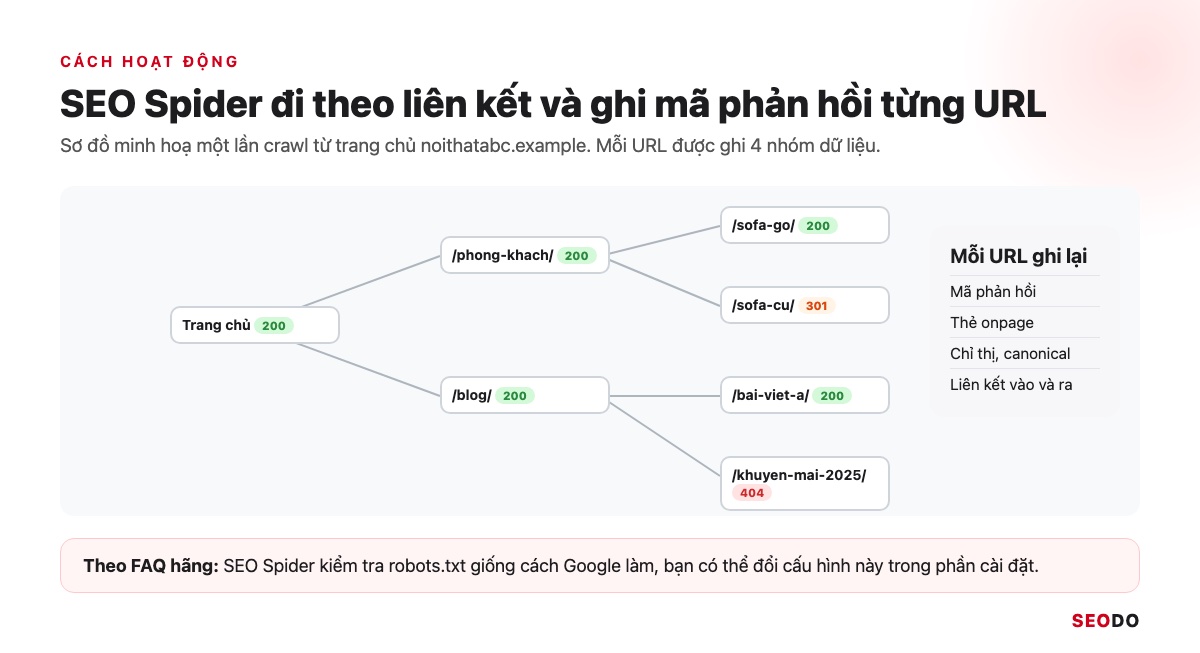
SEO Spider bắt đầu từ 1 URL, tải trang về, trích liên kết rồi đi tiếp sang từng URL tìm thấy, giống một con bot tìm kiếm. Với mỗi URL, công cụ ghi 4 nhóm dữ liệu:
- Mã phản hồi
- Thẻ onpage
- Chỉ thị: noindex, canonical.
- Liên kết vào ra
Theo FAQ của hãng, SEO Spider tuân thủ robots.txt giống Google trừ khi bạn đổi cấu hình.
1.2. Screaming Frog dùng để làm gì
Screaming Frog dùng để tìm lỗi kỹ thuật và onpage trên toàn website trong một lần chạy. Dùng thạo nghĩa là mỗi việc cần kiểm tra gắn được với 1 tab hoặc 1 báo cáo.
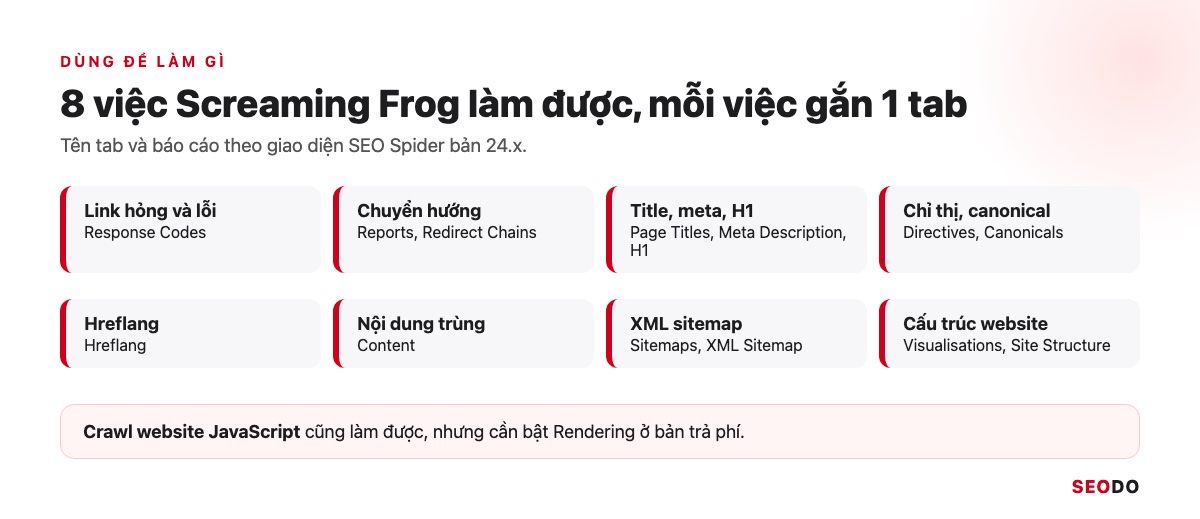
| Việc | Tab hoặc tính năng | Ví dụ |
| Tìm link hỏng, lỗi máy chủ | Response Codes | Bài đã xoá vẫn nằm trong menu |
| Rà chuyển hướng | Reports, Redirect Chains | http sang https sang www thành 2 bước |
| Kiểm tra title, meta, H1 | Page Titles, Meta Description, H1 | Title trùng ở trang phân trang |
| Kiểm tra chỉ thị, canonical | Directives, Canonicals | noindex còn sót sau khi dựng website |
| Audit hreflang | Hreflang | Thiếu liên kết trả về giữa 2 phiên bản ngôn ngữ |
| Tìm nội dung trùng | Content | Trang sản phẩm chỉ khác màu sắc |
| Tạo sitemap | Sitemaps, XML Sitemap | Sitemap chỉ chứa URL trả 200 |
| Xem cấu trúc website | Visualisations, Site Structure | Trang quan trọng nằm quá sâu |
1.3. SEO Spider khác Log File Analyser thế nào
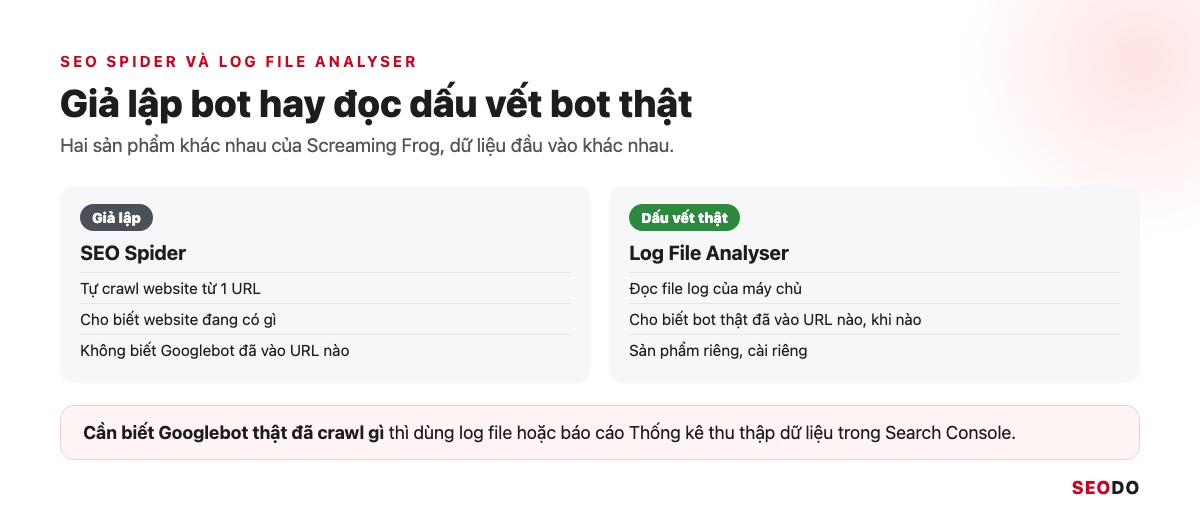
SEO Spider giả lập bot để crawl, còn Log File Analyser là sản phẩm riêng của hãng, đọc file log máy chủ để biết bot thật đã vào URL nào, lúc nào. Vì vậy cần biết Googlebot thật đã thu thập gì thì dùng log file hoặc báo cáo Thống kê thu thập dữ liệu trong Search Console.
2. Screaming Frog SEO Spider miễn phí và bản trả phí khác nhau thế nào?
Biết chính xác bản miễn phí bị khoá những gì giúp bạn quyết định khi nào cần mua license và mua cho ai.
Bản miễn phí crawl tối đa 500 URL mỗi lần và khoá tính năng nâng cao, license 279 USD mỗi người dùng mỗi năm bỏ giới hạn crawl. Hết hạn license, công cụ trở về bản miễn phí.
Bản miễn phí của Screaming Frog crawl tối đa 500 URL mỗi lần và khoá phần lớn tính năng nâng cao. License giá 279 USD (199 GBP, 245 EUR) mỗi người dùng mỗi năm theo trang Pricing, khi đó số URL chỉ còn phụ thuộc bộ nhớ của máy.
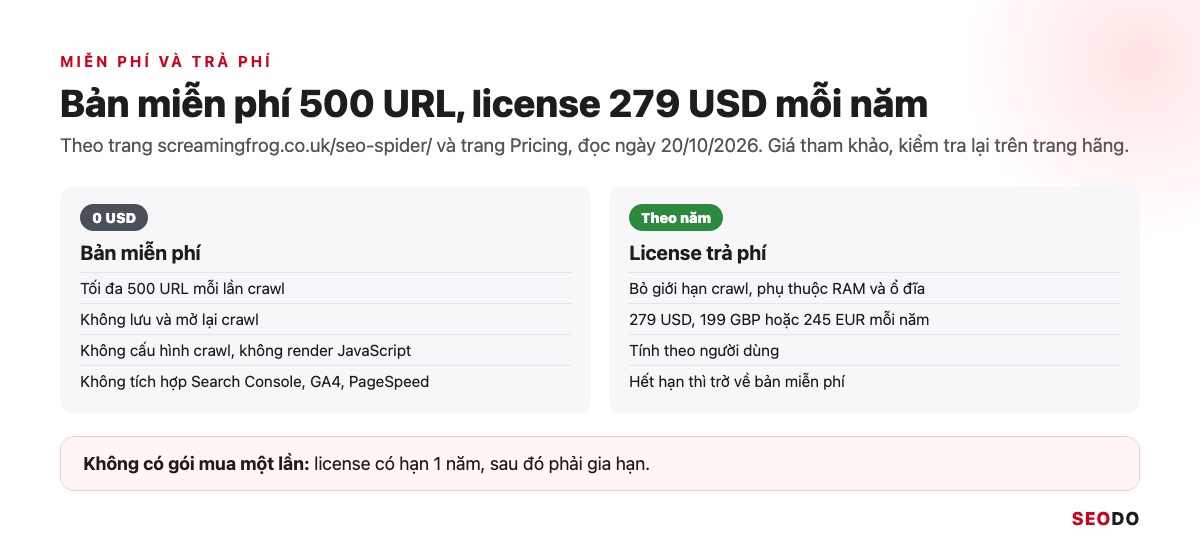
License có hạn 1 năm, không có gói mua một lần. Theo FAQ của hãng, hết hạn thì giới hạn 500 URL được áp lại và crawl đã lưu không mở được. Nên xuất báo cáo cần giữ trước ngày đó.
2.1. Giới hạn 500 URL và các tính năng bị khoá ở bản miễn phí
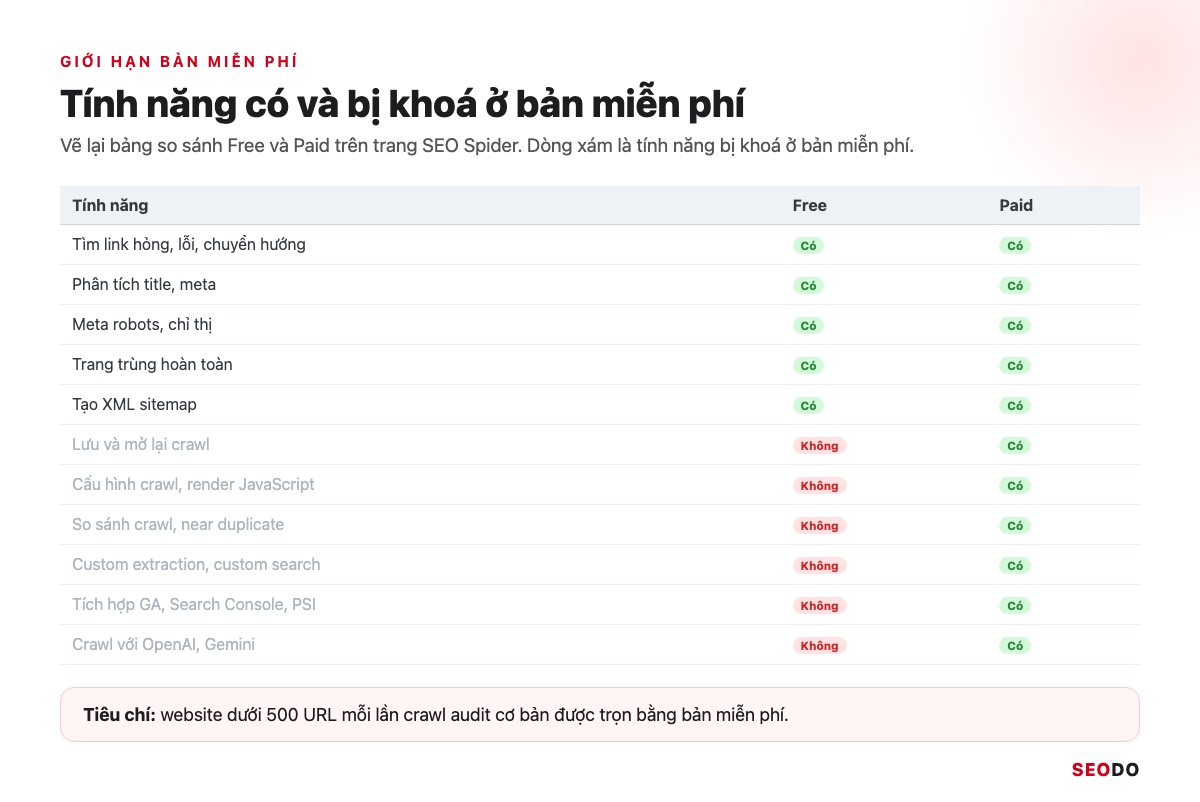
Tính năng của SEO Spider chia làm hai phần:
- Bản miễn phí vẫn làm được: tìm link hỏng, chuyển hướng, title, meta, chỉ thị, hreflang, trang trùng hoàn toàn, tạo XML sitemap và xem cấu trúc website.
- Phần bị khoá: lưu crawl, cấu hình crawl, render JavaScript, so sánh crawl, near duplicate, custom extraction, tích hợp Google, AI và đăng nhập bằng form.
Dễ nhớ nhất là website dưới 500 URL mỗi lần crawl thì audit cơ bản trọn bằng bản miễn phí.
2.2. Giá license Screaming Frog năm 2026
Giá giảm theo bậc khi mua nhiều license, và license tính theo người dùng chứ không theo máy, nên 2 người cùng dùng thì cần 2 license.
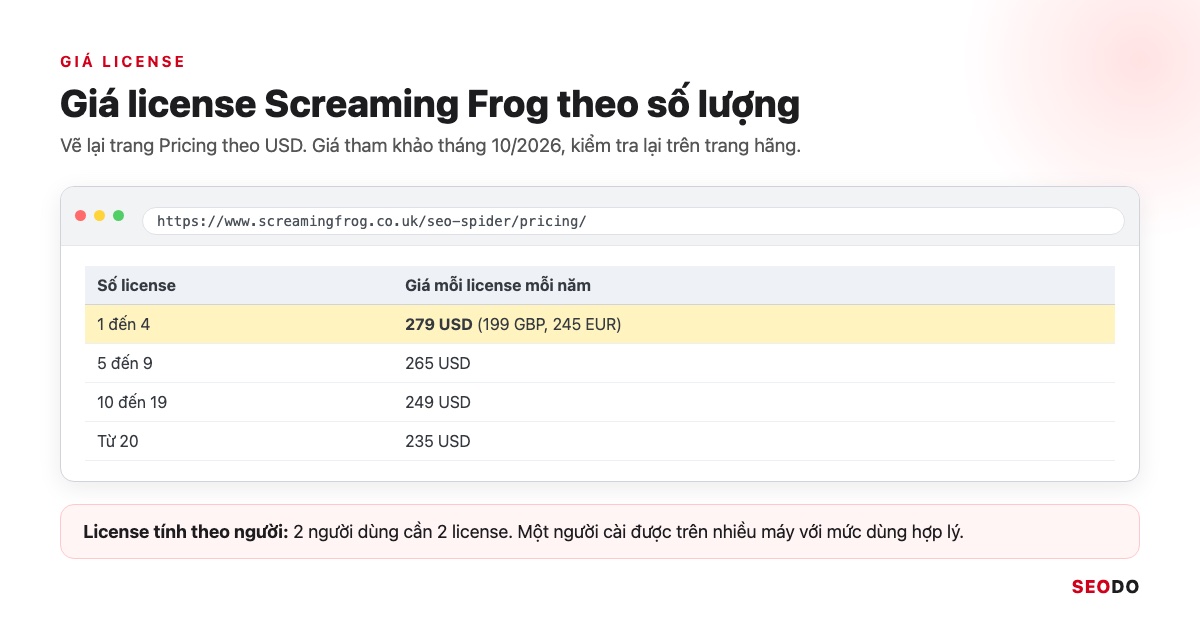
| Số license | Giá mỗi license mỗi năm |
| 1 đến 4 | 279 USD (199 GBP, 245 EUR) |
| 5 đến 9 | 265 USD |
| 10 đến 19 | 249 USD |
| Từ 20 | 235 USD |
Giá tham khảo tháng 10/2026, kiểm tra lại trên trang hãng.
2.3. Phiên bản mới nhất và các tính năng mới của bản 24
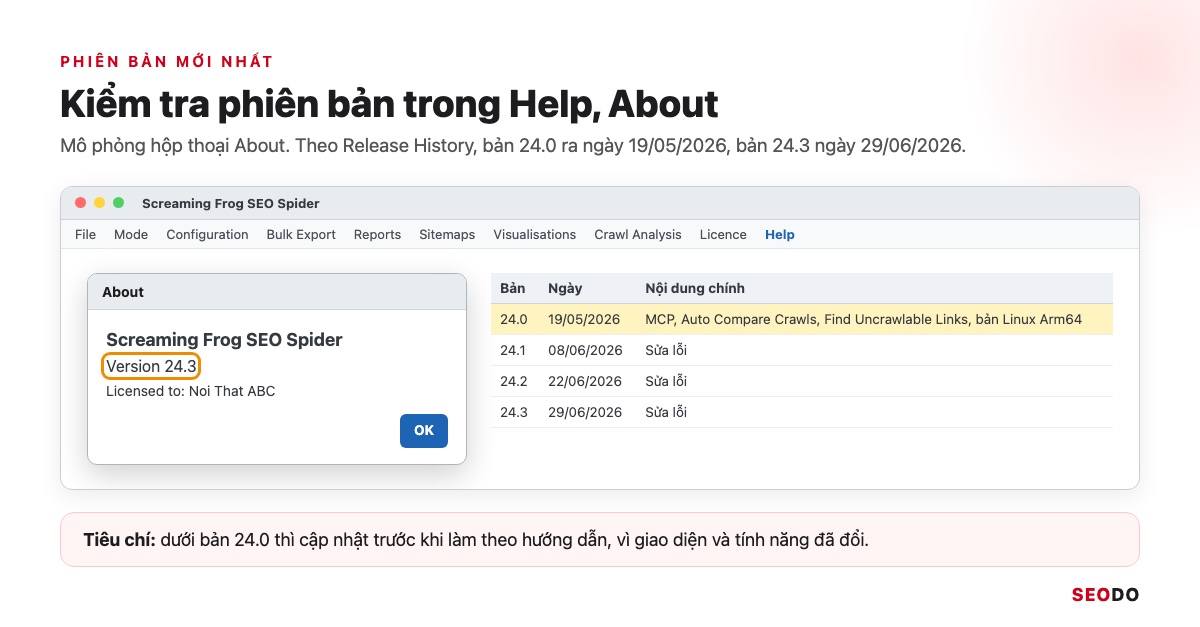
Theo Release History, bản 24.0 ra ngày 19/05/2026 với 4 điểm mới:
- SEO Spider MCP.
- Auto Compare Crawls.
- Find Uncrawlable Links.
- Bản Linux Arm64.
Các bản 24.1 đến 24.3 (29/06/2026) là bản sửa lỗi. Trước khi làm theo hướng dẫn nào, bạn mở Help, About xem phiên bản. Dưới 24.0 thì cập nhật trước.
3. Cách tải, cài đặt và cấu hình Screaming Frog trước khi crawl
Cài đúng nguồn và cấu hình bộ nhớ ngay từ đầu giúp bạn tránh treo máy ở lần crawl lớn đầu tiên.
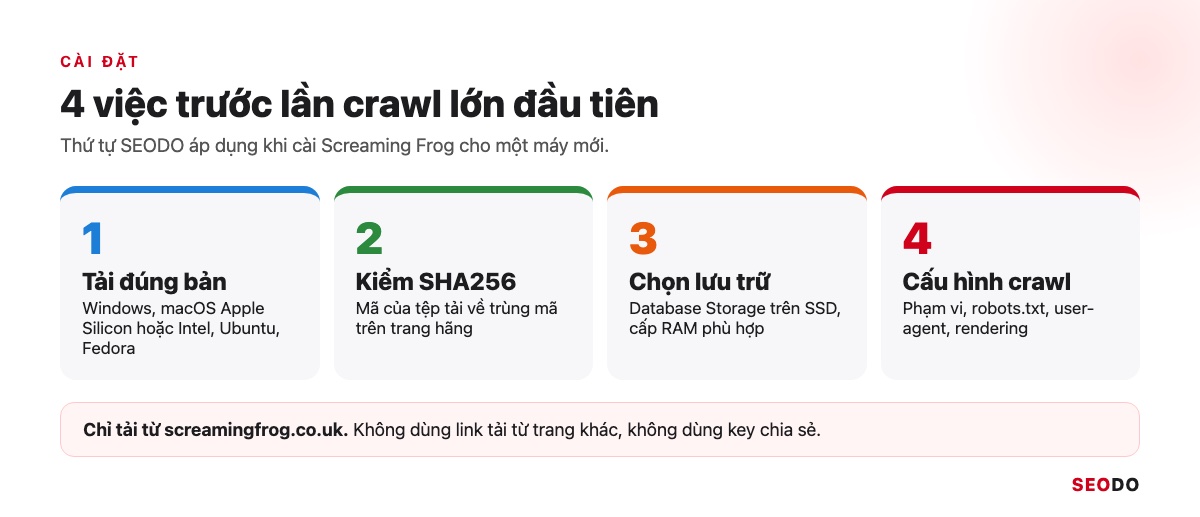
Trước lần crawl lớn đầu tiên, tải đúng bản từ screamingfrog.co.uk và kiểm mã SHA256. Sau đó chọn Database Storage trên SSD, cấp RAM và cấu hình phạm vi crawl.
Bạn tải Screaming Frog từ screamingfrog.co.uk, chọn đúng bản cho Windows, macOS (Apple Silicon hoặc Intel), Ubuntu hay Fedora, rồi cấu hình lưu trữ và bộ nhớ. Bỏ qua bước cấu hình là lý do nhiều người gặp cảnh phần mềm đứng hình giữa chừng.
3.1. Tải đúng bản và kiểm tra tệp cài đặt
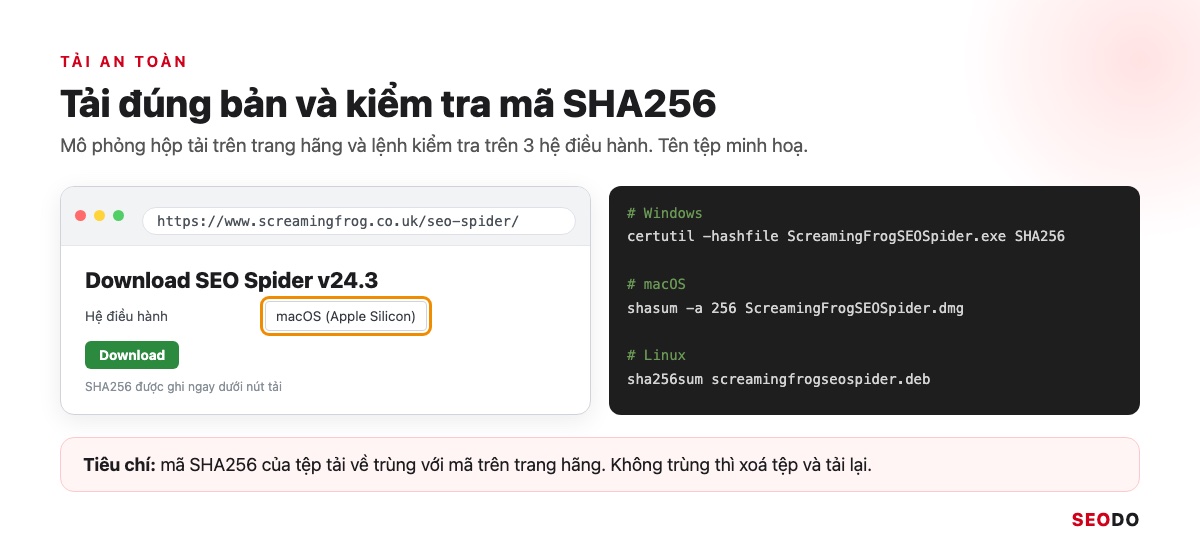
Screaming Frog an toàn khi bạn tải trên trang hãng và kiểm tra tệp. Trang tải ghi mã SHA256 của từng bản, và bạn so mã bằng công cụ có sẵn của từng hệ điều hành:
- Windows: certutil.
- macOS: shasum.
- Linux: sha256sum.
Mã phải trùng hoàn toàn, không trùng thì xoá tệp tải lại.
3.2. Chọn Database Storage và cấp bộ nhớ RAM
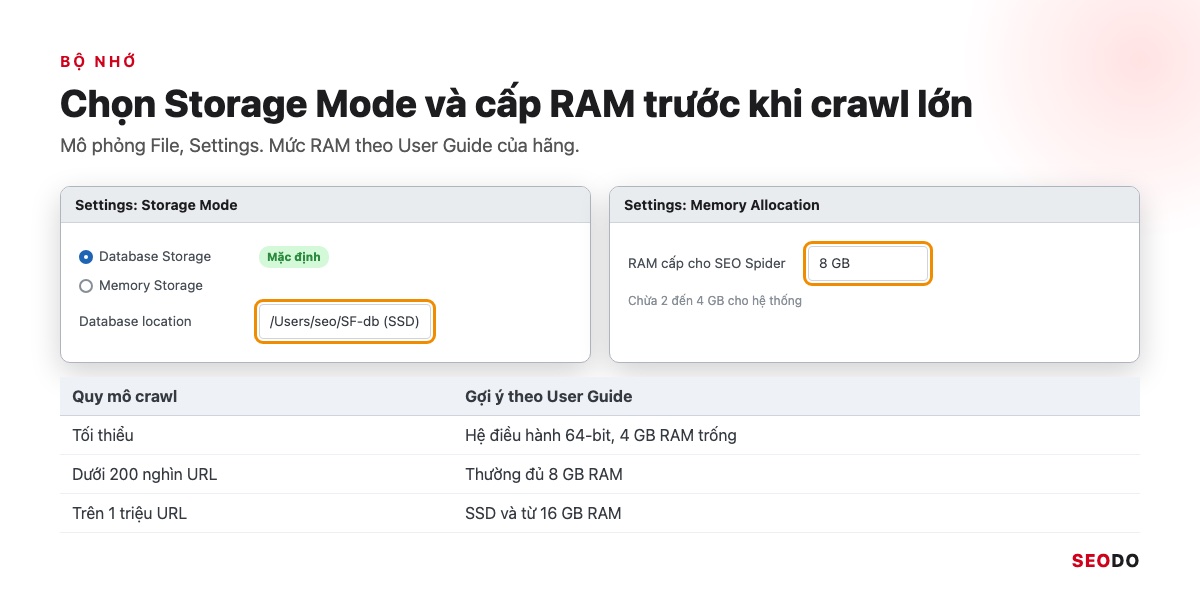
Theo User Guide, Database Storage là chế độ mặc định, lưu dữ liệu xuống ổ đĩa và tự lưu crawl, còn Memory Storage giữ mọi thứ trên RAM. Tối thiểu cần 4 GB RAM trống. Dưới 200 nghìn URL thường đủ 8 GB, trên 1 triệu URL nên dùng SSD và từ 16 GB RAM. SEODO luôn đặt Database Storage trên SSD.
3.3. Chọn chế độ Spider, List, SERP, Compare
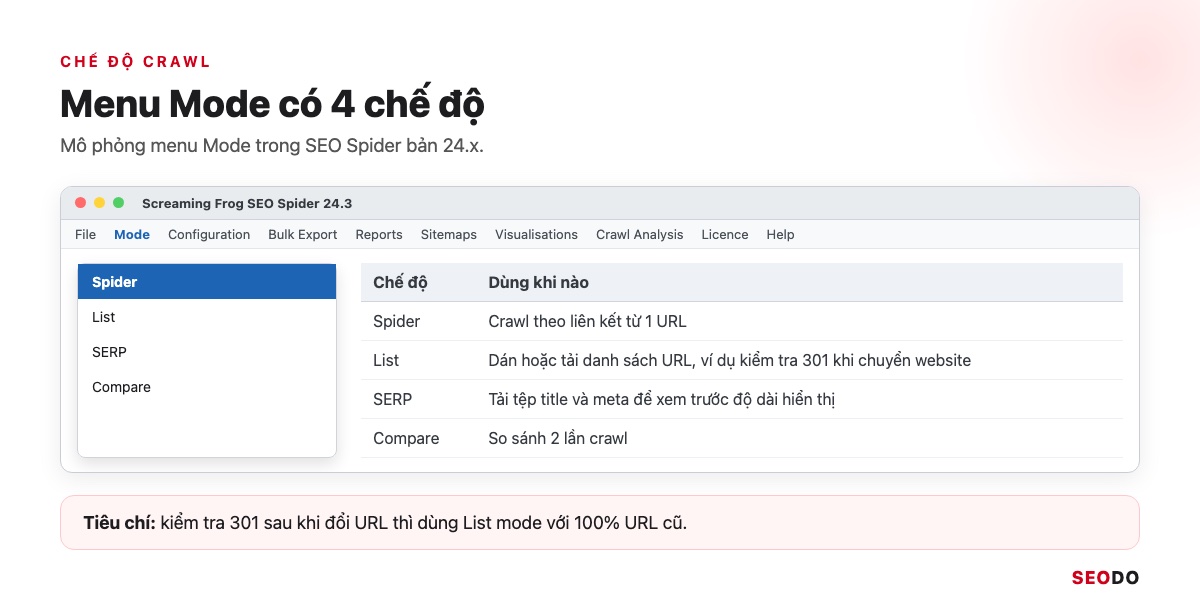
Menu Mode có 4 chế độ:
- Spider: crawl theo liên kết.
- List: kiểm tra danh sách URL dán sẵn.
- SERP: xem trước độ dài title, meta.
- Compare: so 2 lần crawl.
Kiểm tra chuyển hướng sau khi đổi URL thì dùng List mode với 100% URL cũ, vì Spider chỉ đi theo link đang có trên website mới.
3.4. Cấu hình crawl cơ bản: phạm vi, robots.txt, user-agent, render JavaScript
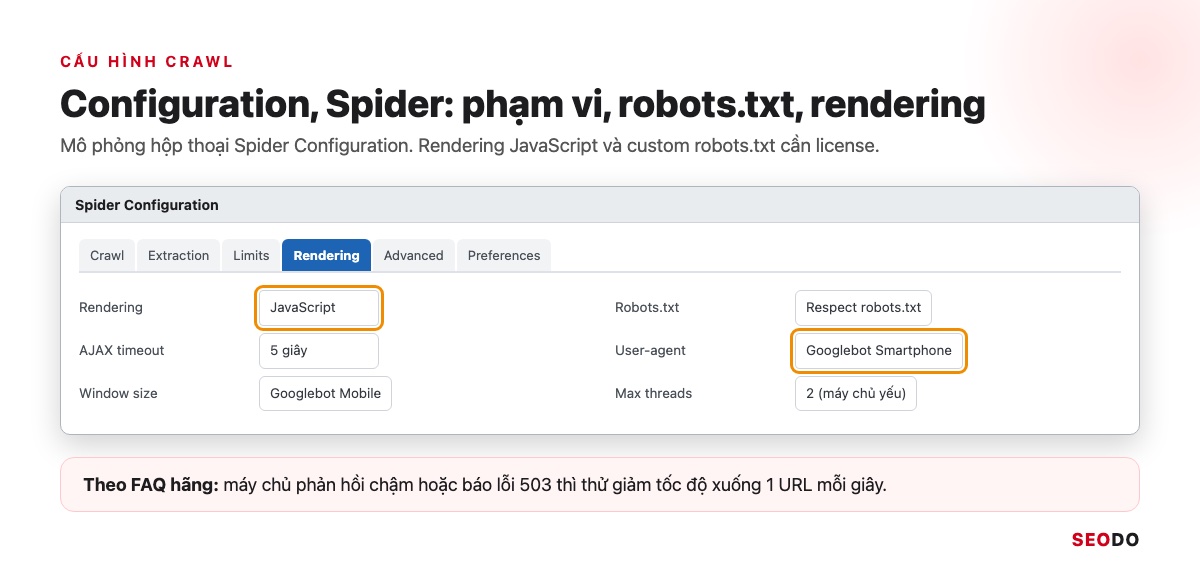
Trong Configuration, Spider, bạn chỉnh 4 mục:
- Phạm vi crawl.
- Cách xử lý robots.txt.
- User-agent Googlebot Smartphone.
- Bật Rendering JavaScript cho website React, Vue (cần license).
Theo FAQ của hãng, máy chủ chậm hay báo lỗi 503 thì giảm tốc độ xuống 1 URL mỗi giây.
3.5. Kết nối Search Console, GA4 và PageSpeed Insights
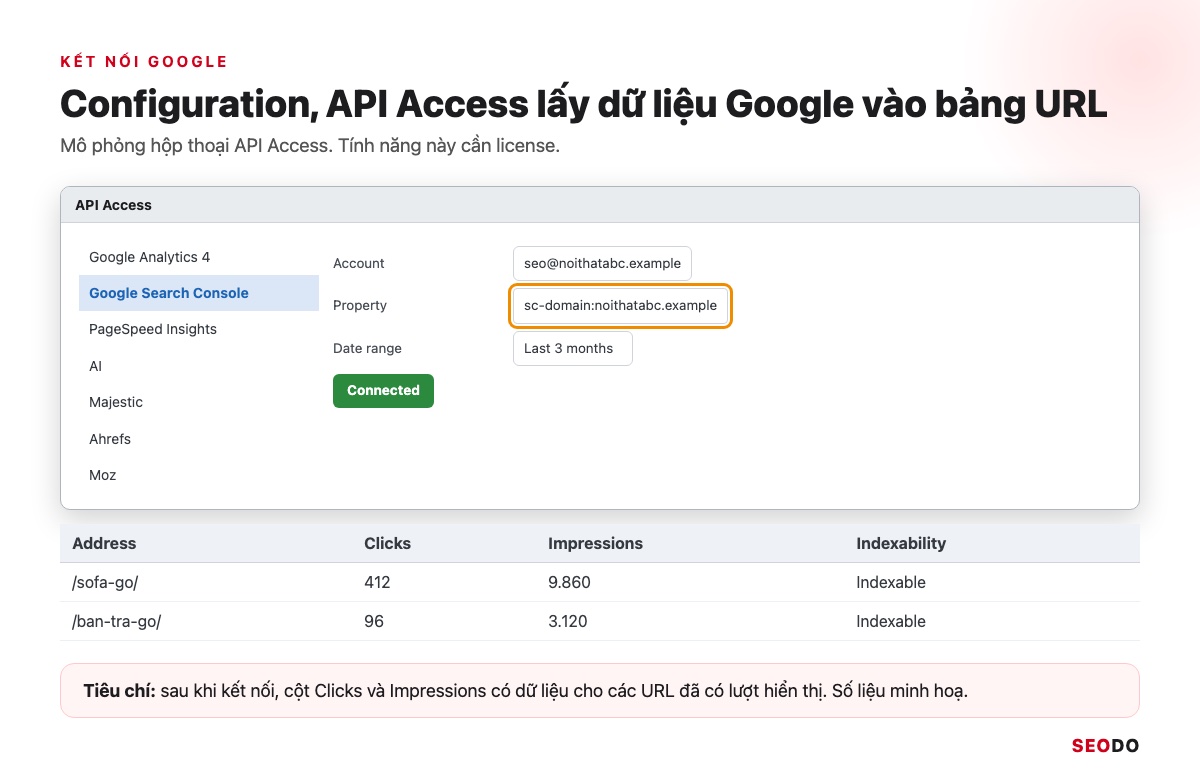
Configuration, API Access (cần license) kéo dữ liệu từ 3 nguồn vào cùng bảng URL:
- Lượt nhấp, lượt hiển thị từ Google Search Console.
- Số phiên từ GA4.
- Chỉ số từ PageSpeed Insights.
Kết nối đúng thì cột Clicks và Impressions có dữ liệu. URL có lượt hiển thị mà crawl không thấy là trang mồ côi.
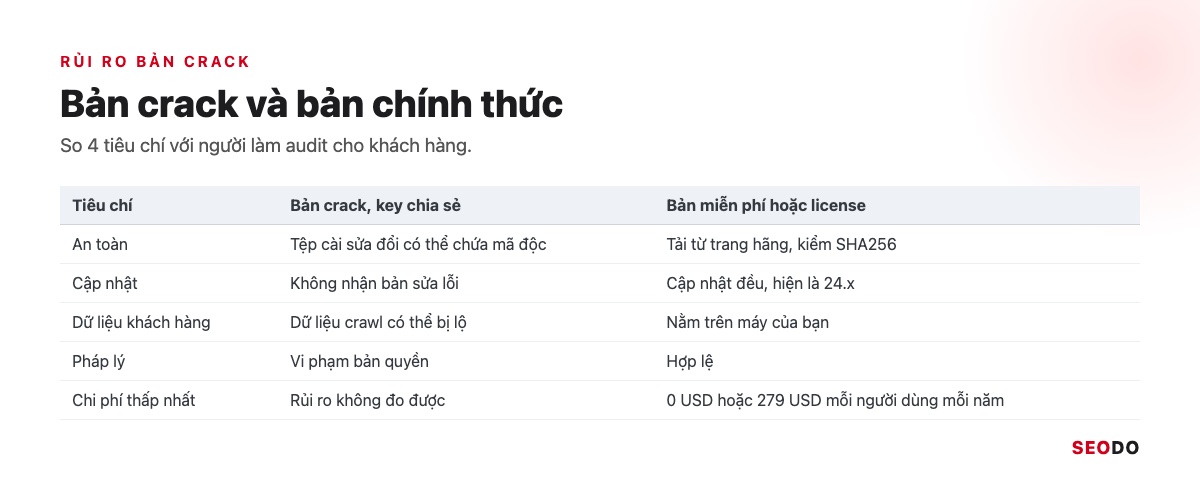
3.6. Rủi ro khi dùng bản crack Screaming Frog
Tệp cài bị sửa đổi có 4 rủi ro:
- Có thể chứa mã độc.
- Không nhận bản sửa lỗi.
- Vi phạm bản quyền.
- Làm lộ dữ liệu crawl của khách hàng.
Lựa chọn hợp lệ là bản miễn phí 0 USD cho website dưới 500 URL, hoặc 279 USD mỗi năm cho người làm audit chính.
4. Cách đọc giao diện Screaming Frog SEO Spider
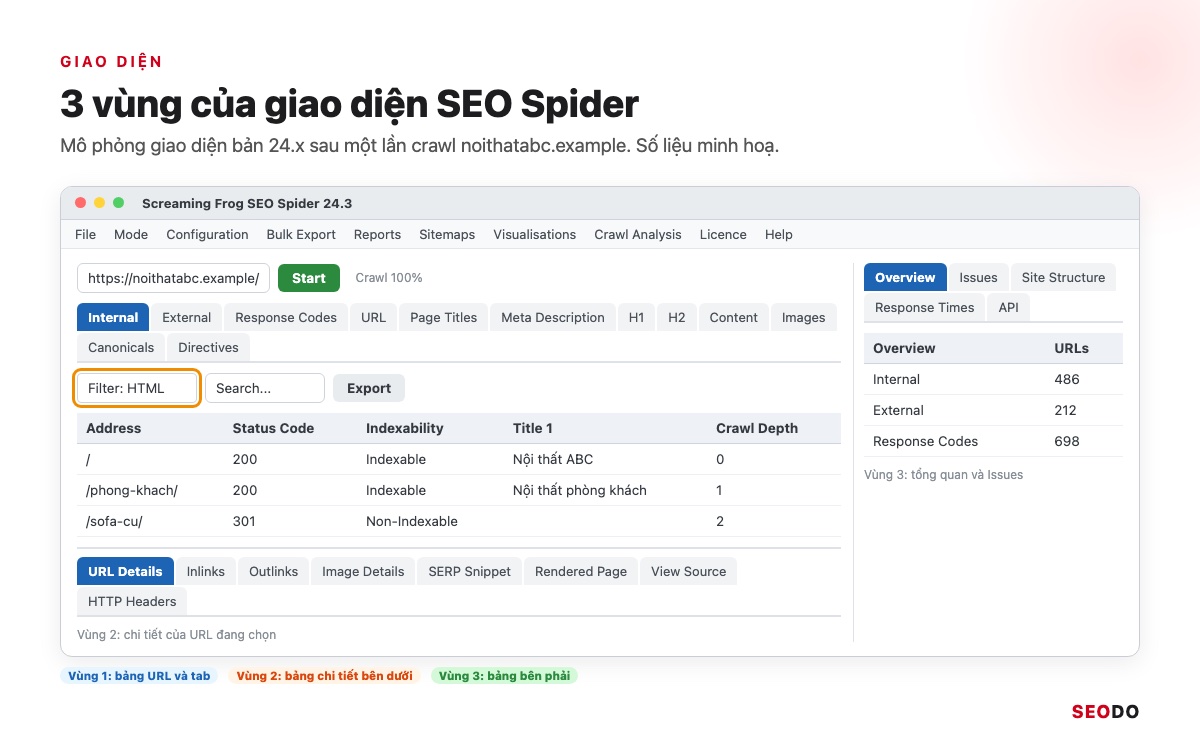
Giao diện có 3 vùng, biết vùng nào chứa gì thì bạn tìm được lỗi, trang nguồn của lỗi và mức ưu tiên.
Giao diện chia 3 vùng: bảng URL với các tab ở trên, bảng chi tiết của URL đang chọn ở dưới và bảng Overview, Issues bên phải.
Giao diện SEO Spider chia 3 vùng:
- Bảng URL chính với các tab ở trên.
- Bảng chi tiết ở dưới.
- Bảng tổng quan bên phải.
Tên tab giữ nguyên tiếng Anh như trong phần mềm.
4.1. Các tab chính ở bảng trên
Bảng trên có gần 20 tab, từ Internal, Response Codes, Page Titles tới Structured Data, mỗi tab có ô Filter để lọc theo loại vấn đề. Sáu tab sau được dùng cho các việc audit ở phần 5.
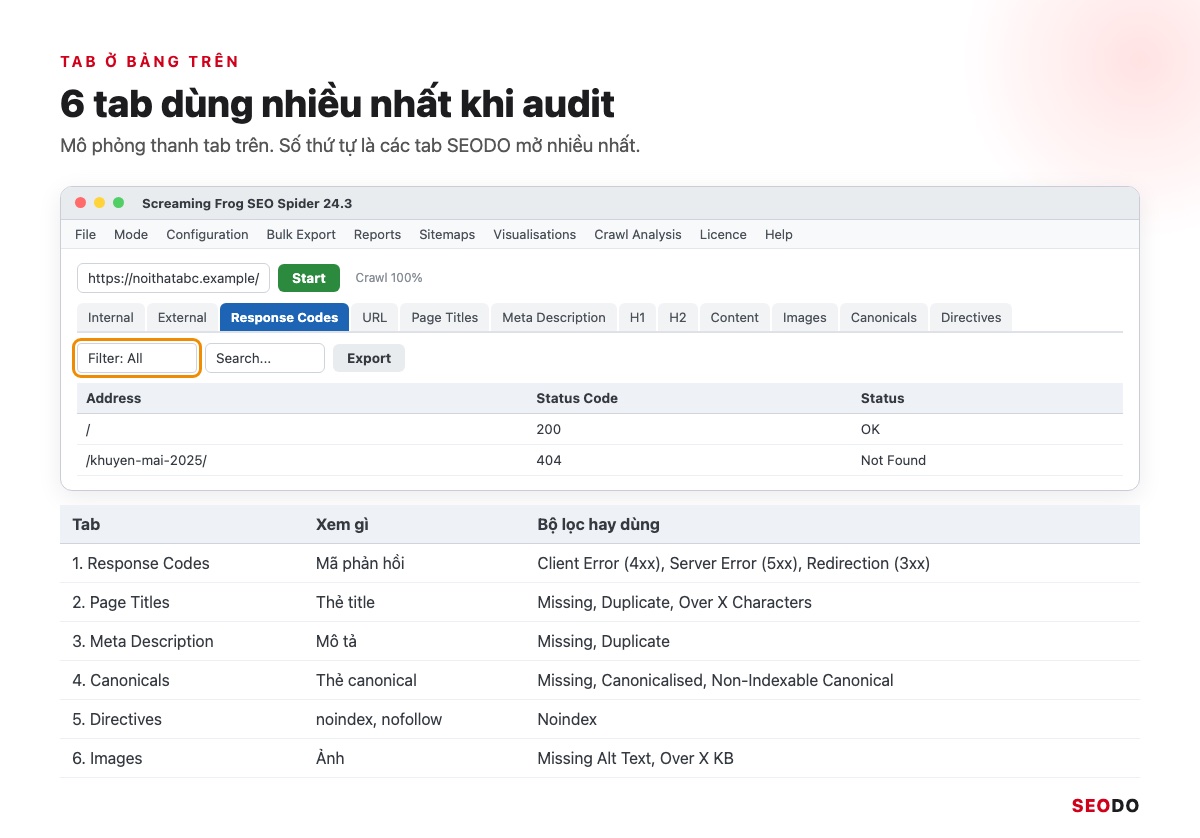
| Tab | Xem gì | Bộ lọc hay dùng |
| Response Codes | Mã phản hồi | Client Error (4xx), Server Error (5xx), Redirection (3xx) |
| Page Titles | Thẻ title | Missing, Duplicate, Over X Characters |
| Meta Description | Mô tả | Missing, Duplicate |
| Canonicals | Thẻ canonical | Missing, Canonicalised, Non-Indexable Canonical |
| Directives | Chỉ thị robots | Noindex, Nofollow |
| Images | Ảnh | Missing Alt Text, Over X KB |
4.2. Bảng chi tiết ở dưới: Inlinks, Outlinks, Rendered Page
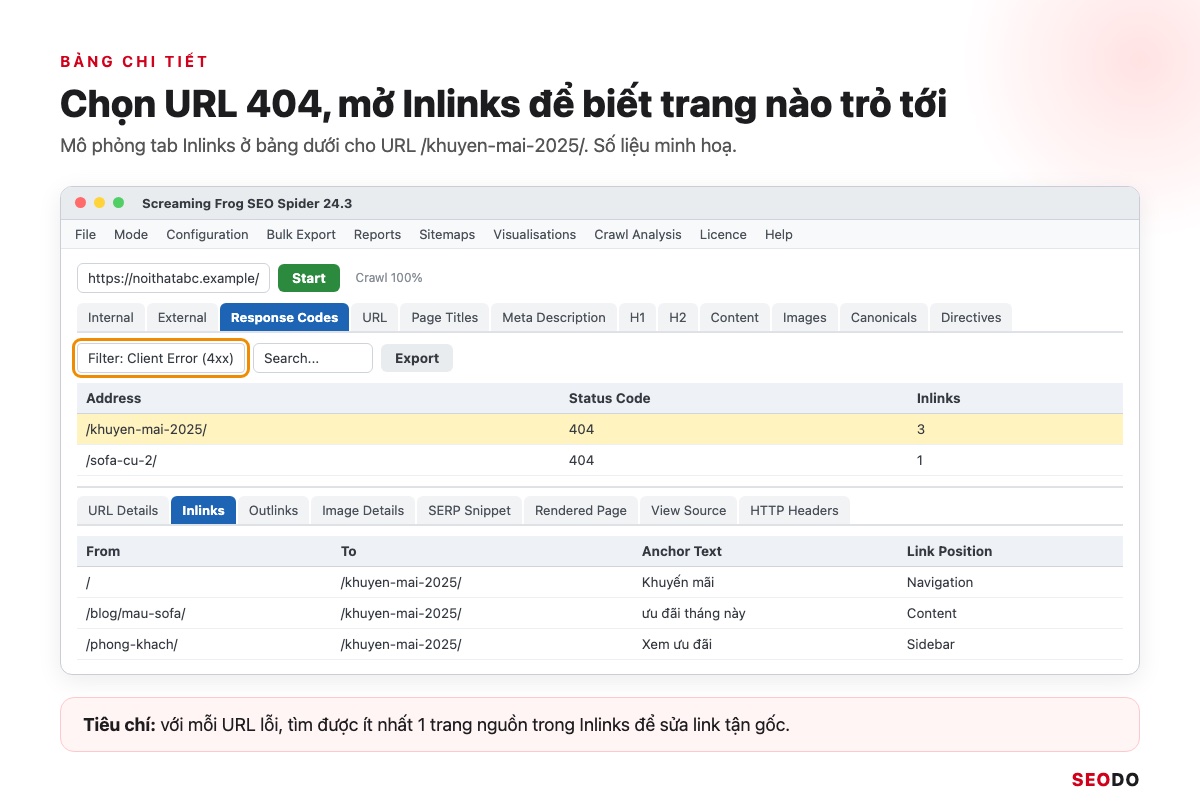
Khi chọn 1 URL, bảng dưới hiện 6 tab:
- Inlinks (trang nào trỏ tới URL này).
- Outlinks.
- SERP Snippet.
- Rendered Page.
- View Source.
- HTTP Headers.
Với mỗi URL lỗi, bạn tìm ít nhất 1 trang nguồn trong Inlinks để sửa link tận gốc, đừng chỉ đặt chuyển hướng.
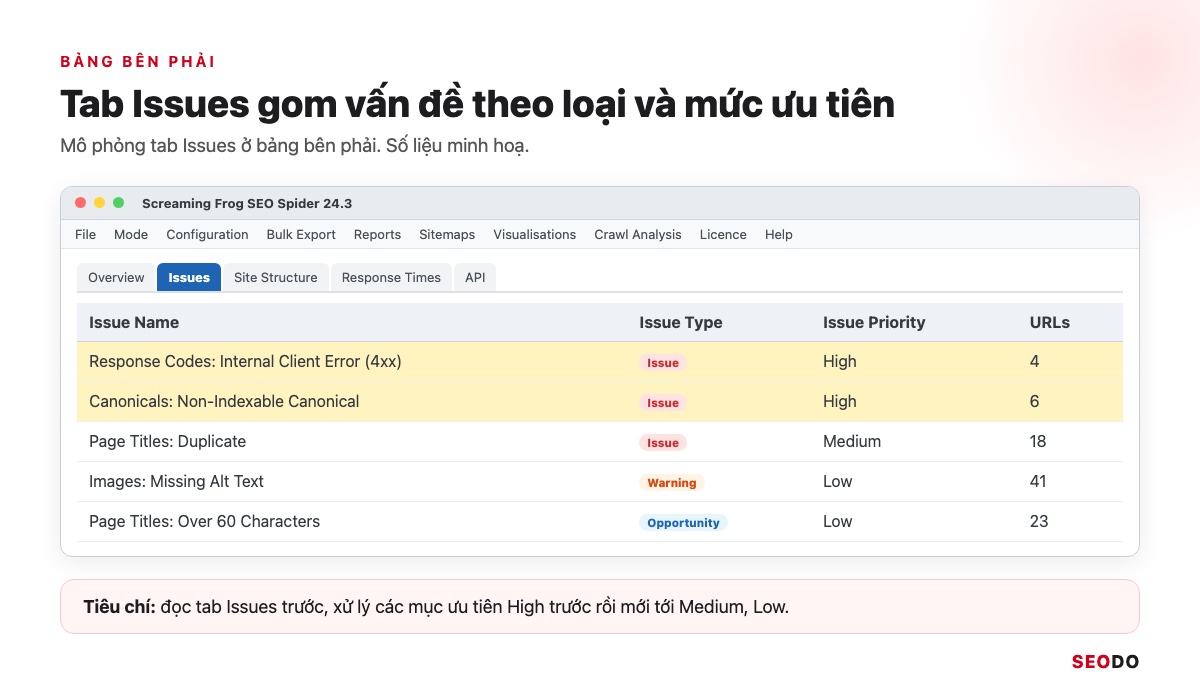
4.3. Bảng bên phải: Overview, Issues, Site Structure
Bảng bên phải có 3 phần:
- Overview: đếm URL theo tab và bộ lọc.
- Issues: gom vấn đề theo loại kèm mức ưu tiên High, Medium, Low.
- Site Structure: cho độ sâu crawl.
Sau mỗi lần crawl, tôi mở Issues đầu tiên và xử lý mục High trước.
4.4. Lọc, tìm kiếm và xuất dữ liệu
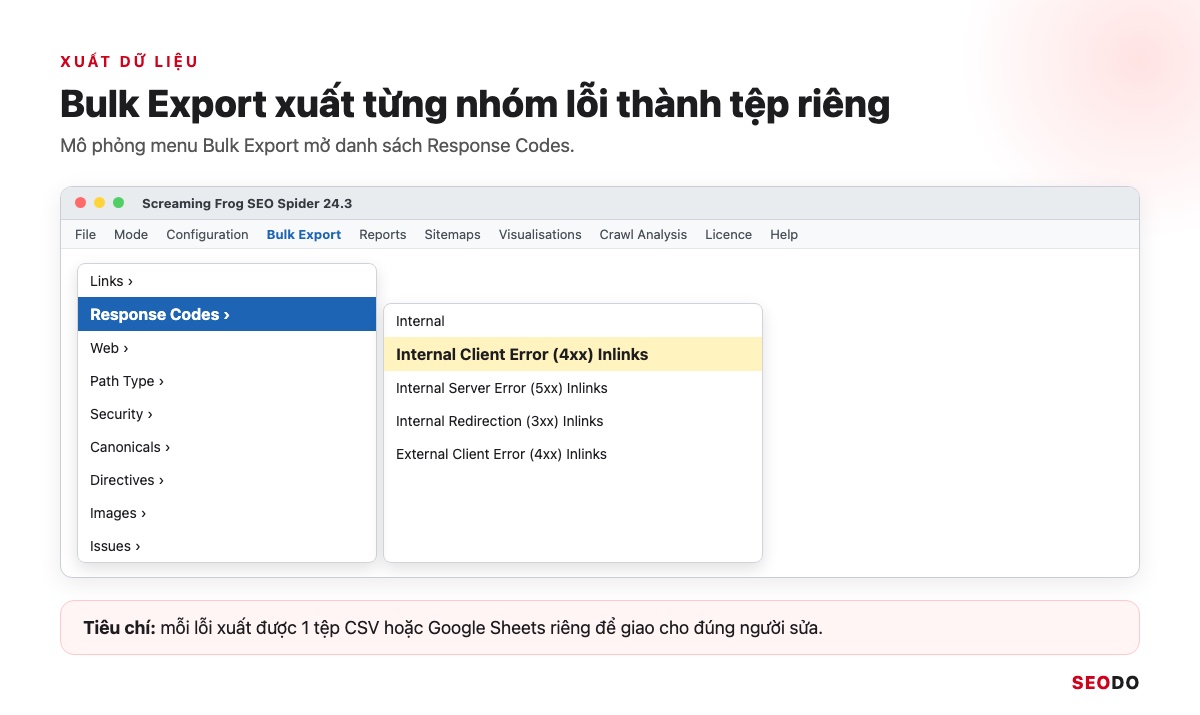
Mỗi tab có nút Export, còn menu Bulk Export xuất theo nhóm vấn đề kèm trang nguồn. Tiêu chí là mỗi lỗi có 1 tệp CSV hoặc Google Sheets riêng để giao đúng người sửa.
5. Cách dùng Screaming Frog audit website: 12 việc xếp theo mức ưu tiên
Mười hai việc dưới đây được xếp theo mức ảnh hưởng, nên bạn biết lỗi nào phải sửa trong tuần và lỗi nào để theo đợt.
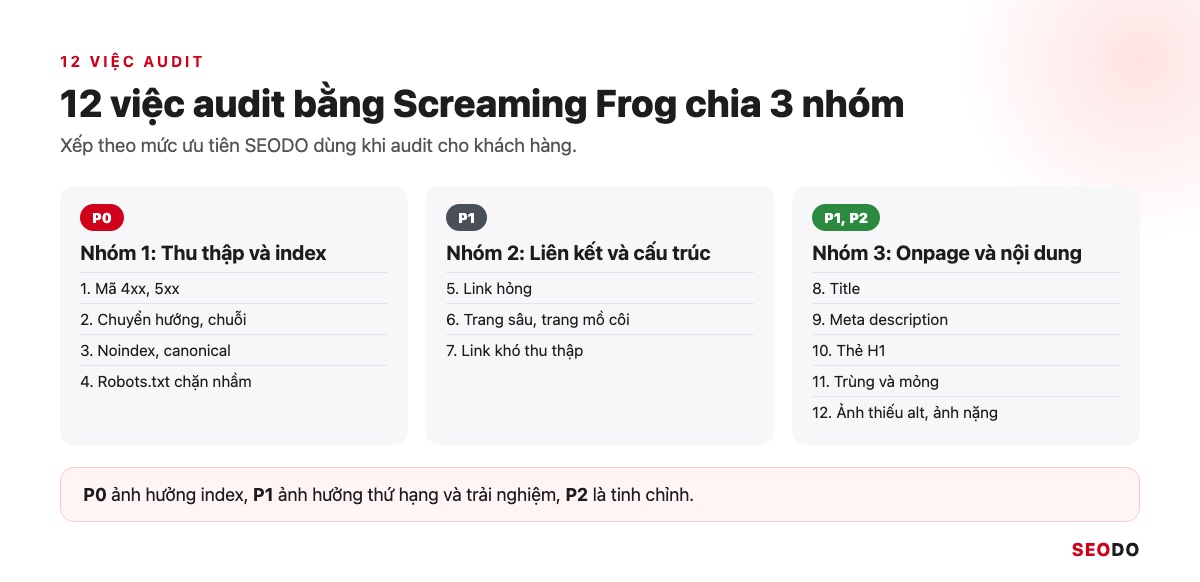
12 việc gồm thu thập và index (P0), liên kết và cấu trúc (P1), onpage và nội dung (P1, P2). P0 ảnh hưởng index nên luôn làm trước.
Cách dùng Screaming Frog để audit là đi lần lượt 12 việc, mỗi việc có tab, bộ lọc, tiêu chuẩn đạt và mức ưu tiên. Ba mức tôi dùng là:
- P0: ảnh hưởng index.
- P1: ảnh hưởng thứ hạng và trải nghiệm.
- P2: tinh chỉnh.
5.1. Nhóm 1: Thu thập và lập chỉ mục (4 việc)
Nhóm này gồm những lỗi khiến Google không thấy trang hoặc không đưa trang vào chỉ mục, nên cả 4 việc đều là P0. Nắm cơ chế Google index trước sẽ giúp bạn hiểu vì sao.
1. Kiểm tra mã phản hồi 4xx, 5xx
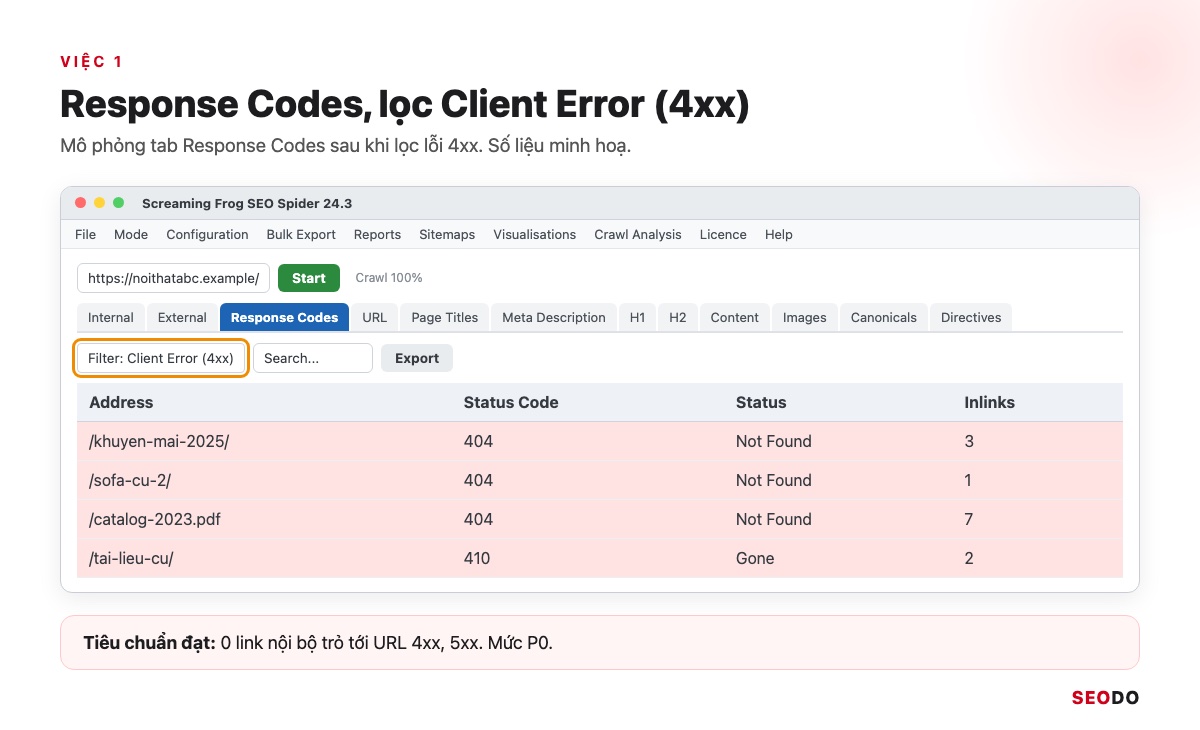
Mở tab Response Codes, lọc Client Error (4xx) và Server Error (5xx), rồi xem Inlinks của từng URL để biết trang nguồn. Tiêu chuẩn đạt là 0 link nội bộ trỏ tới URL 4xx, 5xx. Lỗi hay gặp là bài đã xoá vẫn nằm trong menu. Cách xử lý lỗi 404 đúng là sửa link nguồn hoặc chuyển hướng về trang gần nghĩa.
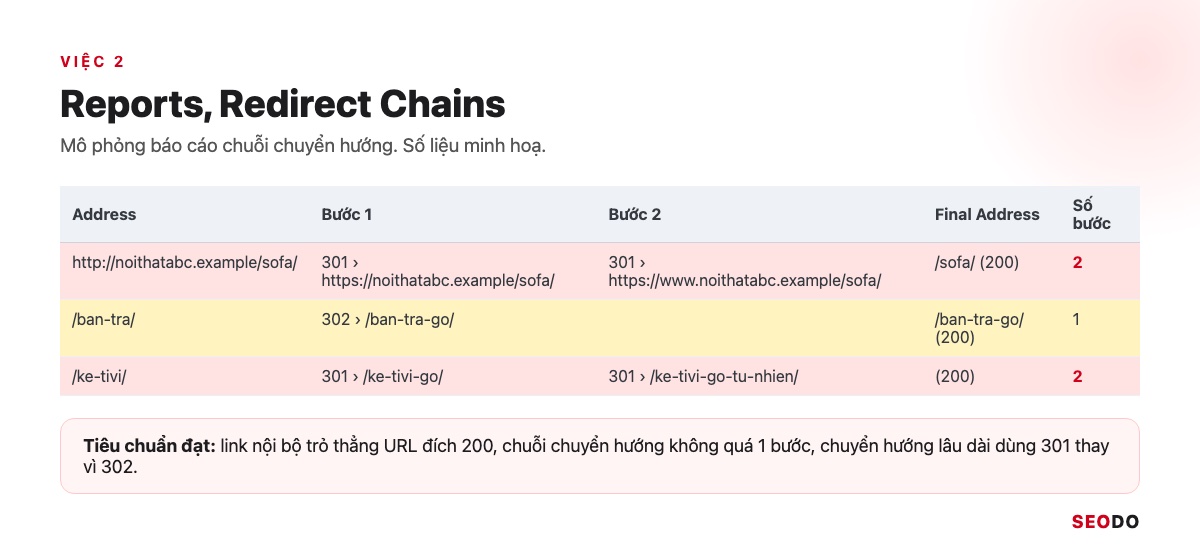
2. Rà chuyển hướng, chuỗi và vòng lặp chuyển hướng
Lọc Redirection (3xx) rồi mở Reports, Redirect Chains xem từng bước. Tiêu chuẩn đạt là link nội bộ trỏ thẳng URL 200, chuỗi không quá 1 bước. Lỗi hay gặp là http sang https rồi sang www thành 2 bước, và chuyển hướng lâu dài dùng 302 chứ không dùng redirect 301.
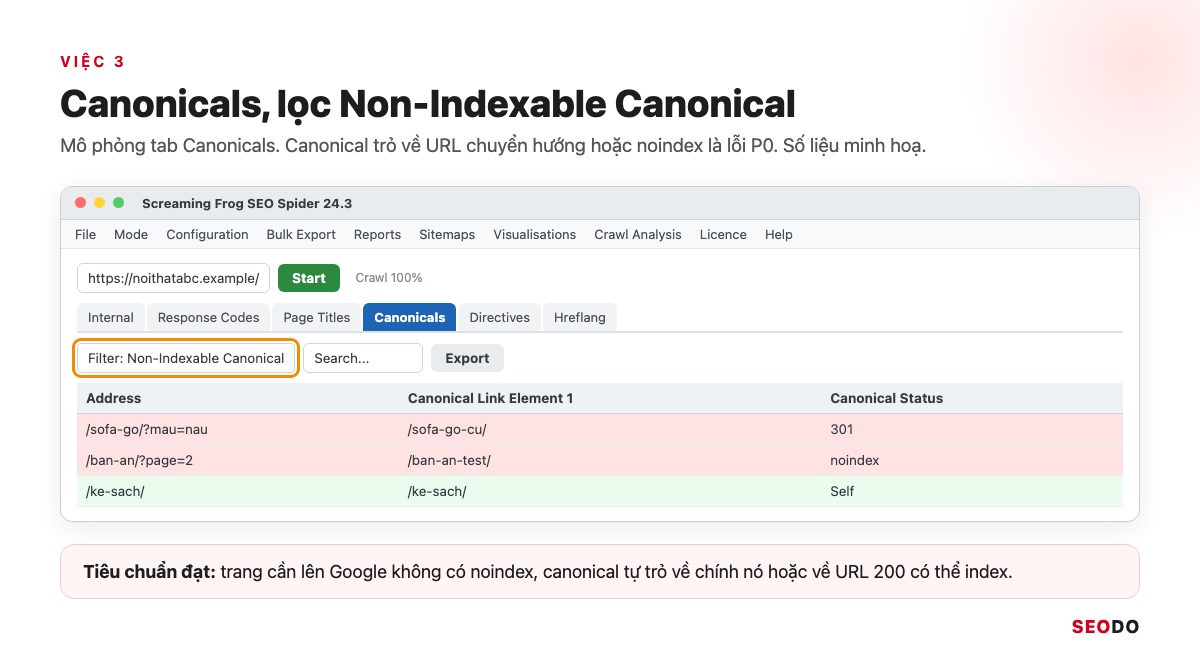
3. Kiểm tra noindex, canonical và chỉ thị
Tab Directives lọc Noindex, tab Canonicals lọc Non-Indexable Canonical. Tiêu chuẩn đạt là trang cần lên Google không có noindex và thẻ canonical trỏ về URL 200 có thể index. Lỗi hay gặp là noindex sót lại từ bản staging và canonical trỏ về URL đã chuyển hướng.
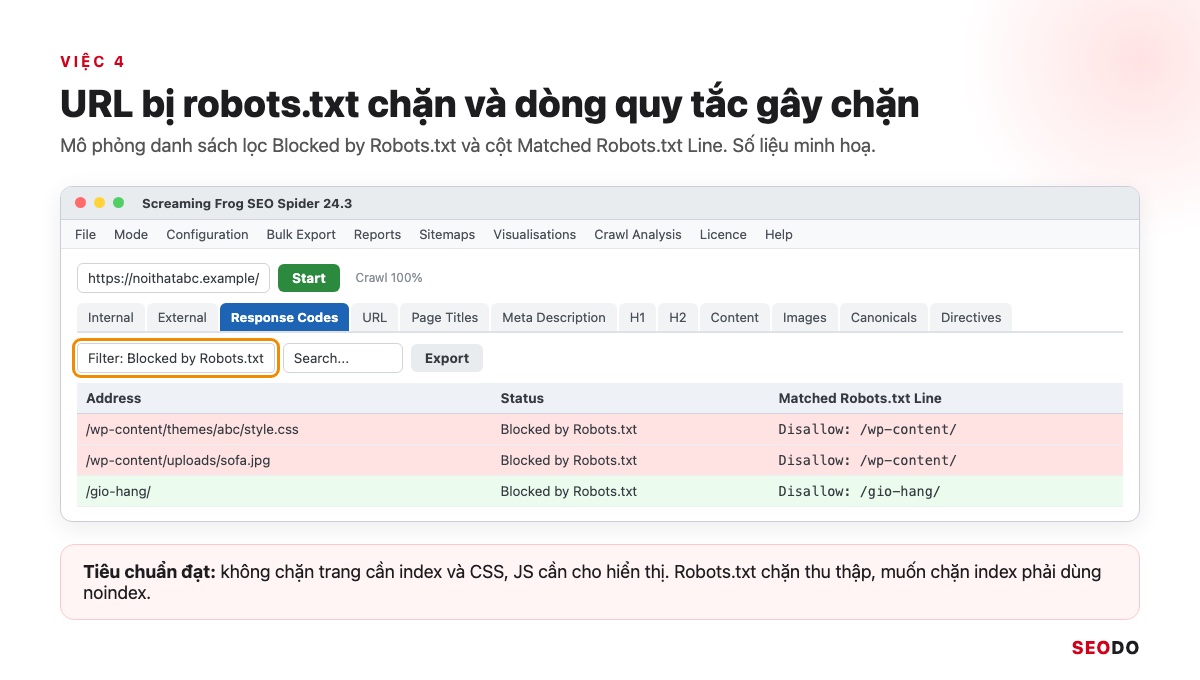
4. Kiểm tra URL bị robots.txt chặn nhầm
Lọc Blocked by Robots.txt và đọc cột Matched Robots.txt Line để biết quy tắc nào gây chặn. Tiêu chuẩn đạt là không chặn trang cần index và CSS, JS cần cho hiển thị. Theo Google, robots.txt chặn thu thập chứ không chặn index, muốn chặn index phải dùng noindex. Lỗi hay gặp là Disallow cả thư mục /wp-content/.
5.2. Nhóm 2: Liên kết và cấu trúc website (3 việc)
Nhóm này gồm lỗi khiến Google và người đọc khó đi tới trang quan trọng, cách sửa dựa trên việc xây internal link theo cụm chủ đề.
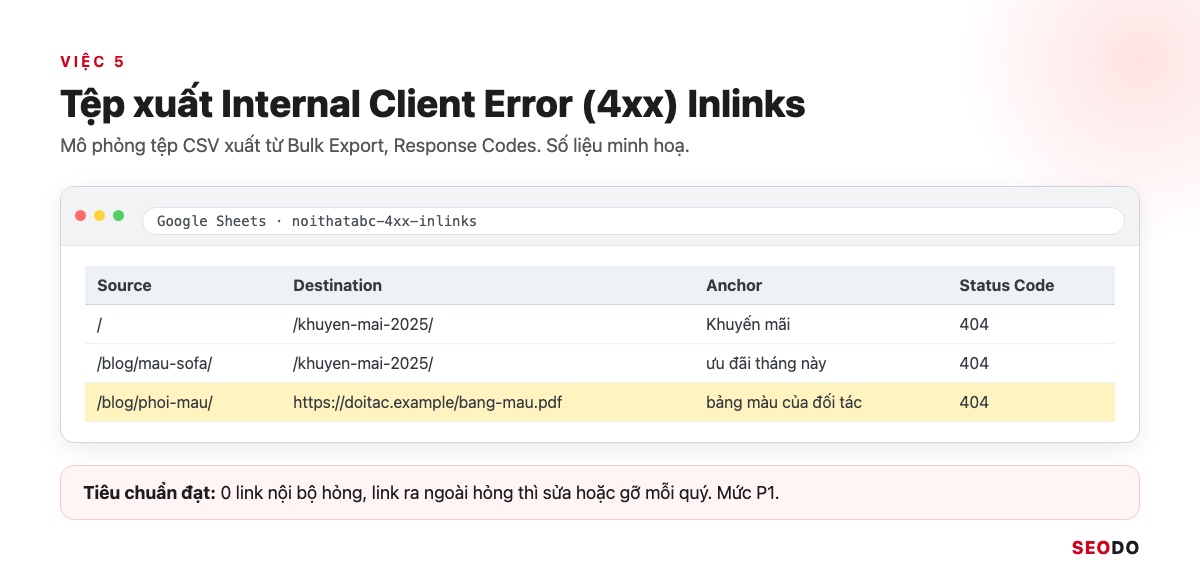
5. Tìm link nội bộ hỏng và link ra ngoài hỏng
Vào Bulk Export, Response Codes, xuất Internal và External Client Error (4xx) Inlinks. Tệp có đủ trang nguồn, trang đích và anchor. Tiêu chuẩn đạt là 0 link nội bộ hỏng, còn link ra ngoài hỏng thì rà mỗi quý 1 lần.
6. Tìm trang quá sâu và trang mồ côi
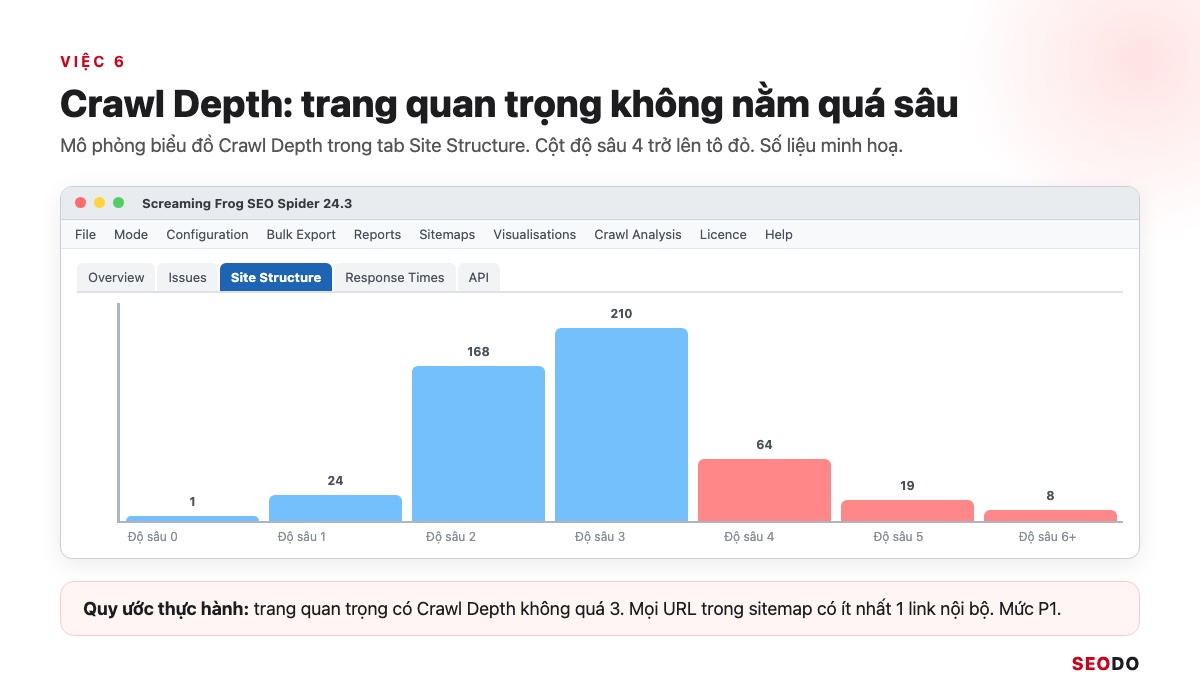
Xem cột Crawl Depth ở tab Internal, còn trang mồ côi thì so URL từ sitemap hoặc Search Console với kết quả crawl qua Crawl Analysis. Tiêu chuẩn đạt theo quy ước thực hành là trang quan trọng có Crawl Depth không quá 3 và mọi URL trong sitemap có ít nhất 1 link nội bộ.
7. Tìm link Google khó thu thập
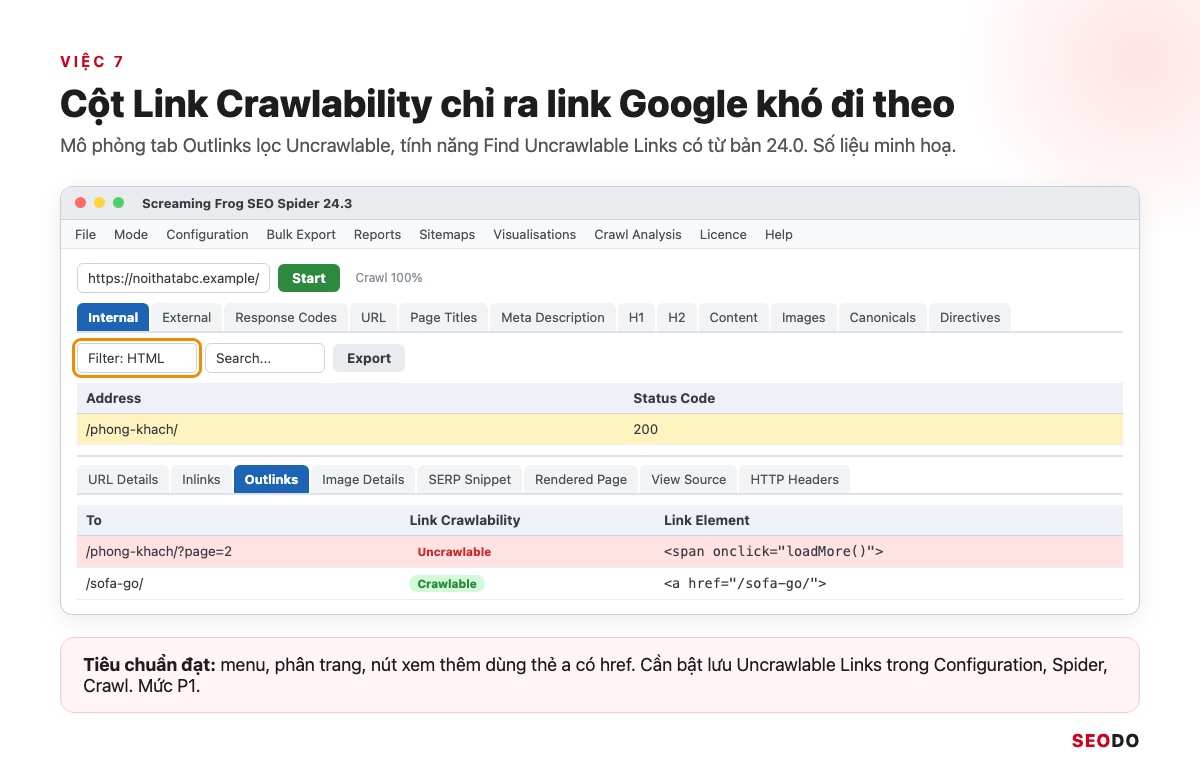
Từ bản 24.0, Find Uncrawlable Links thêm cột Link Crawlability ở tab Outlinks lọc link Uncrawlable. Theo tài liệu Make your links crawlable, Google thu thập ổn định link dạng thẻ a có href. Vì vậy menu, phân trang, nút xem thêm phải dùng thẻ a có href, không dùng onclick.
5.3. Nhóm 3: Onpage và nội dung (5 việc)
Nhóm cuối ảnh hưởng tới cách Google hiểu trang và việc người tìm có bấm vào kết quả hay không. Checklist SEO Onpage đủ hơn, 5 việc sau chỉ gồm những gì Screaming Frog đo được.
8. Kiểm tra title thiếu, trùng, quá dài
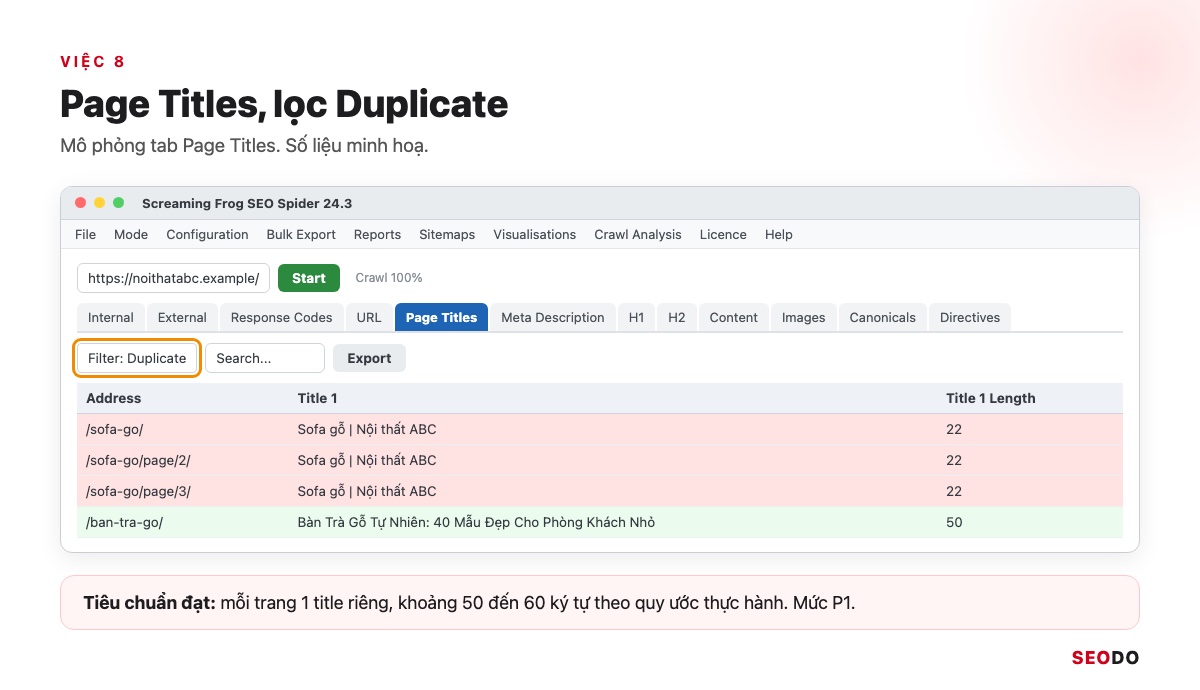
Tab Page Titles lọc Missing, Duplicate, Over X Characters, cột Title 1 Length cho số ký tự. Tiêu chuẩn đạt là mỗi trang 1 meta title riêng khoảng 50 đến 60 ký tự theo quy ước thực hành, vì Google chỉ cắt khi hiển thị theo chiều rộng. Lỗi hay gặp là title trùng giữa các trang phân trang.
9. Kiểm tra meta description thiếu, trùng
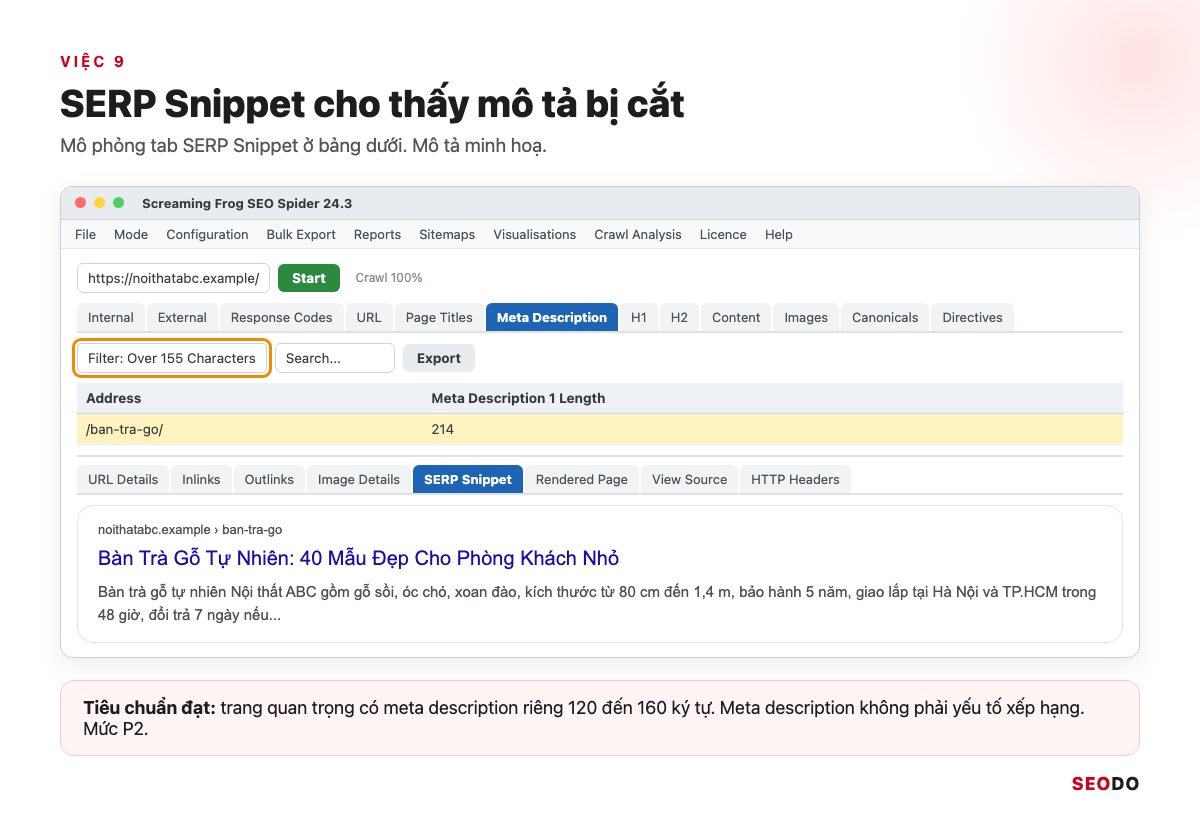
Tab Meta Description lọc Missing, Duplicate, rồi mở SERP Snippet ở bảng dưới để thấy mô tả bị cắt ra sao. Tiêu chuẩn đạt là trang chính có meta description riêng 120 đến 160 ký tự. Đây không phải yếu tố xếp hạng nhưng ảnh hưởng tỷ lệ nhấp, nên xếp mức P2.
10. Kiểm tra thẻ H1
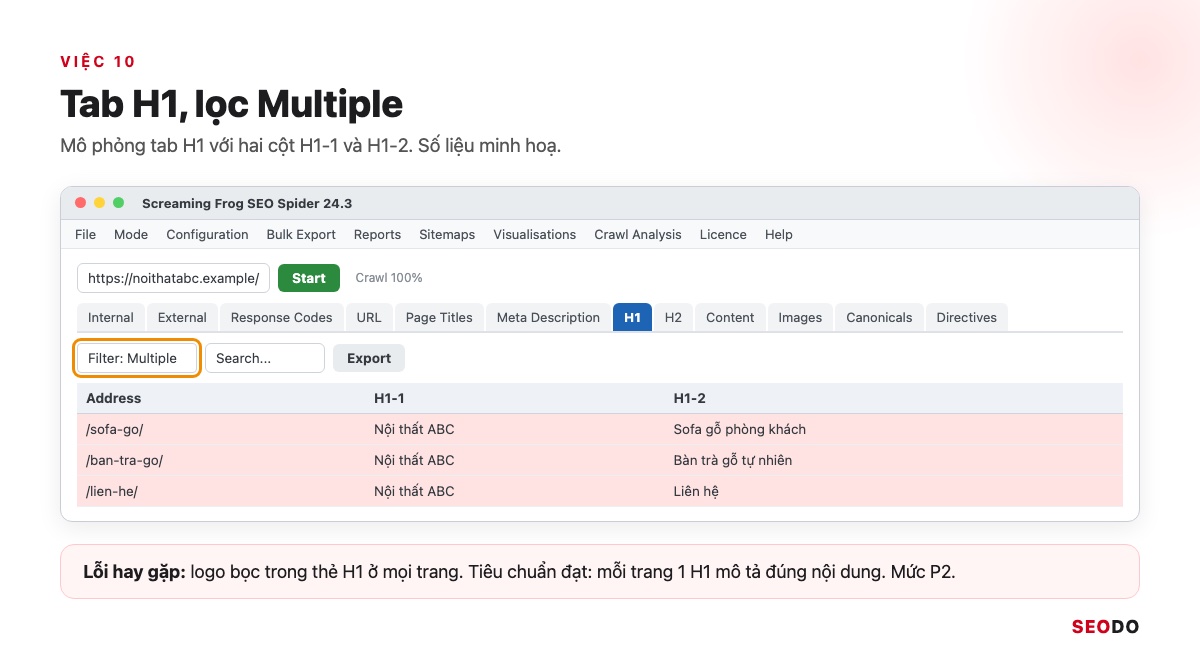
Tab H1 lọc Missing, Duplicate và Multiple. Tiêu chuẩn đạt là mỗi trang có 1 H1 mô tả đúng nội dung, không trùng trang khác. Lỗi hay gặp là logo bọc trong thẻ H1 ở mọi trang.
11. Tìm nội dung trùng và nội dung mỏng
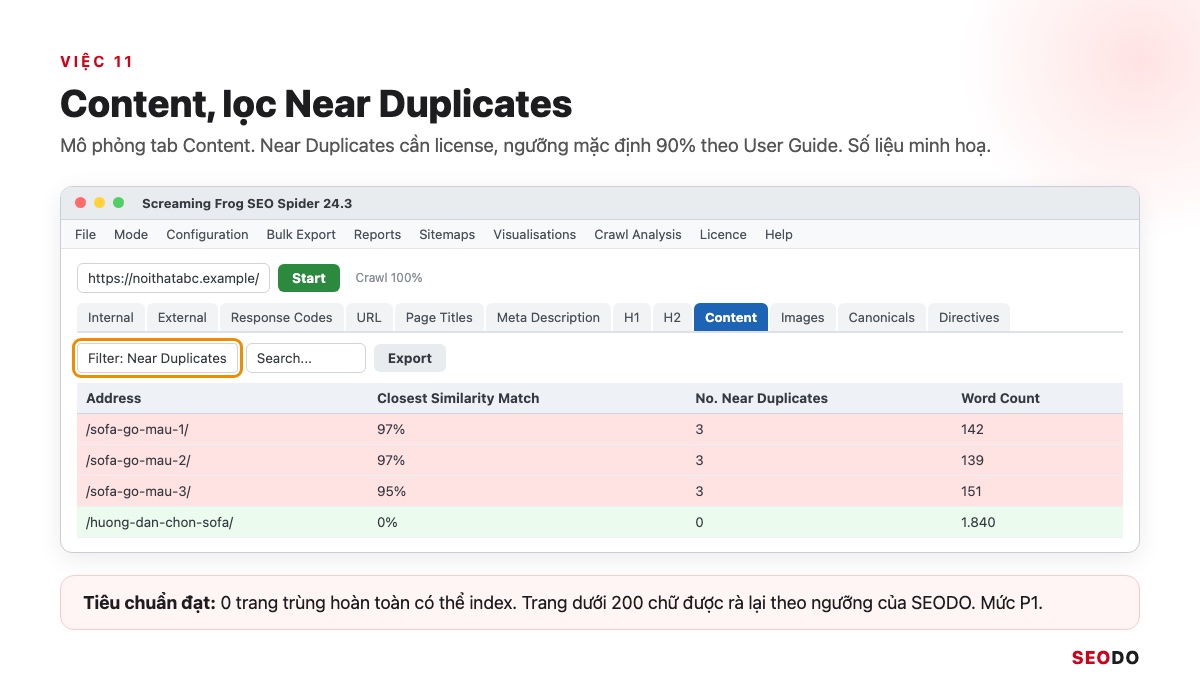
Exact Duplicates có ở bản miễn phí, còn Near Duplicates cần license và dùng ngưỡng tương đồng mặc định 90%. Nội dung mỏng thì sắp cột Word Count tăng dần ở tab Internal. Theo ngưỡng rà của SEODO, trang dưới 200 chữ cần xem lại có đáp ứng search intent không.
12. Kiểm tra ảnh thiếu alt và ảnh nặng
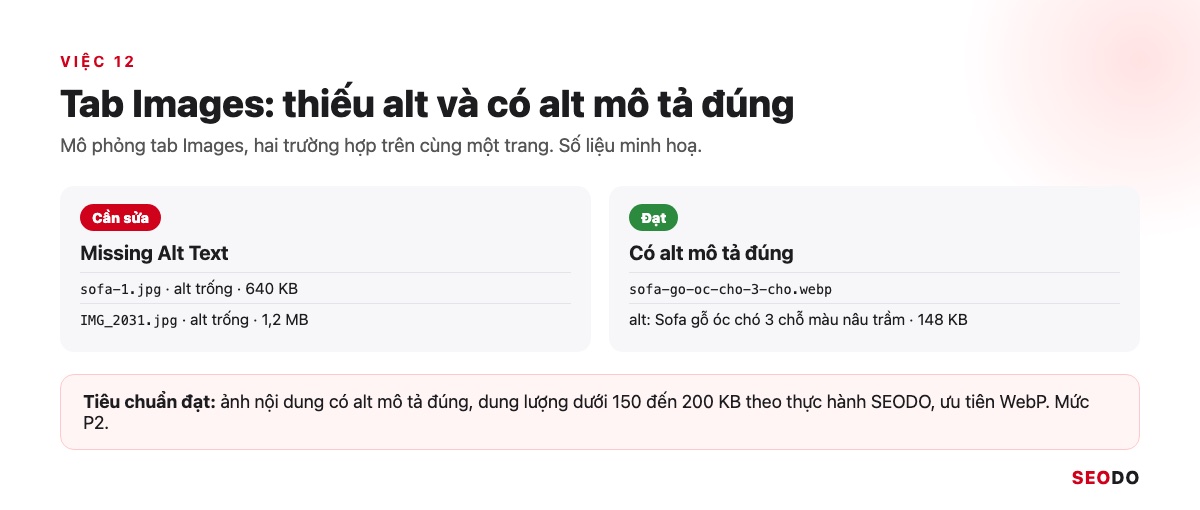
Tab Images lọc Missing Alt Text và Over X KB. Tiêu chuẩn đạt là ảnh có alt text mô tả đúng, dung lượng dưới 150 đến 200 KB theo thực hành SEODO. Lỗi hay gặp là ảnh tải thẳng từ điện thoại hơn 1 MB.
5.4. Tóm tắt 12 việc audit bằng Screaming Frog
Tiêu chí bắt buộc là xử lý hết 4 việc P0 trước khi làm P1, P2, vì trang chưa được index đúng thì chỉnh title hay alt cũng chưa mang lại gì. Lịch sửa cho cả website nằm trong checklist SEO audit đầy đủ của SEODO.
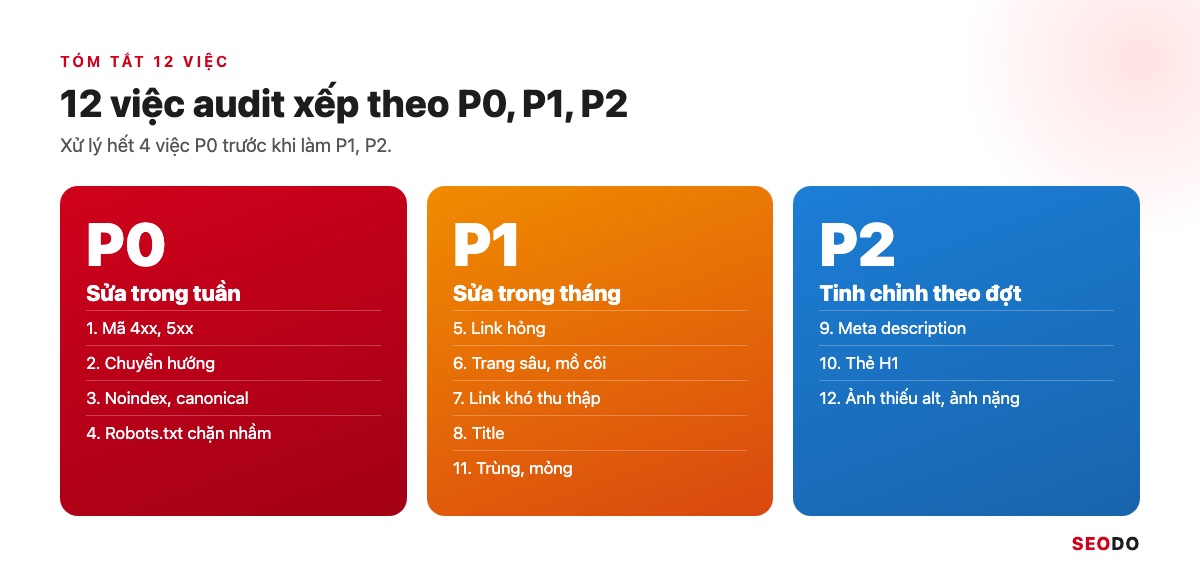
| Việc | Tab và bộ lọc | Tiêu chuẩn đạt | Mức |
| 1. Mã 4xx, 5xx | Response Codes, Client Error, Server Error | 0 link nội bộ tới URL lỗi | P0 |
| 2. Chuyển hướng | Reports, Redirect Chains | Không quá 1 bước | P0 |
| 3. Noindex, canonical | Directives, Canonicals | Canonical về URL 200 có thể index | P0 |
| 4. Robots.txt | Response Codes, Blocked by Robots.txt | Không chặn trang cần index | P0 |
| 5. Link hỏng | Bulk Export, Response Codes | 0 link nội bộ hỏng | P1 |
| 6. Trang sâu, mồ côi | Crawl Depth, Crawl Analysis | Crawl Depth không quá 3 | P1 |
| 7. Link khó thu thập | Outlinks, Link Crawlability | Thẻ a có href | P1 |
| 8. Title | Page Titles, Duplicate | 50 đến 60 ký tự, không trùng | P1 |
| 9. Meta description | Meta Description, Missing | 120 đến 160 ký tự | P2 |
| 10. Thẻ H1 | H1, Multiple | 1 H1 mỗi trang | P2 |
| 11. Trùng, mỏng | Content, Near Duplicates | 0 trang trùng hoàn toàn | P1 |
| 12. Ảnh | Images, Missing Alt Text | Có alt, dưới 200 KB | P2 |
6. Cách crawl website lớn, website thương mại điện tử và trang cần đăng nhập bằng Screaming Frog
Bốn cấu hình dưới đây giúp bạn crawl được website hàng chục nghìn URL mà không treo máy và không làm hỏng dữ liệu.
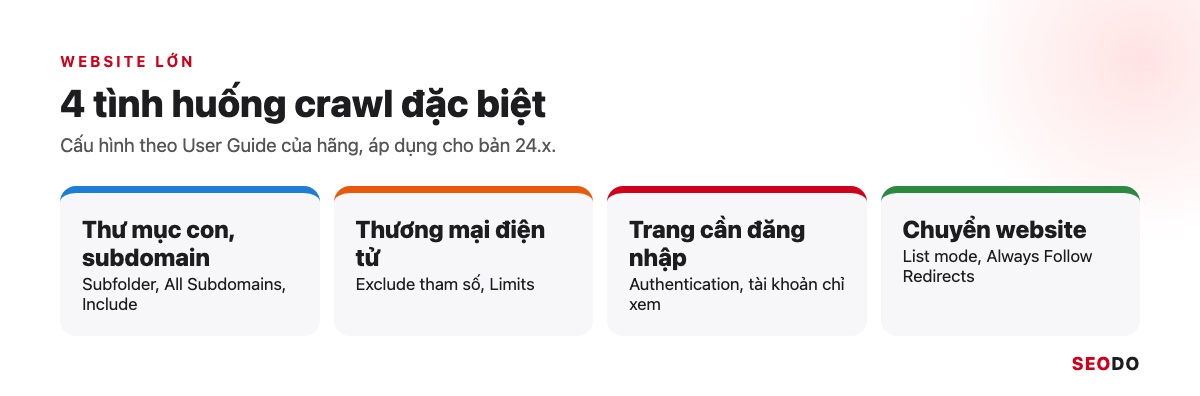
Website lớn thì crawl theo thư mục, loại trừ tham số rác bằng Exclude và giới hạn độ sâu. Trang cần đăng nhập dùng tài khoản chỉ xem, chuyển website thì kiểm tra bằng List mode.
Với website lớn, bạn không crawl tất cả trong một lần mà làm 3 việc:
- Chia theo thư mục.
- Loại trừ tham số rác.
- Giới hạn độ sâu.
Các cấu hình Include, Exclude, Limits và Authentication đều nằm trong menu Configuration, mô tả chi tiết trong User Guide Configuration của hãng.
6.1. Crawl một thư mục con hoặc một nhóm subdomain
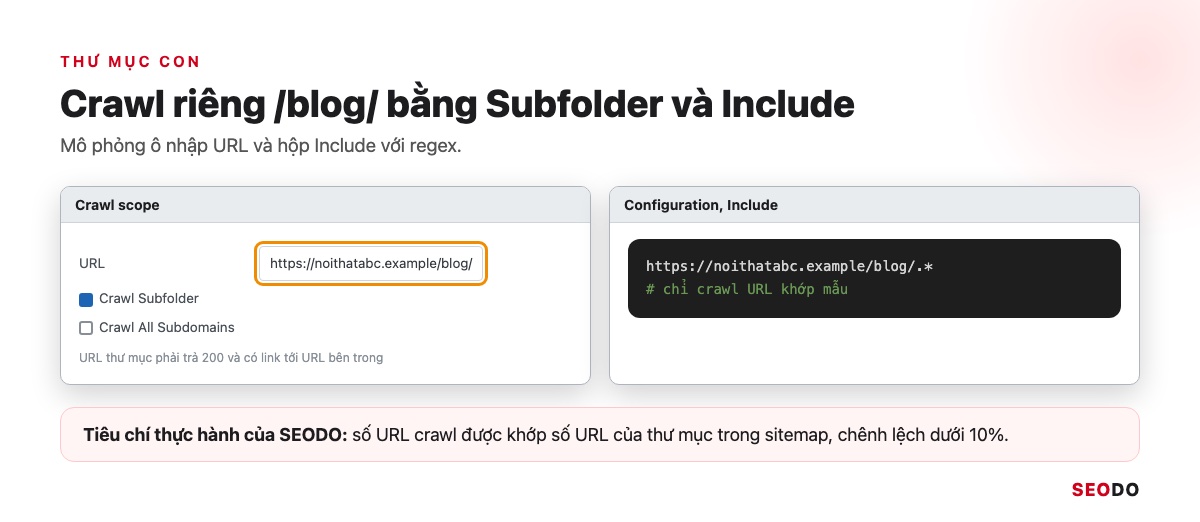
Chọn Crawl Subfolder khi chỉ cần một thư mục, ví dụ /blog/. User Guide yêu cầu URL thư mục phải trả 200 và có link ra URL bên trong. Chọn All Subdomains khi website có nhiều subdomain, kết hợp Include bằng regex để giữ đúng phạm vi. Tiêu chí thực hành của SEODO là số URL crawl được khớp với số URL của thư mục trong sitemap, chênh lệch dưới 10%.
6.2. Crawl website thương mại điện tử nhiều tham số lọc
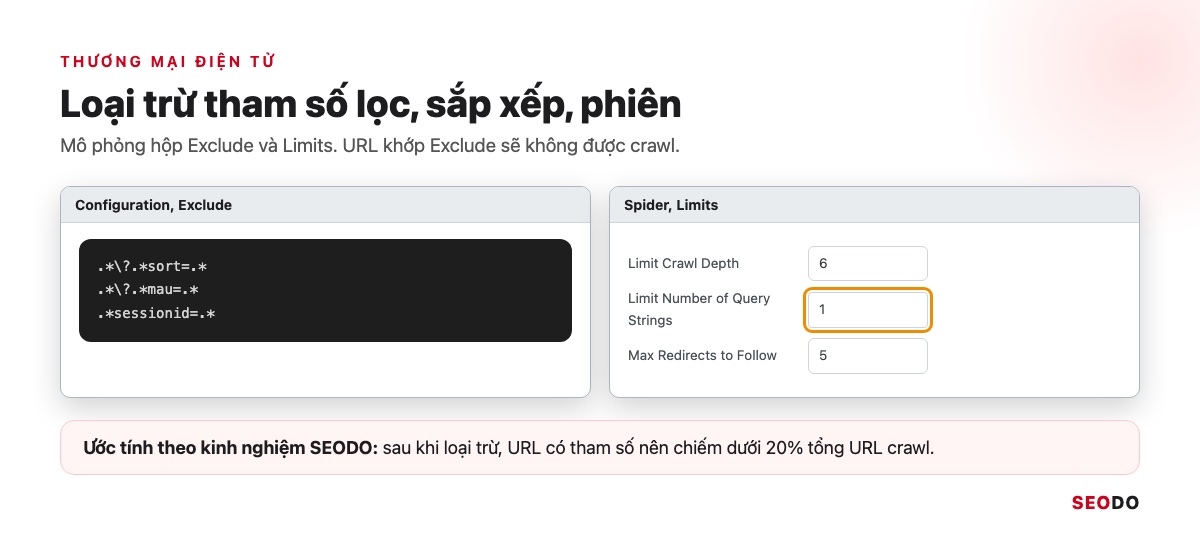
Website bán hàng sinh ra rất nhiều URL từ bộ lọc màu, giá, sắp xếp và mã phiên. Bạn xử lý theo 3 bước:
- Loại tham số bằng Configuration, Exclude.
- Đặt Limit Number of Query Strings trong Spider, Limits.
- Crawl theo từng danh mục.
Theo kinh nghiệm SEODO, sau khi loại trừ, URL có tham số nên chiếm dưới 20% tổng URL crawl. Website WordPress dùng plugin Rank Math thì kiểm tra thêm canonical của trang lọc đã trỏ về danh mục gốc chưa.
6.3. Crawl trang cần đăng nhập và bản staging
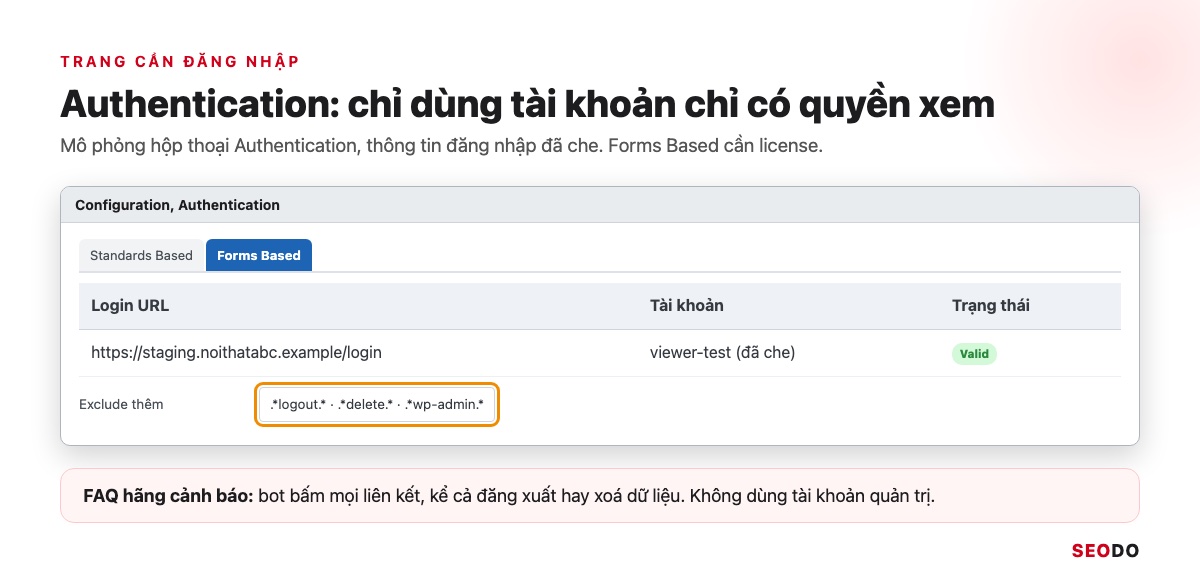
Standards Based Authentication dùng cho trang hỏi mật khẩu kiểu hộp thoại trình duyệt, còn Forms Based Authentication (cần license) dùng cho trang đăng nhập bằng form. FAQ của hãng cảnh báo SEO Spider bấm mọi liên kết trên trang, kể cả link đăng xuất, tạo bài hay xoá dữ liệu. Tiêu chí bắt buộc là dùng tài khoản chỉ có quyền xem, không dùng tài khoản quản trị. Loại trừ mọi URL chứa logout, delete.
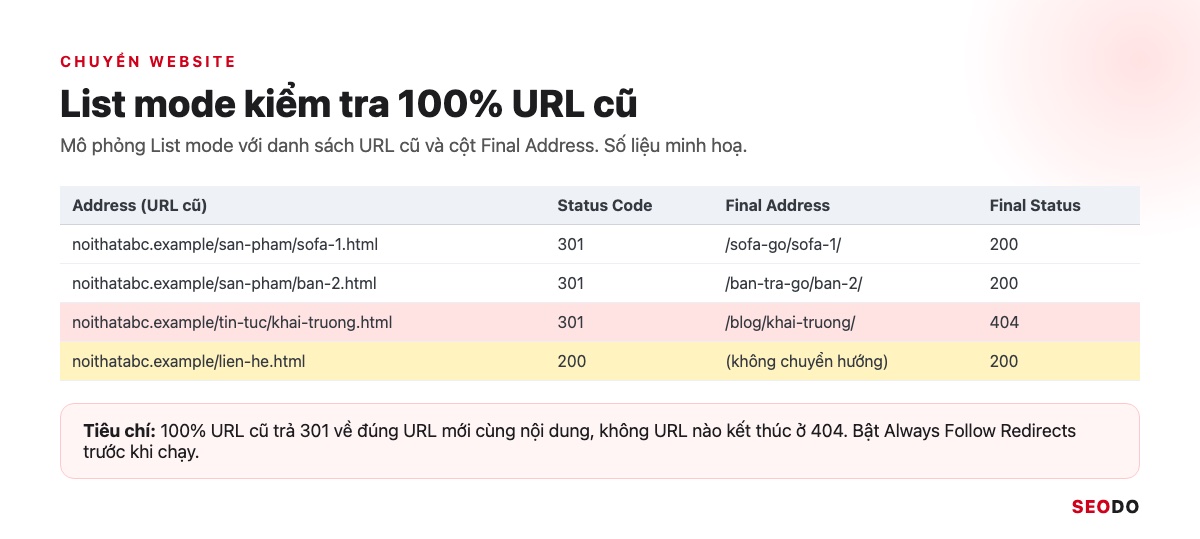
6.4. Kiểm tra chuyển hướng khi chuyển website bằng List mode
Khi đổi tên miền hoặc cấu trúc URL, bạn làm 4 bước:
- Chuyển sang Mode, List.
- Dán toàn bộ URL cũ.
- Bật Always Follow Redirects.
- Xuất báo cáo Redirect Chains.
Cột Final Address cho biết mỗi URL cũ kết thúc ở đâu. Tiêu chí là 100% URL cũ trả 301 về đúng URL mới cùng nội dung, không URL nào kết thúc ở 404.
7. Tính năng nâng cao của Screaming Frog: custom extraction, JavaScript, so sánh crawl và AI
Các tính năng nâng cao giúp bạn tự động hoá những lần kiểm tra lặp lại và lấy đúng dữ liệu riêng của website.
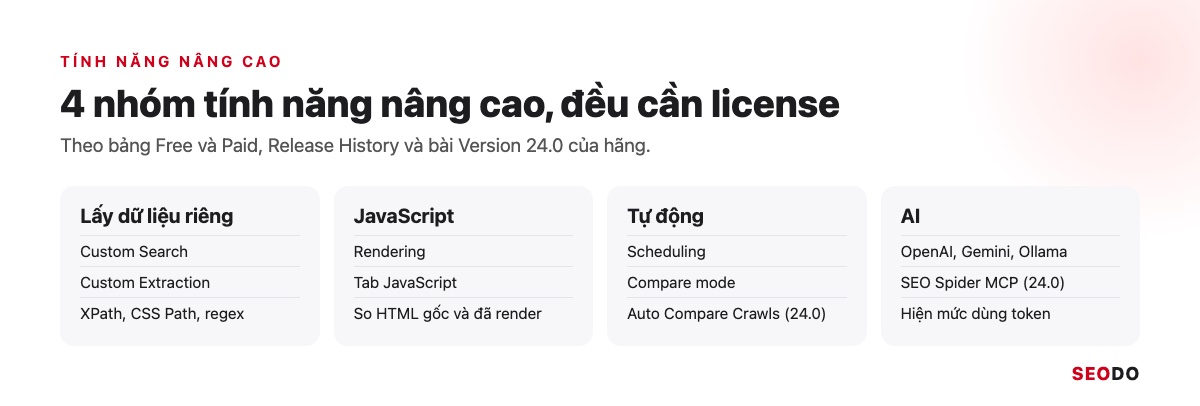
Cả 4 nhóm tính năng nâng cao đều cần license: lấy dữ liệu riêng, render JavaScript, tự động so sánh crawl và kết nối AI. Chúng tiết kiệm nhiều giờ làm tay với website lớn.
Theo bảng Free và Paid trên trang hãng, các tính năng trong phần này chỉ có ở bản trả phí. Chúng không cần cho mọi đợt audit, nhưng với website lớn hoặc khách hàng theo dõi hằng tuần, đây là phần tiết kiệm nhiều giờ làm tay nhất.
7.1. Custom Search và Custom Extraction lấy dữ liệu riêng
Custom Search tìm một chuỗi trong HTML, ví dụ tìm trang còn thiếu mã Google Tag Manager hoặc còn mã theo dõi cũ. Custom Extraction lấy dữ liệu bằng XPath, CSS Path hoặc regex, ví dụ ngày đăng, tác giả hay số sản phẩm mỗi danh mục. Tiêu chí của SEODO là thử biểu thức trên 3 URL mẫu bằng List mode trước khi crawl toàn bộ. Một biểu thức sai sẽ trả về cột trống cho hàng nghìn URL.
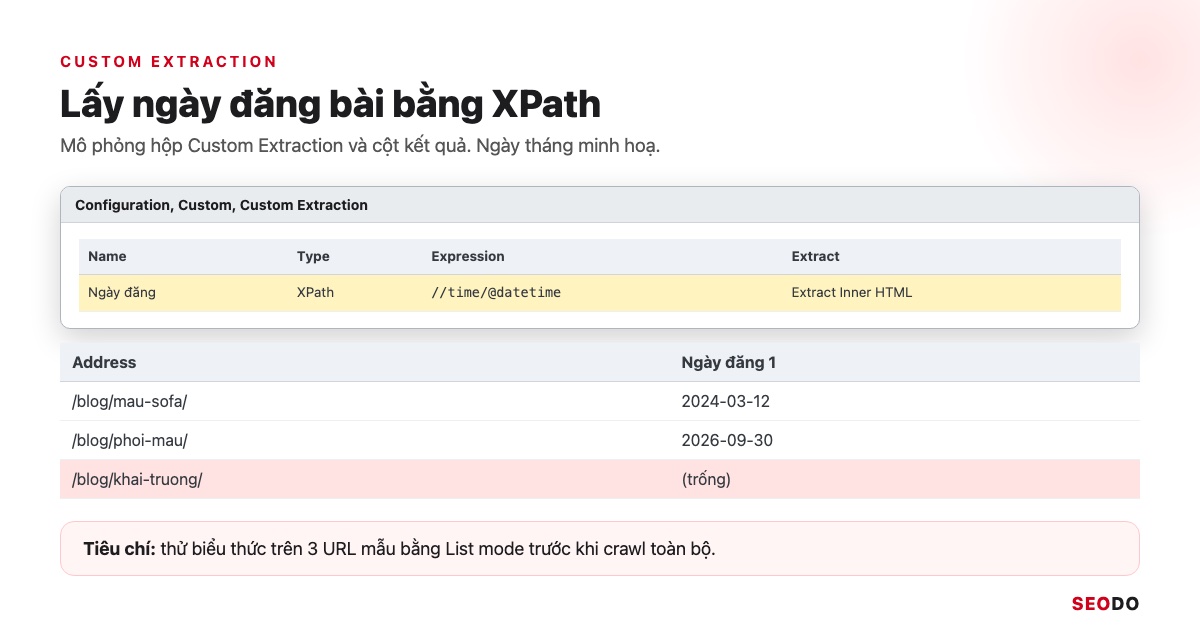
Biểu thức XPath lấy giá trị ngày đăng từ thẻ time:
//time/@datetime7.2. Render JavaScript và so sánh HTML gốc với HTML đã render
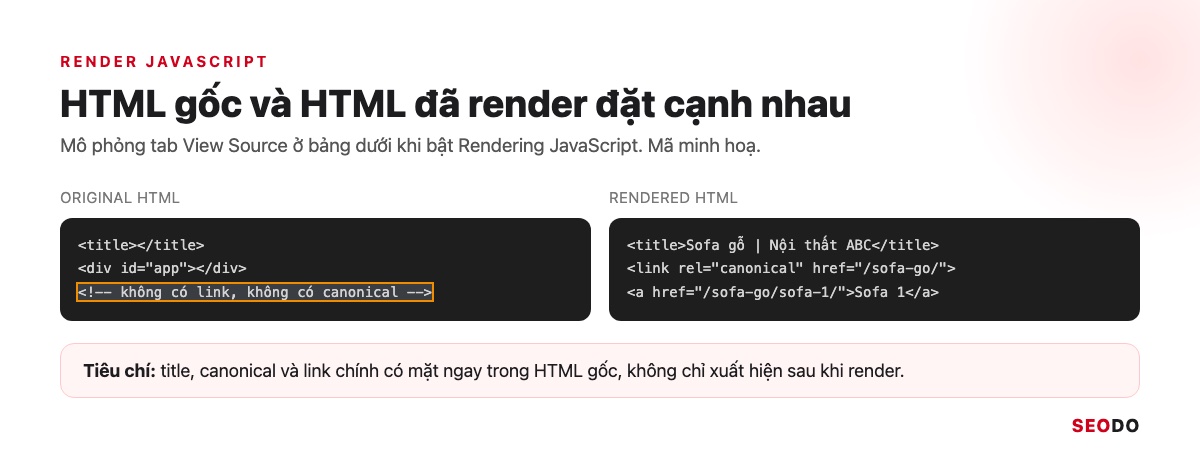
Khi bật Rendering, JavaScript, tab JavaScript cho thấy nội dung và link chỉ xuất hiện sau khi render. Bảng dưới View Source đặt HTML gốc cạnh HTML đã render. Tiêu chí là title, canonical và link chính phải có mặt ngay trong HTML gốc, để Google không phụ thuộc vào bước render mới hiểu được trang.
7.3. Lên lịch crawl, so sánh crawl và Auto Compare Crawls
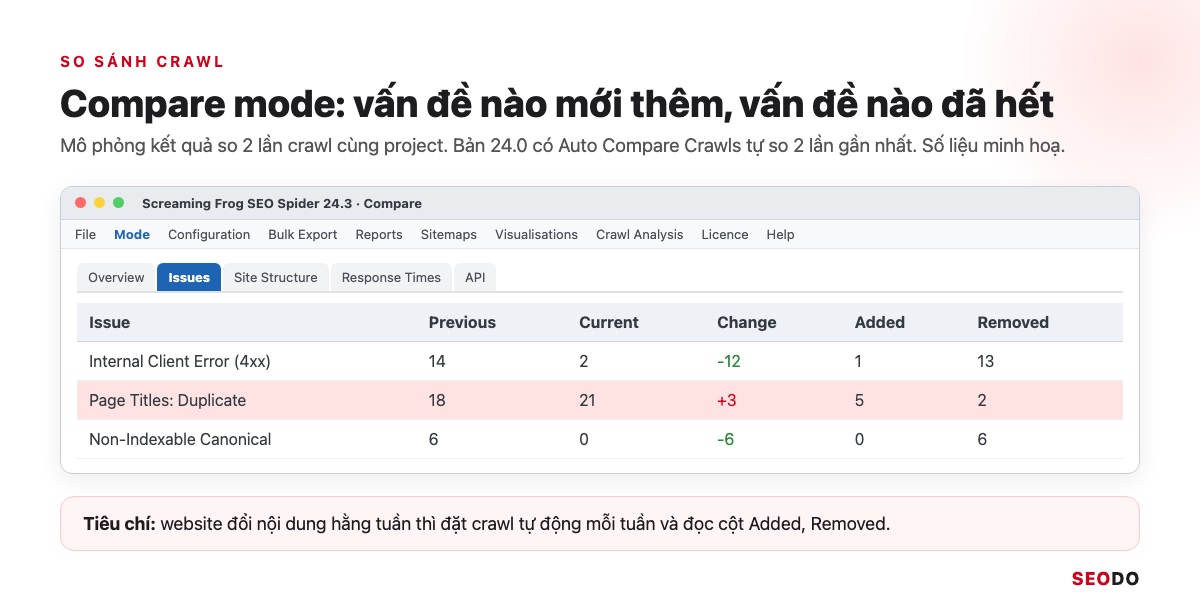
File, Scheduling đặt lịch crawl tự động, Compare mode so 2 lần crawl. Bản 24.0 thêm Auto Compare Crawls tự so 2 lần crawl gần nhất của cùng project, kèm bảng thay đổi vấn đề trong email thông báo. Tiêu chí của tôi là website đổi nội dung hằng tuần thì đặt crawl tự động mỗi tuần 1 lần và đọc cột Added, Removed của Issues để thấy lỗi mới phát sinh.
7.4. Kết nối AI và Screaming Frog MCP
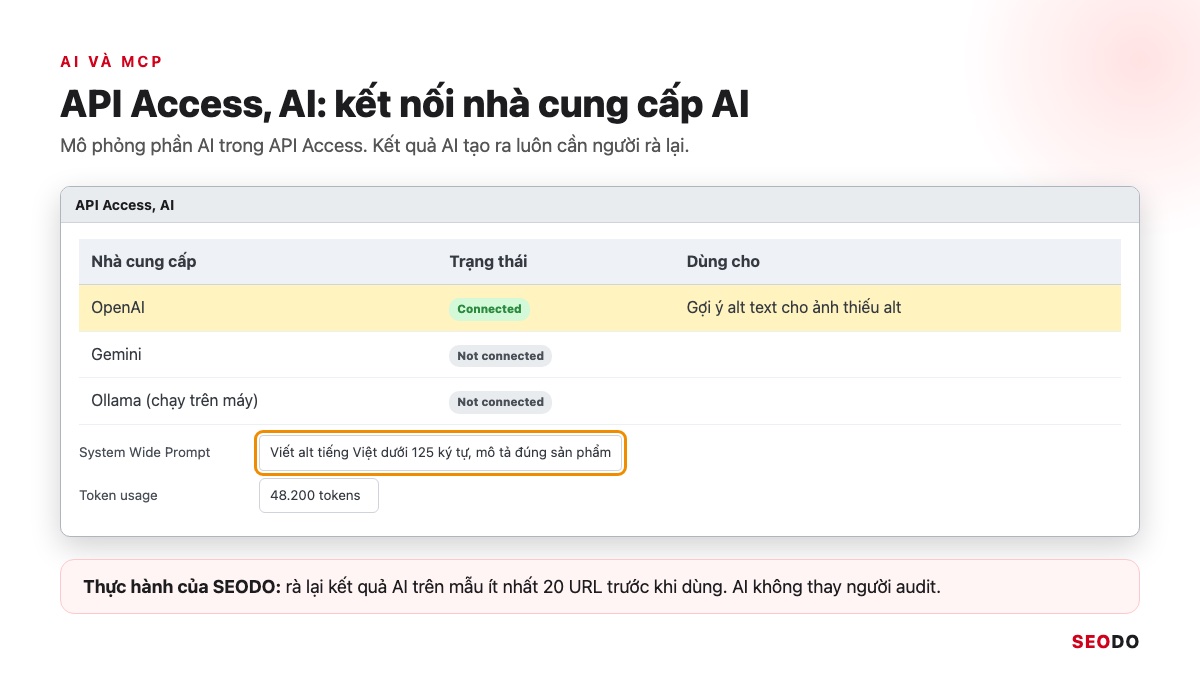
Configuration, API Access, AI kết nối OpenAI, Gemini hoặc Ollama để gợi ý alt cho ảnh, phân loại trang, có System Wide Prompt và phần hiện mức dùng token. Bản 24.0 có SEO Spider MCP để điều khiển crawl bằng ngôn ngữ tự nhiên trong trợ lý AI. Hãng ghi chưa hỗ trợ mọi tính năng. Thực hành của SEODO là rà lại kết quả AI trên mẫu ít nhất 20 URL trước khi dùng, vì AI không thay được người audit.
8. Cách xuất báo cáo Screaming Frog và lập kế hoạch sửa lỗi
Phần này biến bảng dữ liệu crawl thành danh sách việc có người làm, có hạn và có cách xác nhận đã sửa.
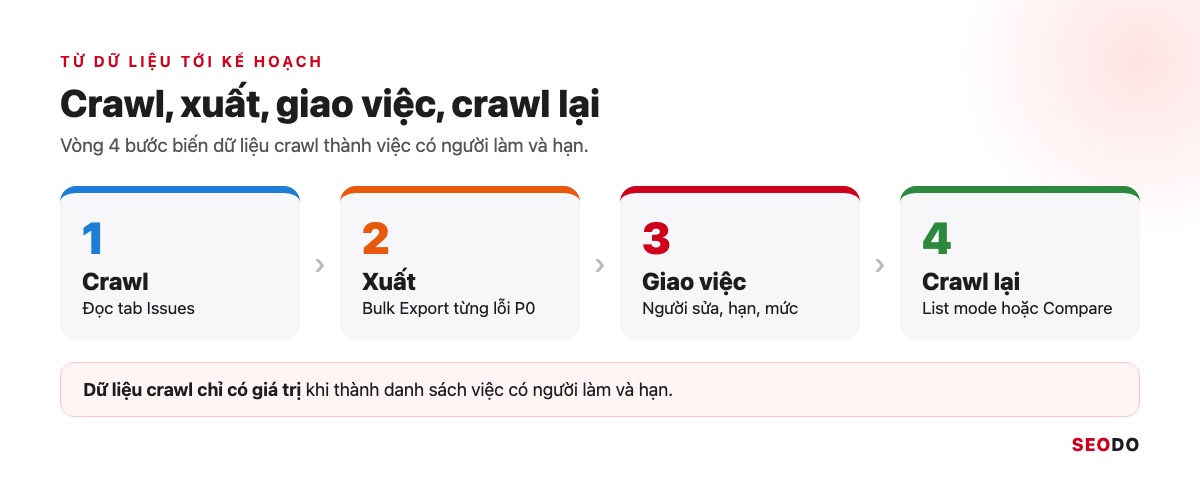
Dữ liệu crawl thành kế hoạch qua 3 bước: xuất lỗi, lập bảng giao việc và crawl lại để xác nhận. P0 sửa trong tuần, P1 trong tháng, P2 theo đợt.
Dữ liệu crawl chỉ có giá trị khi thành danh sách việc có người làm và hạn. Đội SEODO luôn khép mỗi đợt audit bằng 3 tệp:
- Tệp xuất lỗi.
- Bảng giao việc.
- Kết quả crawl lại.
Cách trình bày báo cáo SEO audit cho khách hàng có mẫu đầy đủ ở bài riêng.
8.1. Xuất Bulk Export, Reports và Looker Studio
Có 3 cách xuất dữ liệu:
- Bulk Export: xuất theo vấn đề.
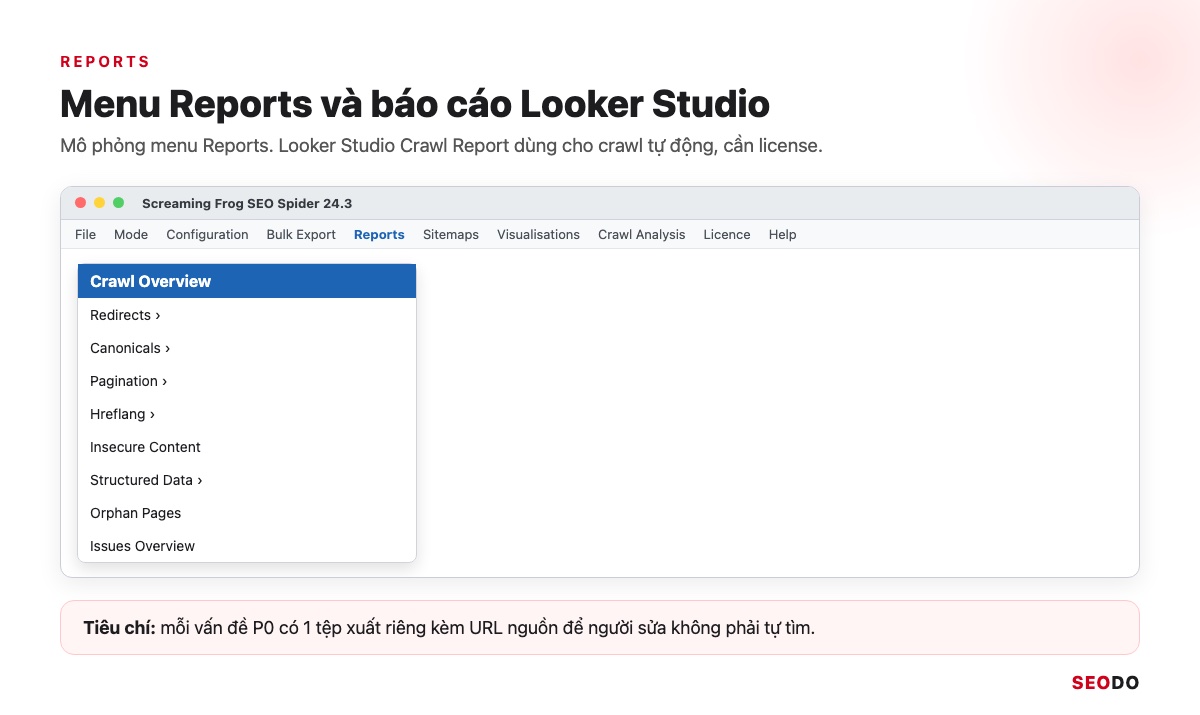
- Reports: có Crawl Overview, Redirect Chains, Orphan Pages và Issues Overview.
- Looker Studio Crawl Report (cần license): dựng báo cáo tự động từ các lần crawl theo lịch.
Tiêu chí là mỗi vấn đề P0 có 1 tệp xuất riêng kèm URL nguồn, để người sửa không phải tự tìm lại trong công cụ. Khi đội nội bộ không đủ người sửa hết các việc P0, P1 theo bảng này, doanh nghiệp có thể thuê dịch vụ SEO để xử lý phần kỹ thuật.
8.2. Bảng giao việc từ dữ liệu crawl
Từ các tệp xuất, đội SEODO lập một bảng giao việc duy nhất với 7 cột:
- Vấn đề.
- Số URL.
- URL mẫu.
- Cách sửa.
- Người sửa.
- Hạn.
- Mức.
Định mức thực hành theo mức ưu tiên:
- P0: sửa trong tuần.
- P1: sửa trong tháng.
- P2: sửa theo đợt.
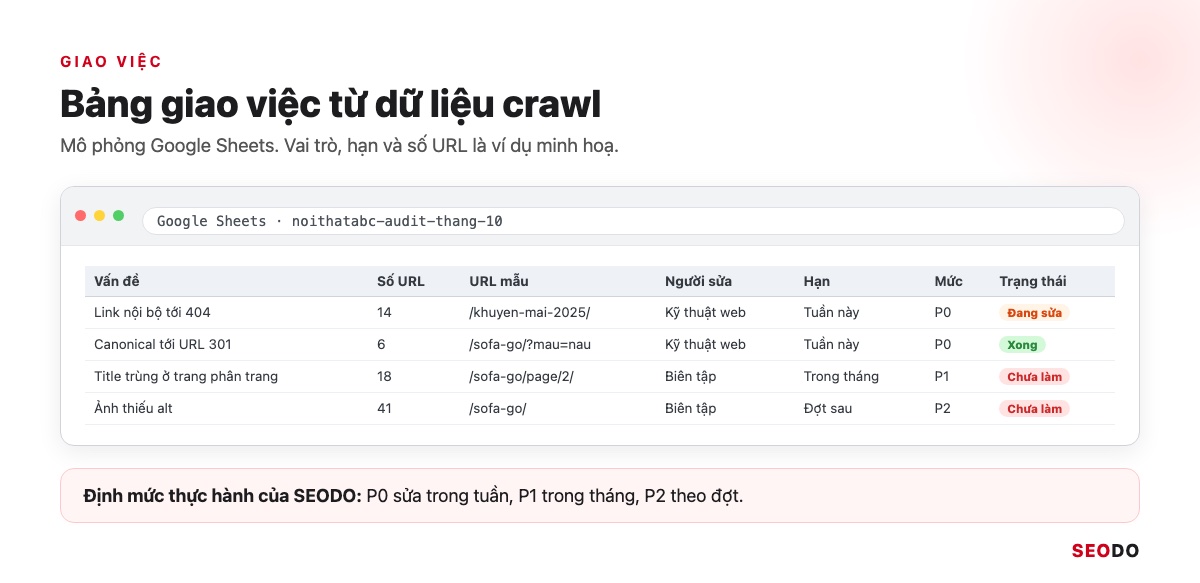
| Vấn đề | URL mẫu | Cách sửa | Người sửa | Hạn | Mức |
| Link nội bộ tới 404 | /khuyen-mai-2025/ | Sửa link ở menu, bài liên quan | Kỹ thuật web | Trong tuần | P0 |
| Canonical tới URL 301 | /sofa-go/?mau=nau | Đổi canonical về URL cuối | Kỹ thuật web | Trong tuần | P0 |
| Title trùng trang phân trang | /sofa-go/page/2/ | Thêm số trang vào title | Biên tập | Trong tháng | P1 |
| Ảnh thiếu alt | /sofa-go/ | Viết alt mô tả sản phẩm | Biên tập | Đợt sau | P2 |
8.3. Crawl lại để xác nhận đã sửa
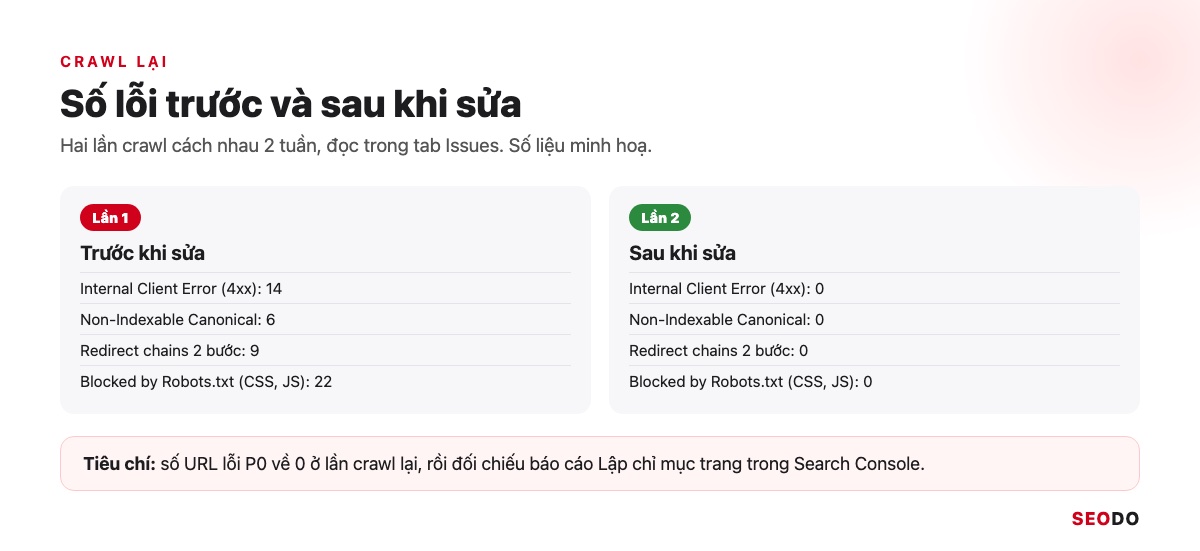
Sau khi đội báo xong, bạn crawl lại bằng List mode với các URL đã sửa hoặc dùng Compare với lần crawl trước. Phần Google thật sự ghi nhận thì xem ở báo cáo Lập chỉ mục trang trong Search Console, vì việc crawl lại chỉ xác nhận website đã đổi. Tiêu chí là số URL lỗi P0 về 0 ở lần crawl lại.
9. Screaming Frog có tốt hơn Semrush không? So sánh với các công cụ audit khác
So sánh theo loại công cụ giúp bạn biết khi nào chỉ cần Screaming Frog, khi nào cần thêm một bộ công cụ đám mây.
Screaming Frog là crawler cài máy, cấu hình sâu, trả theo năm, còn Semrush, Ahrefs là bộ công cụ đám mây trả theo tháng. Search Console là dữ liệu thật của Google, dùng cùng cả hai.
Screaming Frog không hẳn tốt hơn Semrush, vì hai công cụ khác loại. Screaming Frog là crawler cài trên máy, cấu hình rất sâu và trả phí theo năm. Semrush là bộ công cụ đám mây có Site Audit đi kèm dữ liệu từ khoá, backlink và trả theo tháng. Không công cụ nào tốt nhất cho mọi đội. Bạn chọn theo việc chính cần làm.
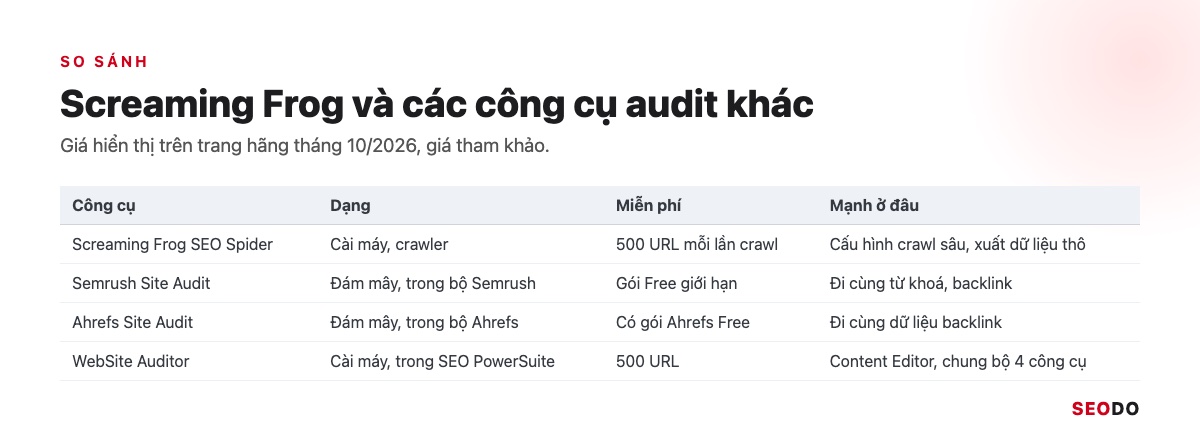
| Công cụ | Dạng | Miễn phí | Khi nào chọn |
| Screaming Frog SEO Spider | Cài máy, crawler | 500 URL mỗi lần crawl | Audit kỹ thuật sâu, website lớn |
| Semrush Site Audit | Đám mây, trong bộ Semrush | Gói Free có giới hạn | Cần cả từ khoá, quảng cáo, nội dung |
| Ahrefs Site Audit | Đám mây, trong bộ Ahrefs | Gói Ahrefs Free | Cần dữ liệu backlink đi kèm |
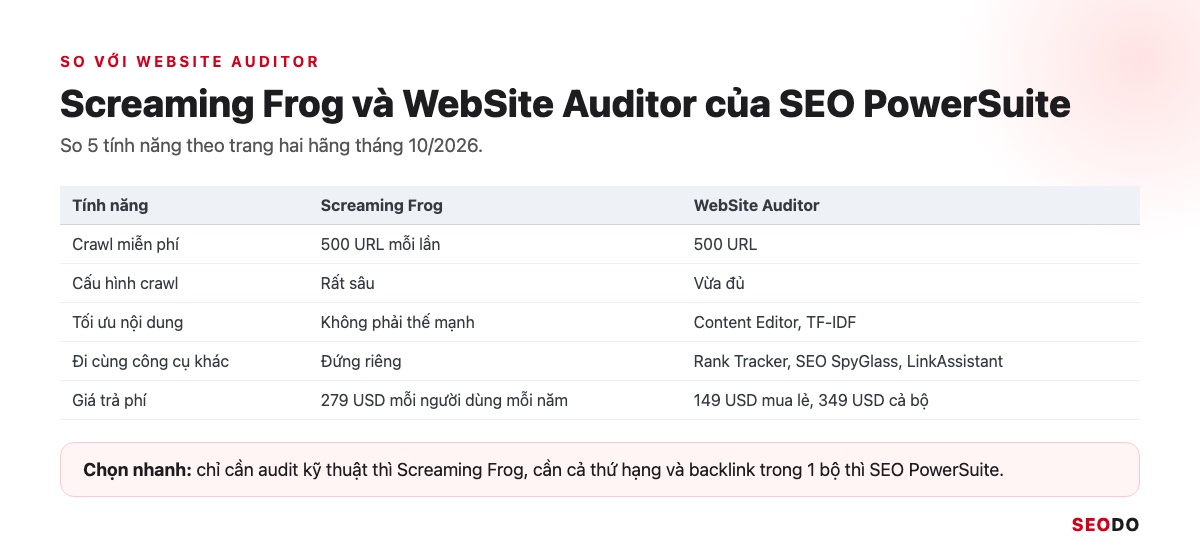
| WebSite Auditor | Cài máy, trong SEO PowerSuite | 500 URL | Cần audit, thứ hạng, backlink trong 1 bộ |
Muốn xem các nhóm công cụ theo từng việc và ngân sách, bài so sánh phần mềm SEO của SEODO có bảng chọn nhanh.
9.1. So với Semrush Site Audit và Ahrefs Site Audit
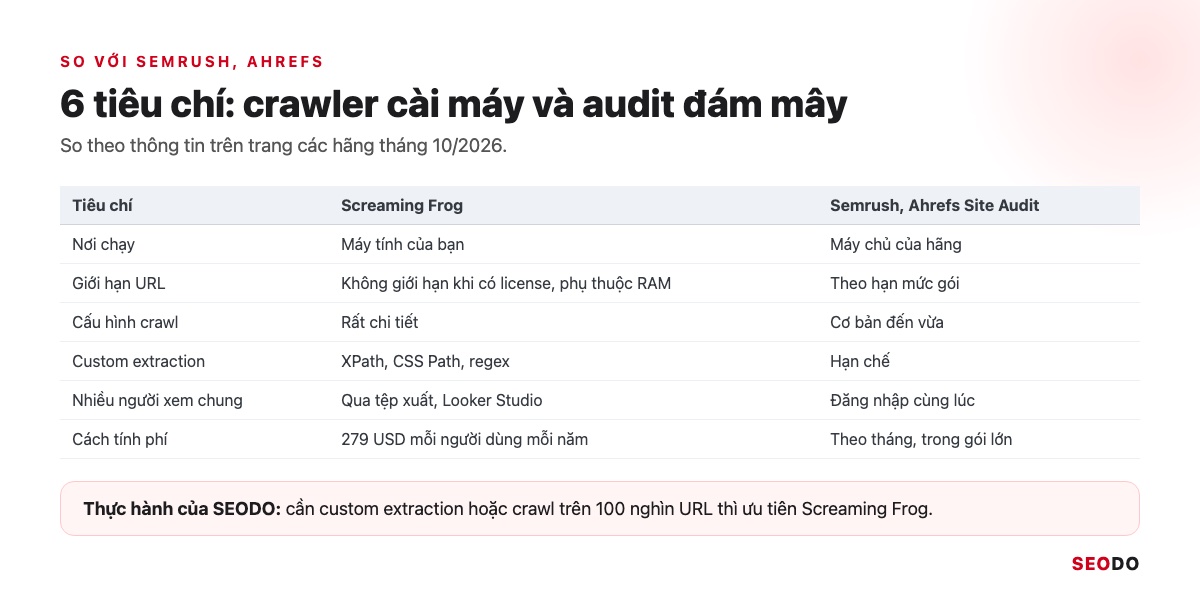
Site Audit của Semrush và Ahrefs chạy trên máy chủ hãng, nhiều người xem chung và lịch crawl chạy cả khi bạn tắt máy. Screaming Frog chạy trên máy, không giới hạn URL khi có license và xuất dữ liệu thô rất linh hoạt. Thực hành của SEODO là cần custom extraction hoặc crawl trên 100 nghìn URL thì ưu tiên Screaming Frog.
9.2. So với WebSite Auditor trong SEO PowerSuite
Cả hai crawl miễn phí tới 500 URL. WebSite Auditor của SEO PowerSuite có thêm Content Editor và nằm chung bộ với Rank Tracker, SEO SpyGlass, LinkAssistant. Tiêu chí chọn: chỉ cần audit kỹ thuật thì Screaming Frog, cần cả theo dõi thứ hạng và backlink trong 1 bộ cài thì SEO PowerSuite.
9.3. Screaming Frog và Google Search Console bổ sung cho nhau
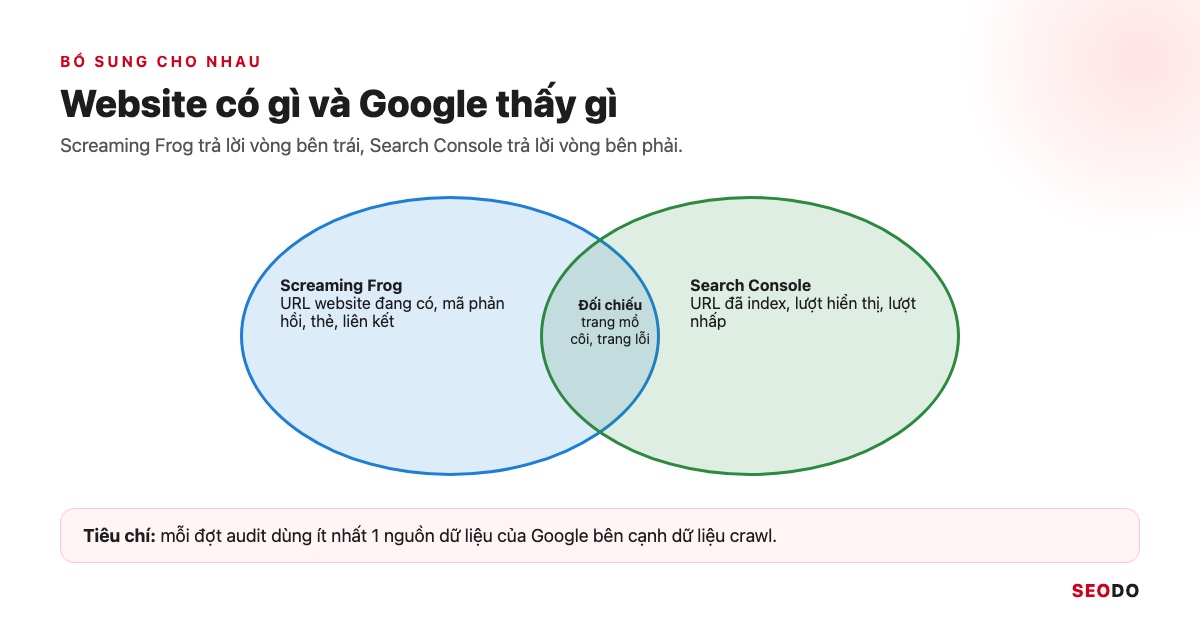
Screaming Frog cho biết website đang có gì khi bot đi qua, còn báo cáo Search Console cho biết Google đã index gì và người tìm thấy gì. Phần giao nhau, ví dụ URL có lượt hiển thị mà crawl không thấy, là nơi lộ ra trang mồ côi. Tiêu chí của SEODO là mỗi đợt audit dùng ít nhất 1 nguồn dữ liệu của Google bên cạnh dữ liệu crawl. Với tốc độ trang thì dùng các cách kiểm tra tốc độ website có dữ liệu thực địa.
10. 3 hiểu lầm khi dùng Screaming Frog nên bỏ
Ba hiểu lầm này dễ khiến bạn kết luận sai về website chỉ từ một lần crawl.
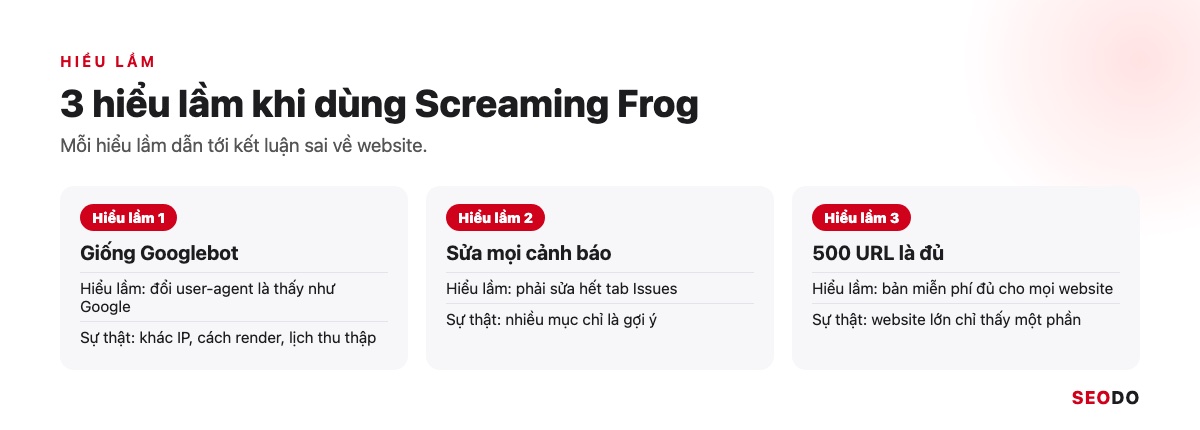
Đổi user-agent không biến công cụ thành Googlebot, nhiều mục trong Issues chỉ là gợi ý. Bản miễn phí 500 URL chỉ thấy một phần của website lớn.
Screaming Frog cho dữ liệu rất chi tiết, nên người mới dễ tin tuyệt đối vào nó. Ba hiểu lầm dưới đây là những lỗi đọc dữ liệu tôi gặp nhiều nhất khi khách tự chạy công cụ.
10.1. “Screaming Frog thấy website giống hệt Googlebot”
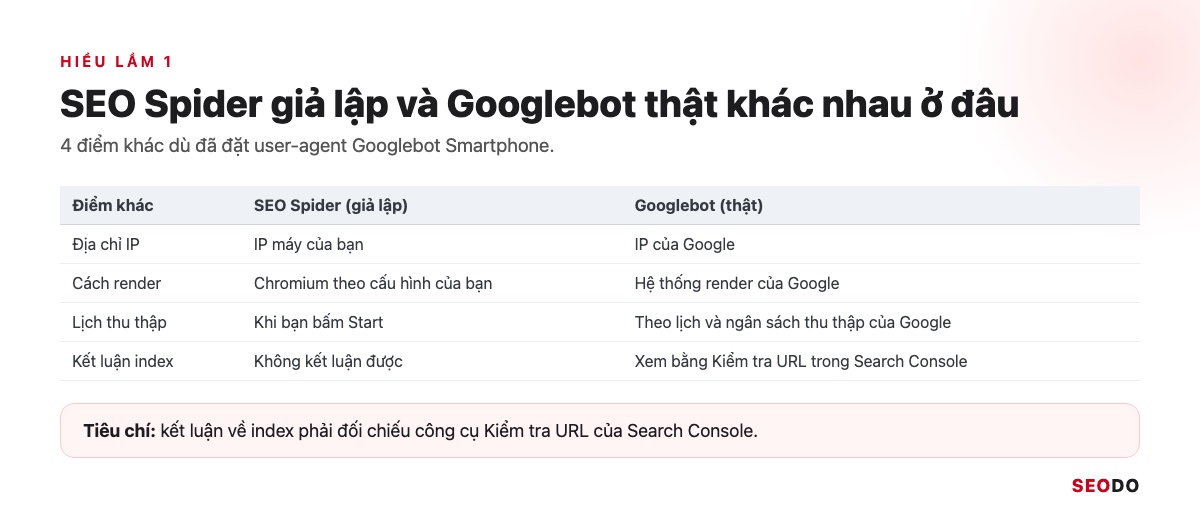
Đổi user-agent thành Googlebot Smartphone không biến công cụ thành Googlebot. Công cụ vẫn khác Googlebot ở 3 điểm:
- Chạy từ IP máy bạn.
- Render theo cấu hình của bạn.
- Crawl khi bạn bấm Start.
Còn Google có hệ thống render và lịch thu thập riêng. Tiêu chí là mọi kết luận về index phải đối chiếu công cụ Kiểm tra URL của Search Console.
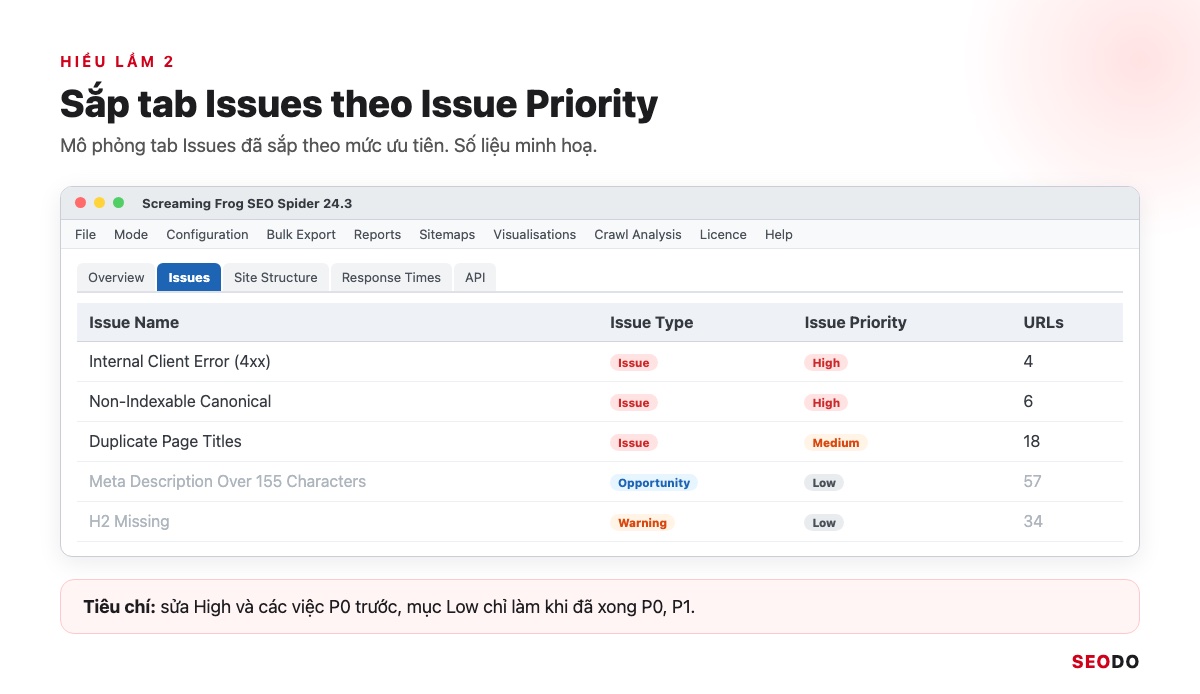
10.2. “Phải sửa hết mọi cảnh báo trong tab Issues”
Tab Issues gồm ba loại Issue, Warning, Opportunity với mức ưu tiên High, Medium, Low. Nhiều mục chỉ là gợi ý tối ưu. Sửa hết mọi dòng thường tốn công mà không đổi được gì. Tiêu chí là sửa mục High và các việc P0 trước, mục Low chỉ làm khi đã xong P0, P1.
10.3. “Bản miễn phí 500 URL là đủ cho mọi website”
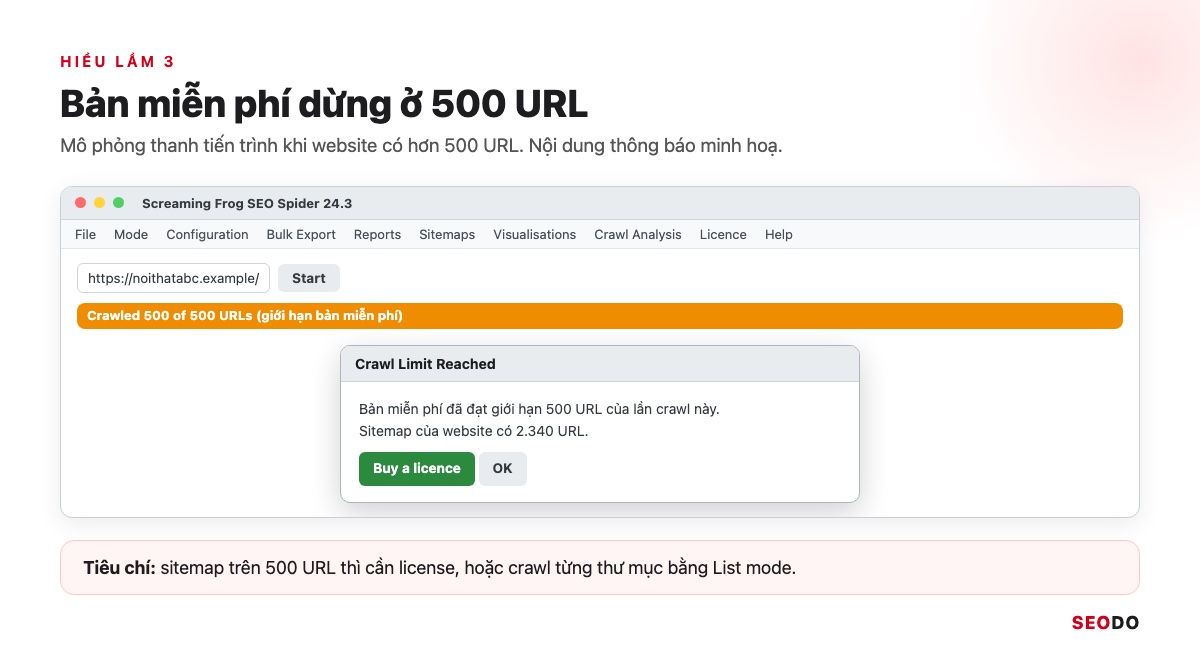
Giới hạn 500 URL tính cho mỗi lần crawl. Website lớn hơn thì công cụ dừng giữa chừng, bạn chỉ thấy một phần và dễ kết luận sai. Tiêu chí là số URL trong sitemap trên 500 thì cần license, hoặc chia nhỏ crawl theo từng thư mục bằng List mode.
11. Câu hỏi thường gặp về Screaming Frog
Câu trả lời ngắn cho những thắc mắc hay gặp nhất trước khi cài và mua Screaming Frog.
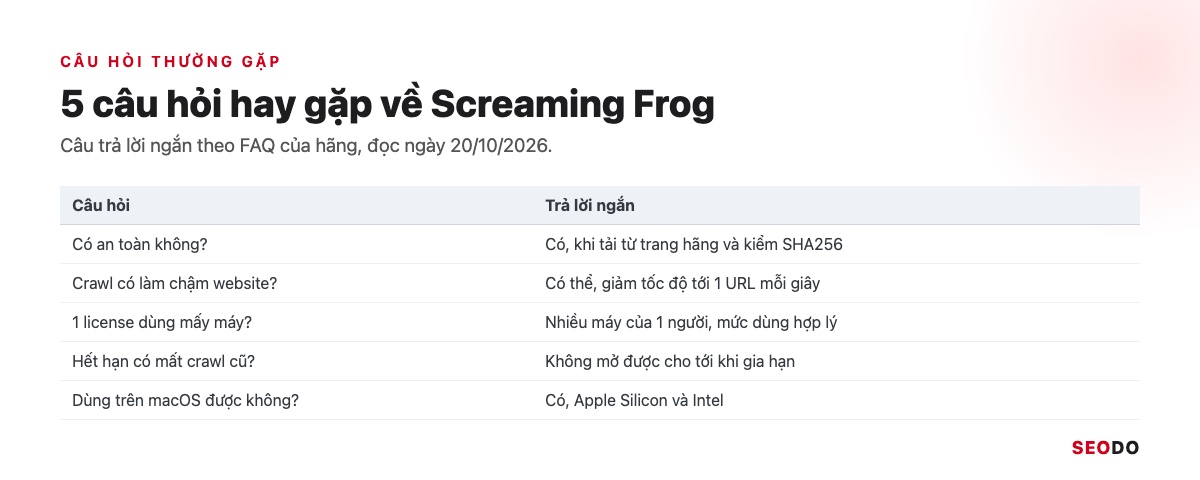
Screaming Frog an toàn khi tải từ trang hãng, crawl chậm lại được khi máy chủ yếu và chạy được trên macOS. License tính theo người, hết hạn thì không mở được crawl đã lưu.
11.1. Screaming Frog có an toàn không?
Có, khi bạn tải từ screamingfrog.co.uk và kiểm tra mã SHA256 của tệp như phần 3.1. Theo FAQ, công cụ tuân thủ robots.txt như Google. Điểm cần cẩn thận là đăng nhập bằng form. Bot bấm mọi liên kết, nên chỉ dùng tài khoản chỉ có quyền xem.
11.2. Crawl bằng Screaming Frog có làm chậm website không?
Có thể, nếu máy chủ yếu và bạn crawl với nhiều luồng cùng lúc. FAQ của hãng gợi ý giảm tốc độ, ví dụ 1 URL mỗi giây khi gặp lỗi 503 hoặc quá thời gian chờ. Bạn cũng nên chọn giờ ít người truy cập để crawl website lớn.
11.3. Một license Screaming Frog dùng được mấy máy?
Một license dùng được trên nhiều máy, miễn là chỉ một người dùng, vì license tính theo người dùng chứ không theo máy. Theo FAQ, một người cài được trên nhiều máy với mức dùng hợp lý, miễn là chỉ người đó truy cập. Đội có 2 người cùng dùng thì cần 2 license, mua từ 5 license được giá giảm theo bậc.
11.4. Hết hạn license thì dữ liệu crawl cũ có mất không?
Dữ liệu không mất khỏi máy, nhưng theo FAQ, khi hết hạn công cụ trở về bản miễn phí và không mở được các crawl đã lưu cho tới khi gia hạn. Vì vậy bạn nên xuất những báo cáo cần giữ trước ngày hết hạn.
11.5. Screaming Frog có dùng được trên macOS không?
Có. Trang tải có bản macOS cho cả chip Apple Silicon và Intel, cùng bản Windows và Linux (Ubuntu, Fedora). Bạn chọn đúng bản theo chip của máy để công cụ chạy ổn định và tận dụng được bộ nhớ.
Nguồn tham khảo
- Screaming Frog: SEO Spider (bảng Free và Paid, hệ điều hành), đọc ngày 20/10/2026
- Screaming Frog: SEO Spider Pricing, đọc ngày 20/10/2026
- Screaming Frog: SEO Spider Release History (24.0 ngày 19/05/2026 đến 24.3 ngày 29/06/2026)
- Screaming Frog: SEO Spider FAQ (giới hạn 500 URL, license, tốc độ crawl, robots.txt, đăng nhập bằng form)
- Screaming Frog: SEO Spider User Guide, mục General và Configuration
- Google Search Central: Make your links crawlable
- Google Search Central: Introduction to robots.txt, Redirects and Google Search, Consolidate duplicate URLs
- Search Console Help: Công cụ kiểm tra URL, Báo cáo Lập chỉ mục trang
- Link-Assistant.Com: Pricing (WebSite Auditor), đọc ngày 20/10/2026