
 WulingTăng trưởng bền vững từ chiến lược SEO
 SCGNghiệm thu dự án sớm 2 tháng
 cirCOVượt KPI trước 3 tháng
Bạn vừa sửa robots.txt để chặn vài trang thừa, vài tuần sau Search Console báo trang quan trọng “Bị chặn bởi robots.txt”, còn trang muốn giấu thì vẫn nằm trên Google?
Tôi là Thái Doãn Kiên, founder SEODO. Lỗi robots.txt tôi hay gặp khi audit là dùng tệp này để giấu trang. Ví dụ ghi Disallow cho /bao-gia-khach-hang/, URL đó vẫn hiện trên Google với phần mô tả trống, còn ai mở tệp cũng thấy đường dẫn thư mục. Robots.txt chỉ điều khiển việc thu thập, một dòng sai có thể chặn cả website.
Robots.txt chỉ là một tệp văn bản vài dòng, nên sửa cho đúng không mất nhiều thời gian. Bạn sẽ viết được robots.txt theo đúng cú pháp Google công bố, có mẫu file cho WordPress và cho bot AI, cách kiểm tra bằng Search Console và 7 lỗi nên rà ngay.
Tóm tắt nhanh
- Robots.txt là gì: robots.txt là tệp văn bản ở thư mục gốc của website, cho trình thu thập dữ liệu biết được phép truy cập URL nào, mỗi host chỉ có 1 tệp.
- Không phải công cụ ẩn trang: trang bị robots.txt chặn vẫn có thể được lập chỉ mục nếu có liên kết trỏ tới, muốn trang không hiện trên Google thì dùng noindex hoặc mật khẩu.
- Cú pháp Google hỗ trợ: chỉ 4 trường user-agent, allow, disallow và sitemap, tệp mã hoá UTF-8 và Google bỏ qua phần vượt quá 500 KiB.
- Thứ tự ưu tiên: mỗi bot chỉ theo 1 nhóm user-agent cụ thể nhất, trong nhóm đó quy tắc có đường dẫn dài nhất thắng, ngang nhau thì Allow thắng.
- Mẫu cho WordPress: website thường chỉ cần chặn /wp-admin/ trừ admin-ajax.php, chặn trang tìm kiếm nội bộ và khai báo sitemap, không chặn thư mục chứa CSS, JavaScript.
- Bot AI: mỗi hãng tách bot huấn luyện và bot tìm kiếm, chặn GPTBot, ClaudeBot hay Google-Extended không làm website mất khỏi Google Search.
- Kiểm tra: dùng báo cáo robots.txt trong phần Cài đặt của Search Console và công cụ Kiểm tra URL, Google thường làm mới bản lưu robots.txt trong tối đa 24 giờ.
1. Robots.txt là gì?
Hiểu đúng robots.txt nằm ở đâu và Google đọc nó ra sao giúp bạn sửa tệp mà không vô tình khoá cả website.
Robots.txt là tệp văn bản thuần đặt ở thư mục gốc của một host, cho trình thu thập dữ liệu biết URL nào được phép truy cập.
- Chuẩn chung: thuộc Robots Exclusion Protocol, được IETF chuẩn hoá thành RFC 9309 vào tháng 09/2022.
- Phạm vi: 1 tệp cho mỗi tổ hợp giao thức, host và cổng, tệp trong thư mục con không được đọc.
- Bộ nhớ đệm: Google thường giữ bản lưu robots.txt tối đa 24 giờ trước khi tải lại.
Website không có robots.txt vẫn hoạt động bình thường, Google khi đó được thu thập mọi URL.
Robots.txt là tệp văn bản đặt ở thư mục gốc của website, dùng để cho trình thu thập dữ liệu như Googlebot biết được phép truy cập những URL nào. Theo trang Giới thiệu về robots.txt của Google, mục đích chính của tệp là tránh để máy chủ phải nhận quá nhiều yêu cầu, chứ không phải để giấu trang khỏi kết quả tìm kiếm.
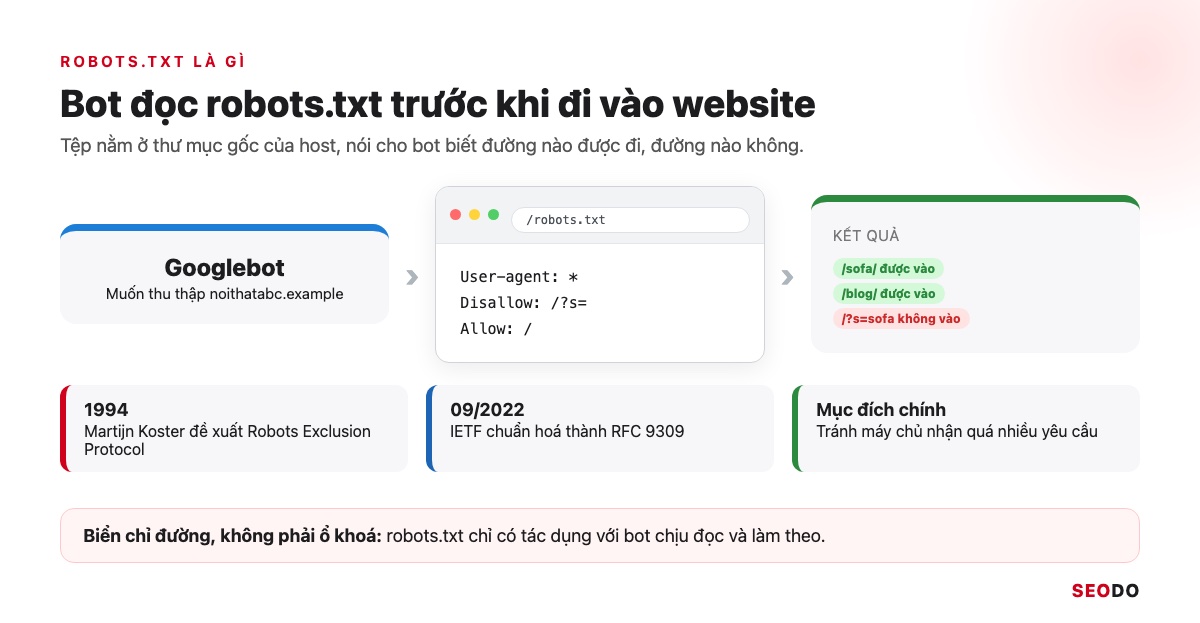
Ý tưởng này có từ rất sớm. Năm 1994, Martijn Koster đề xuất một quy ước để chủ website báo cho robot biết khu vực không nên ghé, gọi là Robots Exclusion Protocol. Suốt gần 30 năm, đó chỉ là quy ước không chính thức, cho tới khi IETF ban hành RFC 9309 vào tháng 09/2022. Google, Bing và phần lớn bot AI hiện đọc robots.txt theo chuẩn này, nhưng mỗi bên vẫn có cách hiểu riêng ở vài lệnh mở rộng.
1.1. File robots.txt nằm ở đâu và áp dụng cho phạm vi nào
Tệp phải tên đúng là robots.txt, viết chữ thường, và nằm ở thư mục gốc của host, ví dụ https://noithatabc.example/robots.txt. Mỗi host chỉ có 1 tệp. Theo đặc tả robots.txt của Google, quy tắc chỉ áp dụng cho đúng giao thức, host và cổng nơi đặt tệp, nên một subdomain như shop.noithatabc.example cần tệp riêng.
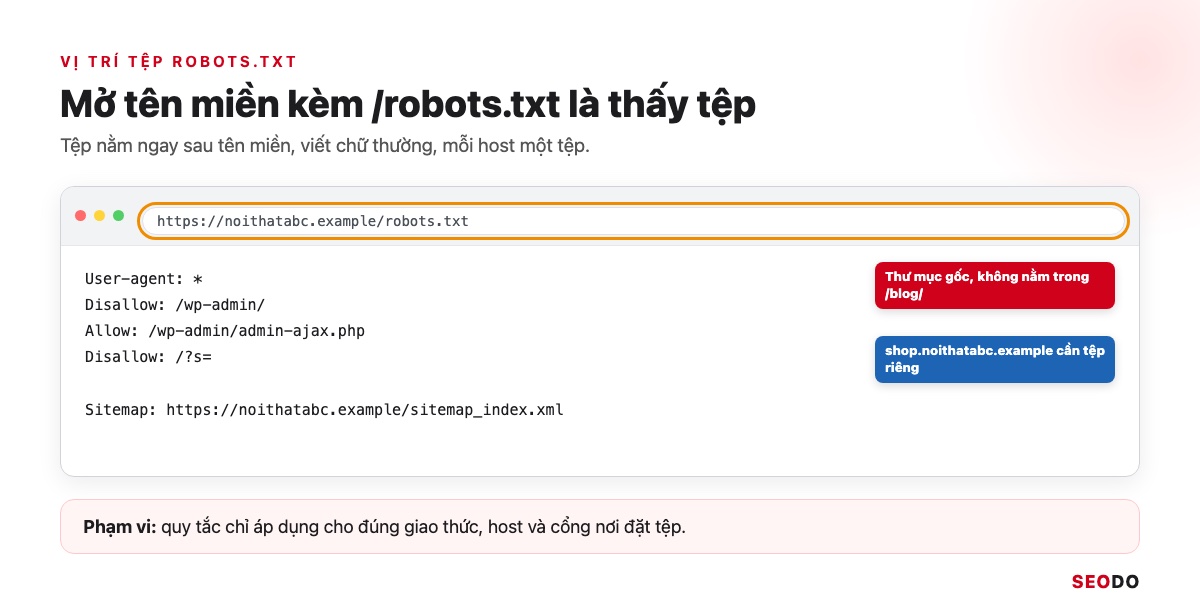
| URL của tệp | Áp dụng cho | Không áp dụng cho |
| https://noithatabc.example/robots.txt | Mọi URL bắt đầu bằng https://noithatabc.example/ | http://noithatabc.example/ và https://shop.noithatabc.example/ |
| https://shop.noithatabc.example/robots.txt | Mọi URL của https://shop.noithatabc.example/ | Tên miền chính và các subdomain khác |
| https://noithatabc.example:8181/robots.txt | Chỉ nội dung trên cổng 8181 | https://noithatabc.example/ ở cổng chuẩn 443 |
| https://noithatabc.example/blog/robots.txt | Không áp dụng, vì bot không tìm robots.txt trong thư mục con | Mọi URL |
Website còn chạy song song http và https thì mỗi giao thức được xem như một nơi riêng, còn cổng chuẩn 80 và 443 tương đương tên miền mặc định.
1.2. Google đọc robots.txt thế nào khi ghé website
Trước khi thu thập một host, Googlebot xin tệp /robots.txt và xử lý theo mã trạng thái HTTP mà máy chủ trả về. Google thường lưu bản đệm robots.txt tối đa 24 giờ, có thể lâu hơn khi không tải lại được tệp, và có thể điều chỉnh thời gian này theo header Cache-Control. Vì vậy, sửa tệp xong không có nghĩa là Google áp dụng ngay.
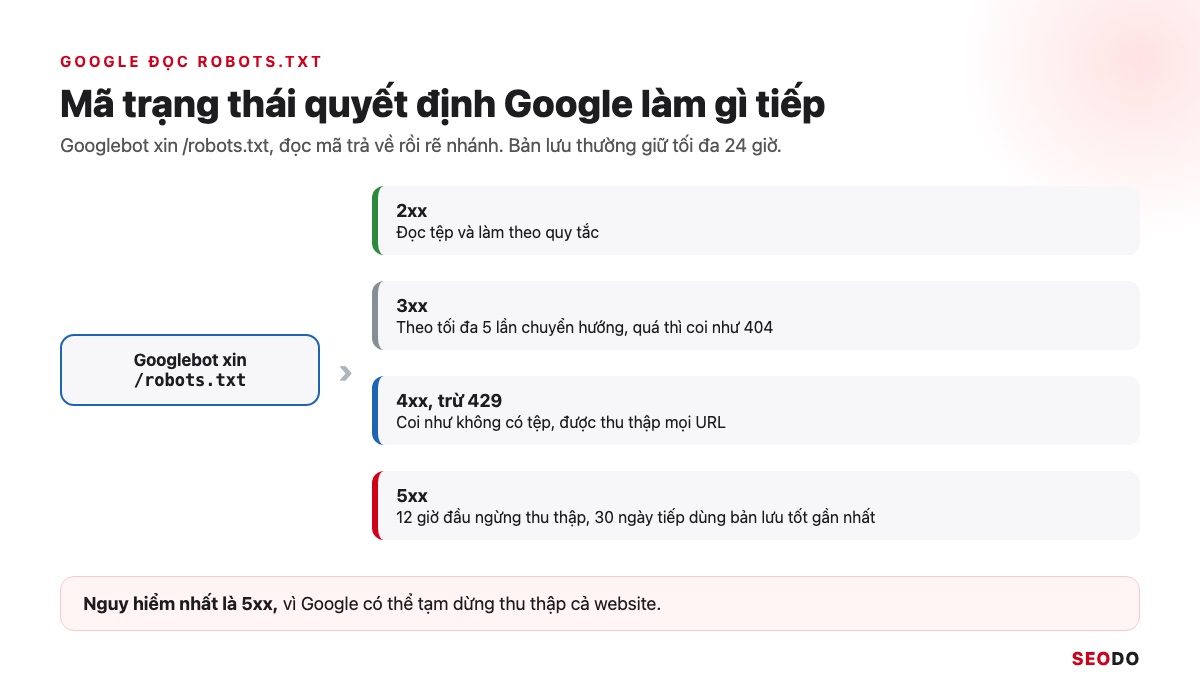
| Mã trạng thái | Google xử lý thế nào | Việc cần làm |
| 2xx (thành công) | Đọc tệp và áp dụng các quy tắc | Giữ tệp trả mã 200 |
| 3xx (chuyển hướng) | Đi theo tối đa 5 lần chuyển hướng, quá số này thì coi như 404 | Đặt tệp đúng host, hạn chế chuyển hướng |
| 4xx, trừ 429 | Coi như không có tệp, tức được thu thập mọi URL | Tạo tệp nếu thật sự có URL cần chặn |
| 5xx (lỗi máy chủ) | 12 giờ đầu ngừng thu thập website, 30 ngày tiếp theo dùng bản lưu tốt gần nhất | Sửa máy chủ ngay, đây là trường hợp nguy hiểm nhất |
Bảng cho thấy một điều ngược trực giác. Tệp trả lỗi 404 gần như vô hại, còn tệp trả lỗi 5xx lại có thể khiến Google tạm dừng thu thập cả website. Lý do là Google không biết bạn muốn chặn gì, nên chọn cách an toàn là chờ máy chủ ổn định.
1.3. Website không có robots.txt có sao không
Không sao. Trang trợ giúp về báo cáo robots.txt của Search Console ghi rõ không có robots.txt là bình thường, và khi đó Google được thu thập mọi URL trên website. Website giới thiệu vài chục trang, không có tìm kiếm nội bộ hay bộ lọc, chạy tốt mà không cần tệp.
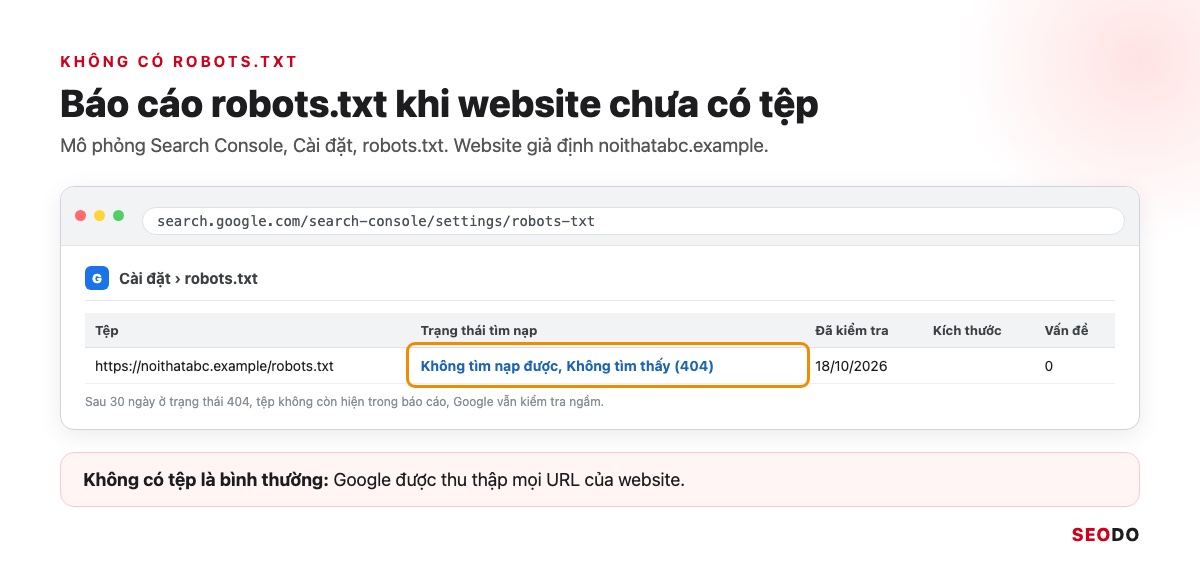
Tệp chỉ thật sự cần khi website có URL nên chặn, như trang tìm kiếm nội bộ, URL bộ lọc, hoặc khi bạn muốn khai báo sitemap cho mọi công cụ tìm kiếm. Trong báo cáo robots.txt, host không có tệp sẽ hiện trạng thái không tìm thấy (404). Sau 30 ngày ở trạng thái này, tệp không còn hiện trong báo cáo dù Google vẫn kiểm tra ngầm.
2. Robots.txt dùng để làm gì và không làm được gì?
Biết rõ giới hạn của robots.txt giúp bạn chọn đúng công cụ cho từng việc, thay vì chặn nhầm trang đang mang traffic.
Robots.txt kiểm soát việc thu thập dữ liệu, không phải cơ chế giữ trang khỏi Google. Tác dụng của nó khác nhau theo 3 loại tệp:
- Trang web: điều tiết lượng thu thập, tránh trang trùng lặp hoặc ít giá trị, nhưng không ẩn trang khỏi kết quả.
- Tệp đa phương tiện: ảnh, video, âm thanh bị chặn sẽ không xuất hiện trong kết quả tìm kiếm.
- Tệp tài nguyên: chỉ chặn khi trang vẫn được hiểu đúng lúc thiếu tài nguyên đó.
Google nêu 3 giới hạn, đáng lo nhất là trang bị chặn vẫn có thể được lập chỉ mục.
Robots.txt trả lời câu hỏi “bot có được vào URL này không”, còn chuyện URL có xuất hiện trên Google hay không là việc của lập chỉ mục. Google viết thẳng trong tài liệu rằng robots.txt không phải cơ chế để giữ một trang web ngoài Google. Nhiều lỗi robots.txt tôi gặp khi audit bắt nguồn từ việc nhầm hai việc này.
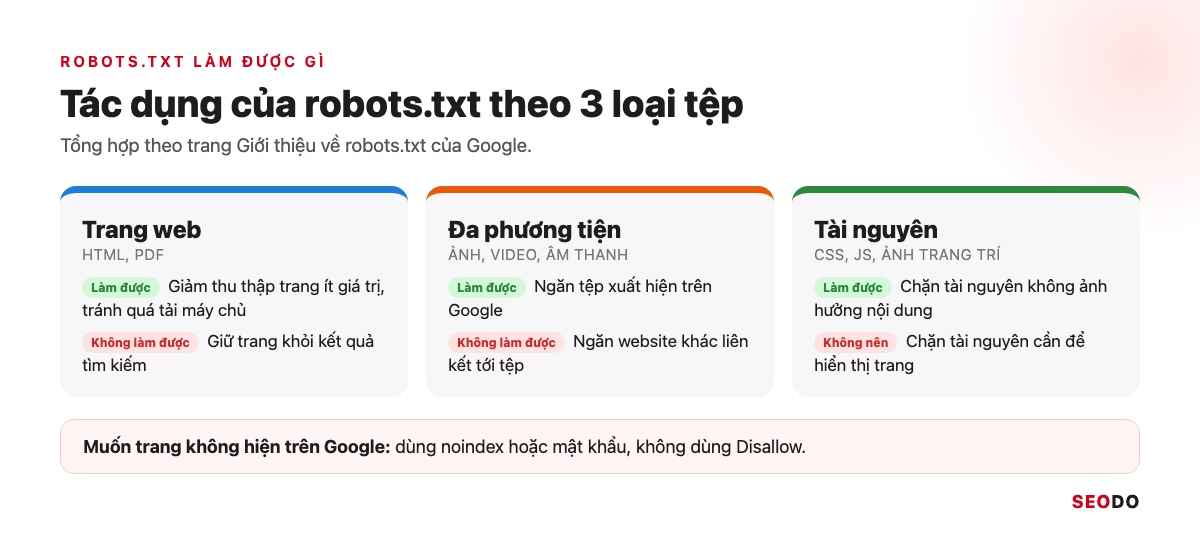
| Loại tệp | Robots.txt làm được | Robots.txt không làm được |
| Trang web (HTML, PDF) | Giảm thu thập trang ít giá trị, tránh quá tải máy chủ | Giữ trang khỏi kết quả tìm kiếm |
| Tệp đa phương tiện | Ngăn ảnh, video, âm thanh xuất hiện trên Google | Ngăn website khác liên kết tới tệp |
| Tệp tài nguyên (CSS, JS, ảnh trang trí) | Chặn tài nguyên không ảnh hưởng nội dung | Chặn tài nguyên cần để hiển thị trang mà không gây hại |
Với website lớn, robots.txt còn giúp dồn ngân sách thu thập dữ liệu vào trang quan trọng, nhưng với website vài nghìn URL trở xuống thì đây hiếm khi là vấn đề cần lo.
2.1. 3 việc nên dùng robots.txt
Trước hết, bạn chặn URL sinh ra gần như vô hạn hoặc ít giá trị, như kết quả tìm kiếm nội bộ, URL bộ lọc và sắp xếp. Trong tài liệu về điều hướng theo bộ lọc (faceted navigation), Google khuyên dùng robots.txt để chặn các URL này khi bạn không cần chúng xuất hiện trên Google, vì chúng dễ tạo ra nội dung trùng lặp và làm bot tốn công vô ích.
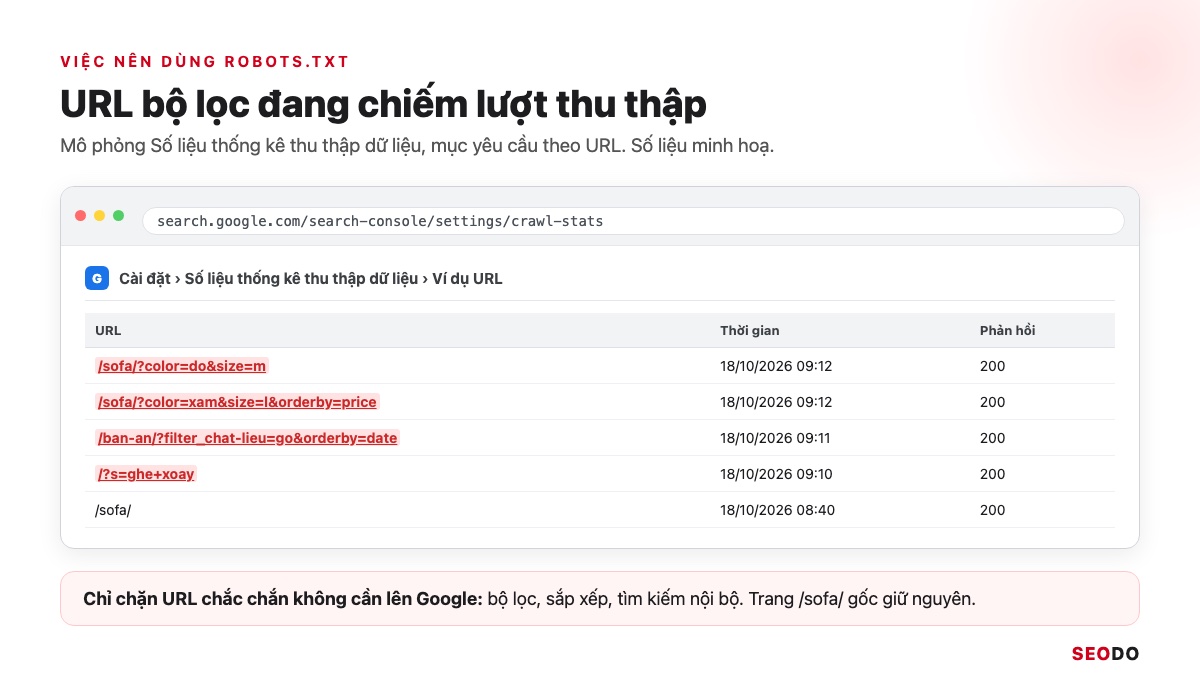
Thứ hai, chặn tệp đa phương tiện bạn không muốn hiện trên Google, chẳng hạn ảnh nội bộ hay video chỉ dành cho khách đã mua. Thứ ba, khai báo vị trí sitemap để mọi công cụ tìm kiếm tìm thấy nhanh hơn.
Tiêu chí của SEODO trước khi thêm một dòng Disallow rất đơn giản: mỗi URL bị chặn phải là URL bạn chắc chắn không cần xuất hiện trên Google. Robots.txt không dùng để giấu trang, không chặn tệp CSS, JavaScript cần để hiển thị trang, cũng không chặn URL đã chuyển hướng. Website lớn nhiều tham số mà chưa có người phụ trách kỹ thuật có thể dùng dịch vụ SEO tổng thể để rà tệp này cùng các lỗi thu thập khác.
2.2. 3 giới hạn Google nêu rõ
Google liệt kê 3 giới hạn của robots.txt. Thứ nhất, không phải trình thu thập nào cũng tuân theo tệp, nên thông tin cần bảo mật phải được khoá bằng mật khẩu trên máy chủ. Thứ hai, mỗi trình thu thập có thể hiểu cú pháp theo cách riêng. Thứ ba, trang bị chặn vẫn có thể được lập chỉ mục nếu có trang khác liên kết tới.
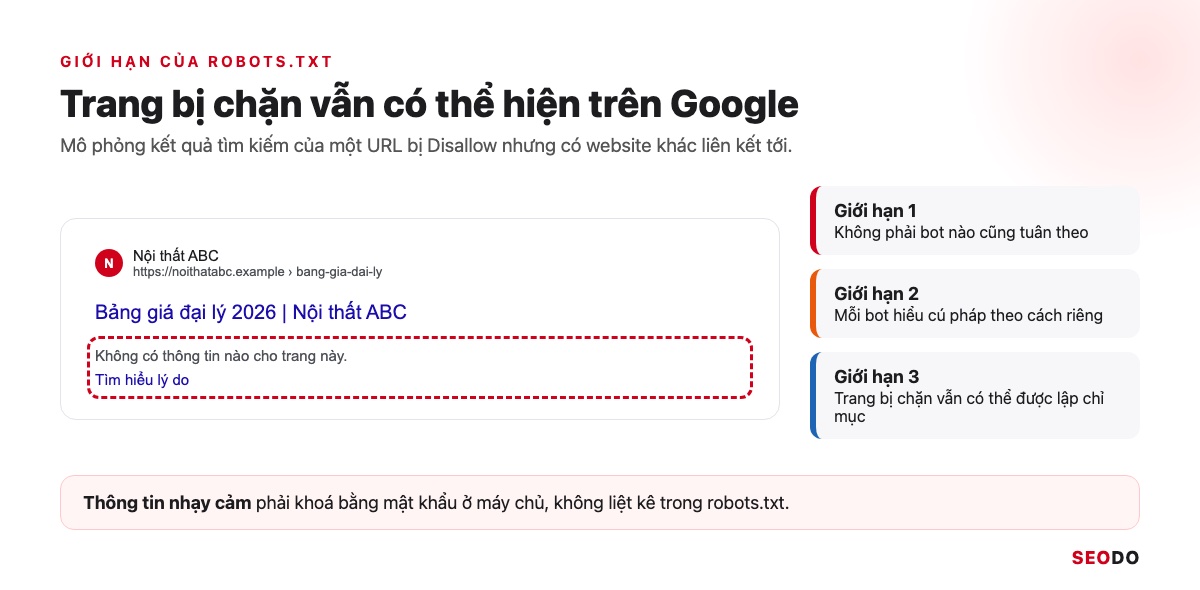
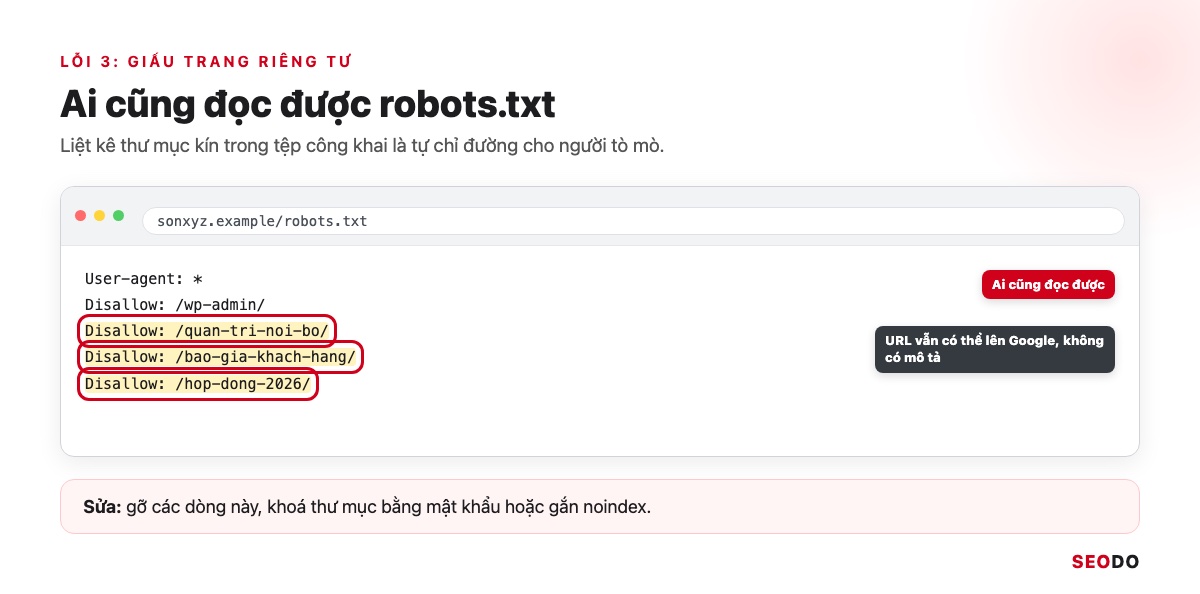
Không nên dùng robots.txt để bảo vệ thông tin nhạy cảm. Robots.txt là tệp công khai, ai cũng mở được, nên liệt kê /quan-tri-noi-bo/ trong đó là cho người lạ biết thư mục đó tồn tại. Thư mục cần giữ kín nên được bảo vệ thư mục bằng mật khẩu ở máy chủ.
3. Cú pháp robots.txt chuẩn theo tài liệu Google
Nắm 4 trường Google hỗ trợ và vài quy tắc đọc tệp là đủ để bạn tự viết, tự sửa robots.txt mà không phải đoán.
Một tệp robots.txt gồm các nhóm quy tắc, mỗi nhóm bắt đầu bằng User-agent và có ít nhất một dòng Disallow hoặc Allow.
- 4 trường Google hỗ trợ: user-agent, allow, disallow, sitemap.
- 2 ký tự đại diện: dấu * khớp 0 hoặc nhiều ký tự, dấu $ đánh dấu cuối URL.
- Giới hạn tệp: văn bản thuần UTF-8, Google bỏ qua phần vượt quá 500 KiB.
- Lệnh bị bỏ qua: crawl-delay, noindex, nofollow trong robots.txt không có tác dụng với Google.
Đường dẫn trong Allow, Disallow phân biệt chữ hoa, chữ thường, còn tên trường thì không.
Một tệp robots.txt gồm một hoặc nhiều nhóm. Mỗi nhóm bắt đầu bằng dòng User-agent cho biết nhóm áp dụng cho bot nào, tiếp theo là các dòng Disallow hoặc Allow. Dòng Sitemap đứng riêng, không thuộc nhóm nào. Theo đặc tả, Google chỉ hỗ trợ 4 trường: user-agent, allow, disallow và sitemap. Ví dụ đơn giản sau lấy từ tài liệu Create and submit a robots.txt file, viết lại với tên miền ví dụ.
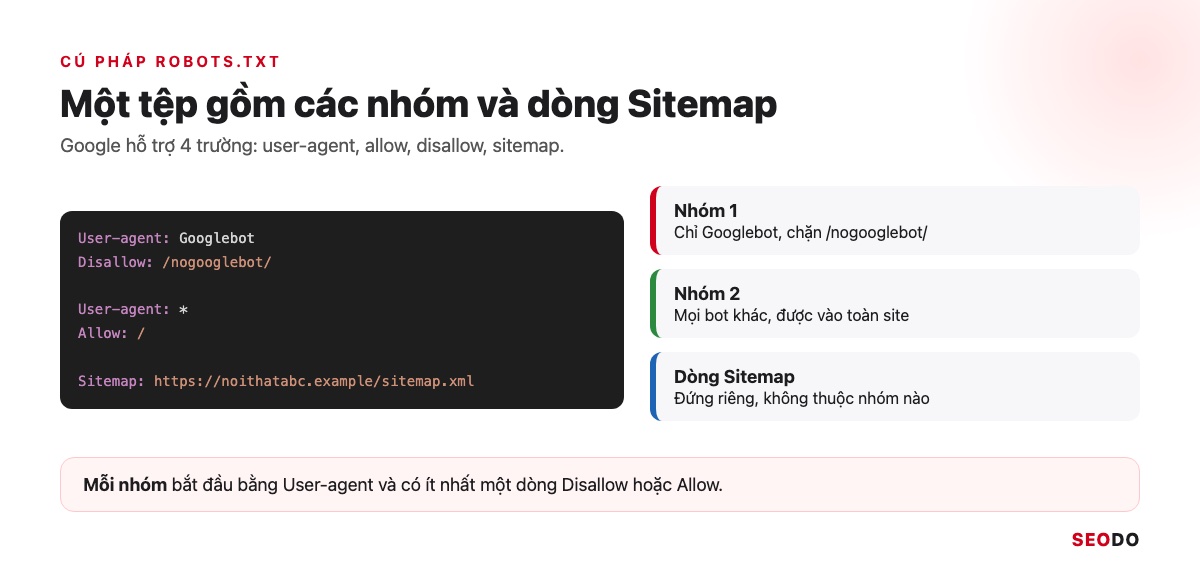
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /

Sitemap: https://noithatabc.example/sitemap.xml
Tệp này chặn Googlebot khỏi /nogooglebot/, cho mọi bot khác thu thập toàn bộ website và khai báo vị trí sitemap. Bảng dưới tóm tắt 4 trường.
| Trường | Bắt buộc | Giá trị | Ví dụ |
| User-agent | Có, ít nhất 1 dòng mỗi nhóm | Tên bot hoặc dấu * | User-agent: Googlebot |
| Disallow | Mỗi nhóm cần ít nhất 1 Disallow hoặc Allow | Đường dẫn bắt đầu bằng / | Disallow: /wp-admin/ |
| Allow | Không | Đường dẫn bắt đầu bằng / | Allow: /wp-admin/admin-ajax.php |
| Sitemap | Không | URL đầy đủ có https và tên miền | Sitemap: https://noithatabc.example/sitemap.xml |
3.1. User-agent: chọn bot áp dụng quy tắc
Mỗi nhóm có ít nhất 1 dòng User-agent, và bạn có thể viết nhiều dòng User-agent liền nhau để dùng chung một bộ quy tắc. Dấu * áp dụng cho mọi trình thu thập, trừ các bot AdsBot của Google, nên muốn chặn AdsBot bạn phải ghi đúng tên. Tên user-agent không phân biệt chữ hoa, chữ thường, nên googlebot và Googlebot là một.
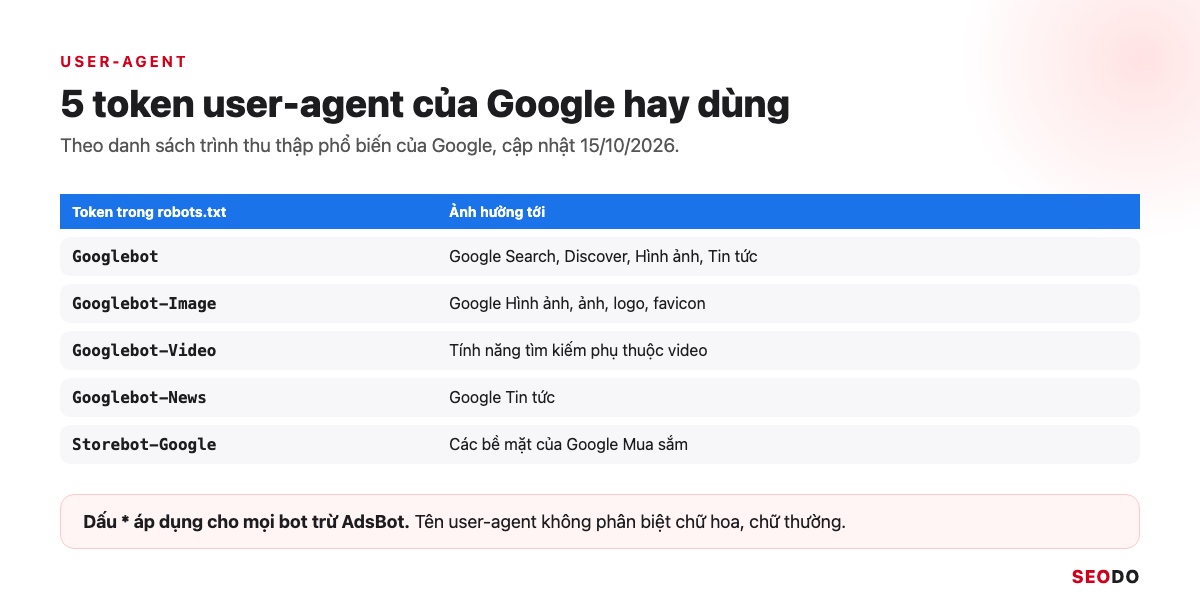
| Token | Ảnh hưởng tới |
| Googlebot | Google Search, Discover, Google Hình ảnh, Google Tin tức |
| Googlebot-Image | Google Hình ảnh và các tính năng hiển thị ảnh, logo, favicon |
| Googlebot-Video | Các tính năng tìm kiếm phụ thuộc video |
| Googlebot-News | Google Tin tức |
| Storebot-Google | Các bề mặt của Google Mua sắm |
3.2. Disallow và Allow: chặn và mở đường dẫn
Disallow cho biết đường dẫn bot không được vào, Allow mở lại một phần nằm trong vùng đã bị chặn. Theo Google, đường dẫn phải bắt đầu bằng dấu /, và nếu là thư mục thì nên kết thúc bằng dấu /. Riêng dòng Disallow để trống nghĩa là không chặn gì, ngược hẳn với Disallow: / là chặn toàn bộ website.
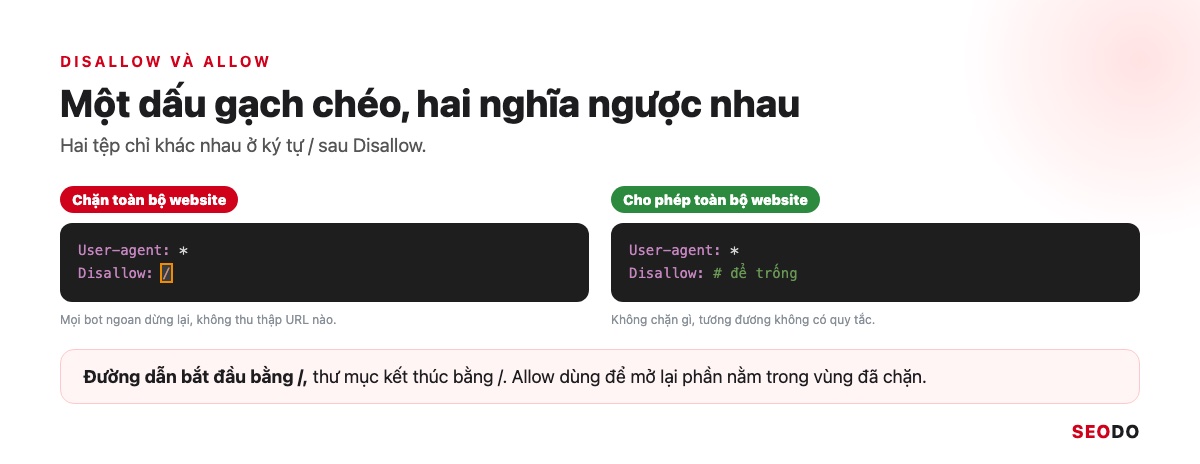
Bốn ví dụ dưới đây lấy theo trang Useful robots.txt rules của Google. Mỗi khối là một tệp riêng, không ghép chung.
# Ví dụ 1: chặn toàn bộ website với mọi bot
User-agent: *
Disallow: /

# Ví dụ 2: chặn một thư mục và mọi thứ bên trong
User-agent: *
Disallow: /tai-lieu-noi-bo/

# Ví dụ 3: chặn một trang
User-agent: *
Disallow: /cam-on.html

# Ví dụ 4: chặn toàn site, chỉ mở thư mục /public/
User-agent: *
Disallow: /
Allow: /public/
Ví dụ 4 chạy được nhờ quy tắc đường dẫn dài nhất thắng, sẽ nói kỹ ở phần 4.
3.3. Sitemap: khai báo sơ đồ trang web
Dòng Sitemap cho mọi công cụ tìm kiếm biết sơ đồ trang web nằm ở đâu. URL phải là URL đầy đủ, có giao thức và tên miền, vì Google không tự đoán các biến thể http, https hay có www. Bạn được khai báo nhiều dòng Sitemap, và vì dòng này không thuộc nhóm nào nên đặt ở đầu hay cuối tệp đều được.
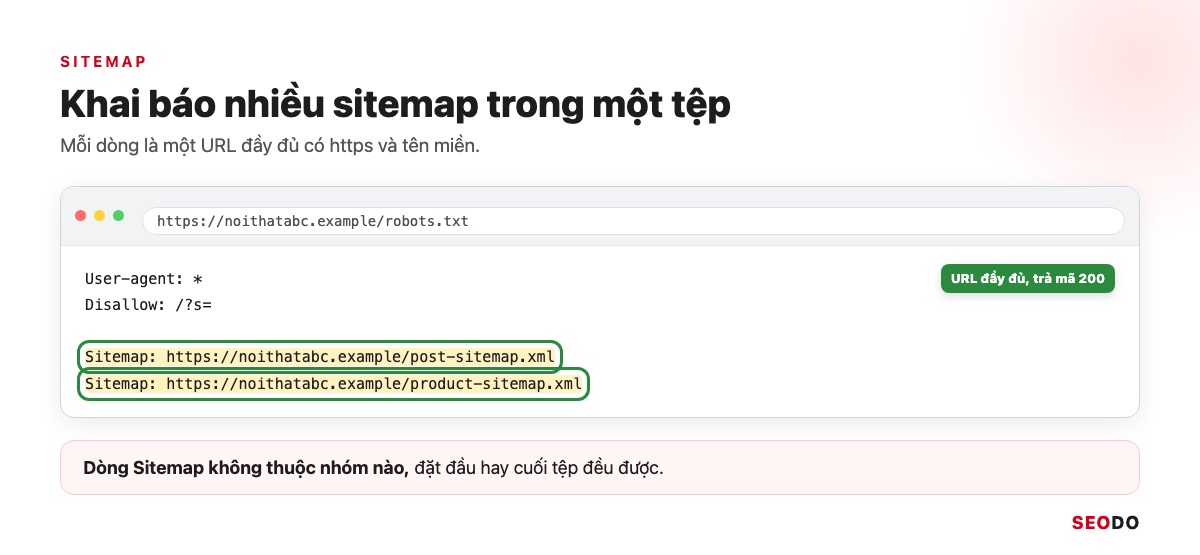
Dùng sitemap chỉ mục thì một dòng là đủ. Cách tạo sitemap và chọn URL nào đưa vào sitemap được hướng dẫn chi tiết trong bài sitemap, kèm cách khai báo lên Search Console.
3.4. Ký tự đại diện * và $
Google hỗ trợ 2 ký tự đại diện. Dấu * khớp 0 hoặc nhiều ký tự bất kỳ, còn dấu $ đánh dấu cuối URL. Mọi trường trừ sitemap đều dùng được dấu *, và dấu * đặt ở cuối đường dẫn bị bỏ qua, nên /fish* và /fish có nghĩa như nhau. Hai quy tắc dưới đây hay dùng nhất trên website bán hàng.
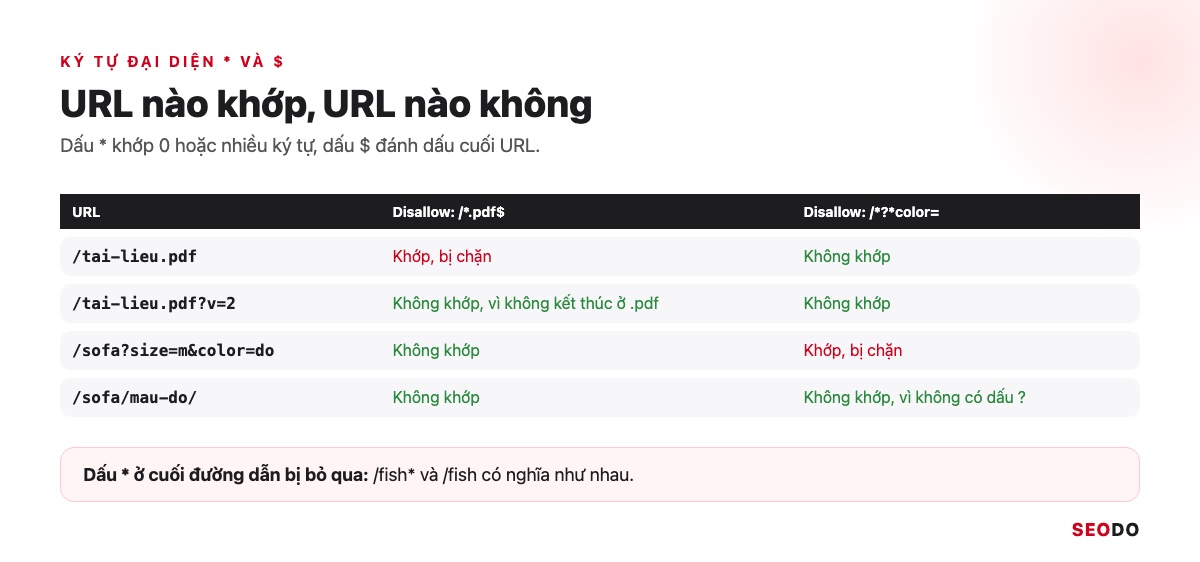
User-agent: *
Disallow: /*.pdf$
Disallow: /*?*color=
Quy tắc thứ nhất chặn mọi URL kết thúc bằng .pdf, như /tai-lieu.pdf. Nhưng /tai-lieu.pdf?v=2 thì không khớp, vì sau .pdf còn có tham số nên URL không kết thúc ở đó. Quy tắc thứ hai chặn mọi URL có tham số color, như /sofa?color=do hay /sofa?size=m&color=do, còn /sofa/mau-do/ không bị ảnh hưởng vì không có dấu hỏi.
3.5. Chữ hoa, chữ thường và dòng chú thích
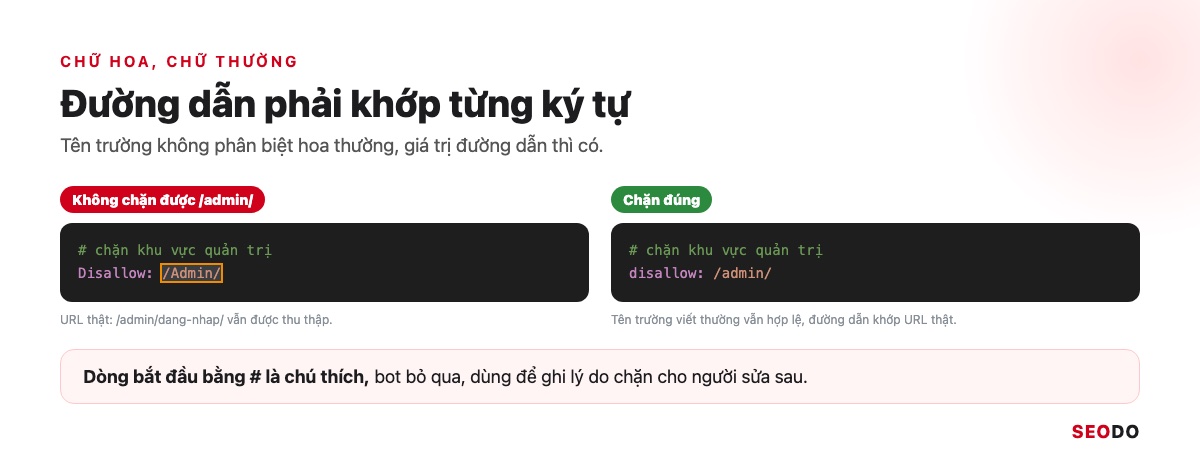
Tên trường như User-agent hay Disallow không phân biệt chữ hoa, chữ thường. Nhưng giá trị đường dẫn thì có phân biệt, nên Disallow: /Admin/ không chặn /admin/. Đây là lỗi rất khó phát hiện bằng mắt, vì tệp trông vẫn đúng. Dòng bắt đầu bằng dấu # là chú thích, bot bỏ qua, nên bạn có thể ghi lý do chặn ngay trong tệp cho người sửa sau.
3.6. Giới hạn 500 KiB, mã hoá UTF-8 và dòng không hợp lệ
Robots.txt phải là tệp văn bản thuần mã hoá UTF-8. Google bỏ qua toàn bộ nội dung vượt quá 500 KiB, tức khoảng 512.000 byte. Dòng không hợp lệ, kể cả ký tự BOM ở đầu tệp, cũng bị bỏ qua. Google vẫn dùng các dòng còn đọc được. Website thông thường chỉ cần tệp vài trăm byte, nên giới hạn này thường chỉ chạm tới khi ai đó liệt kê từng URL một.
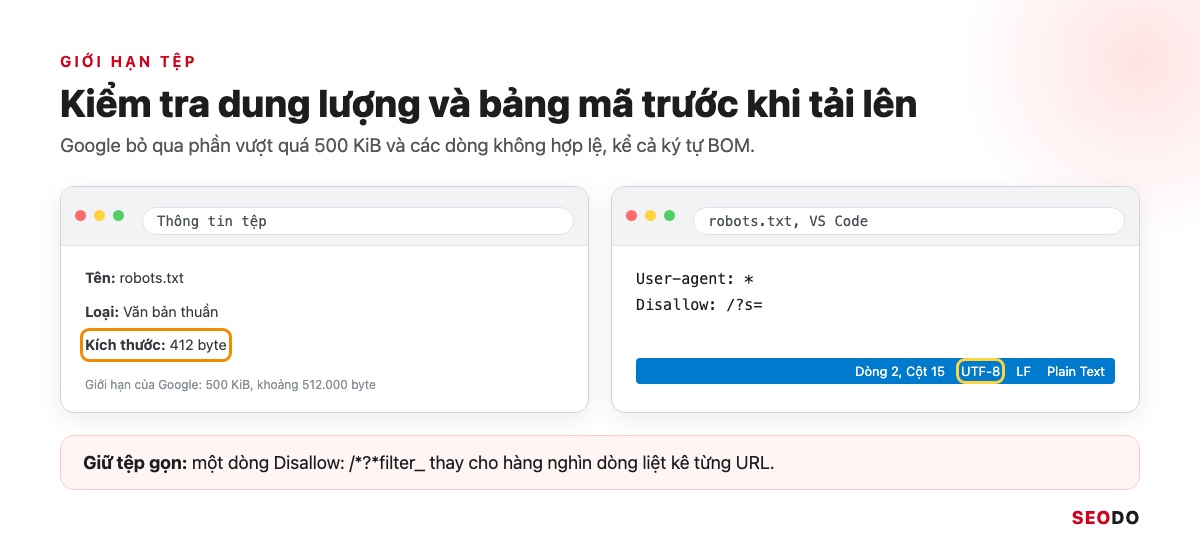
Cách giữ tệp gọn là gộp quy tắc bằng ký tự đại diện. Một dòng Disallow: /*?*filter_ làm được việc của 2.000 dòng Disallow cho 2.000 URL bộ lọc.
3.7. Lệnh Google không hỗ trợ: crawl-delay, noindex, nofollow
Nhiều mẫu robots.txt trên mạng vẫn có dòng Crawl-delay hay Noindex. Theo đặc tả, Google không hỗ trợ crawl-delay. Từ 01/09/2019, Google cũng ngừng xử lý noindex, nofollow viết trong robots.txt, theo thông báo trên Search Central Blog tháng 07/2019. Các dòng này không gây lỗi, Google chỉ bỏ qua.
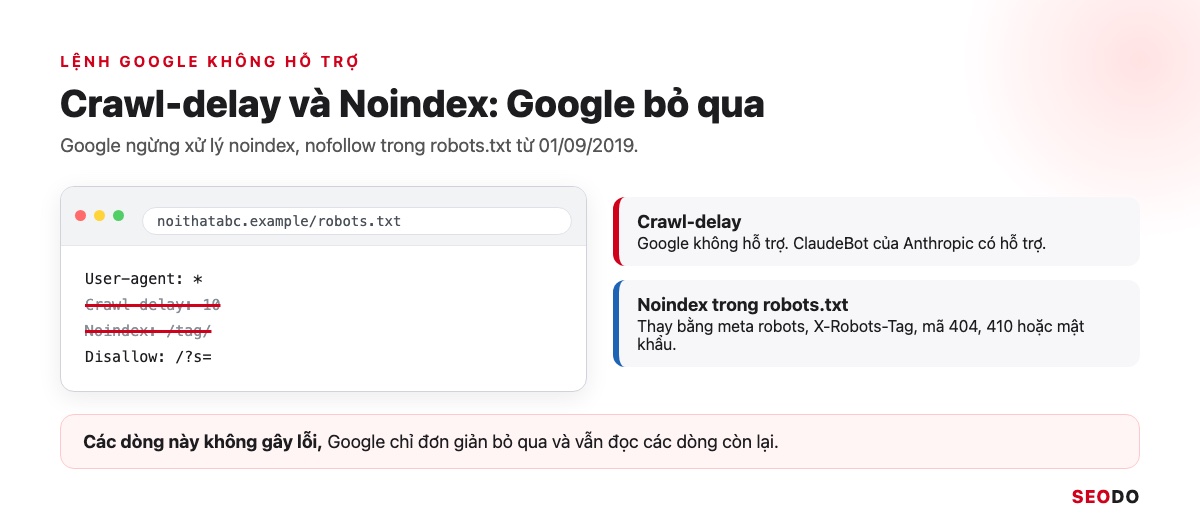
User-agent: *
Crawl-delay: 10
Noindex: /tag/
Muốn trang không được lập chỉ mục, bạn dùng thẻ meta robots noindex, header X-Robots-Tag, mã 404 hoặc 410, hay đặt mật khẩu. Riêng crawl-delay vẫn có bot khác hỗ trợ. Ví dụ Anthropic ghi trong trang trợ giúp rằng ClaudeBot tôn trọng phần mở rộng Crawl-delay, nên dòng này chỉ có ích khi đặt trong nhóm của đúng bot đó.
4. Google đọc quy tắc robots.txt theo thứ tự ưu tiên nào?
Hiểu thứ tự ưu tiên giúp bạn đoán đúng kết quả khi trong tệp có nhiều nhóm và nhiều quy tắc chồng lên nhau.
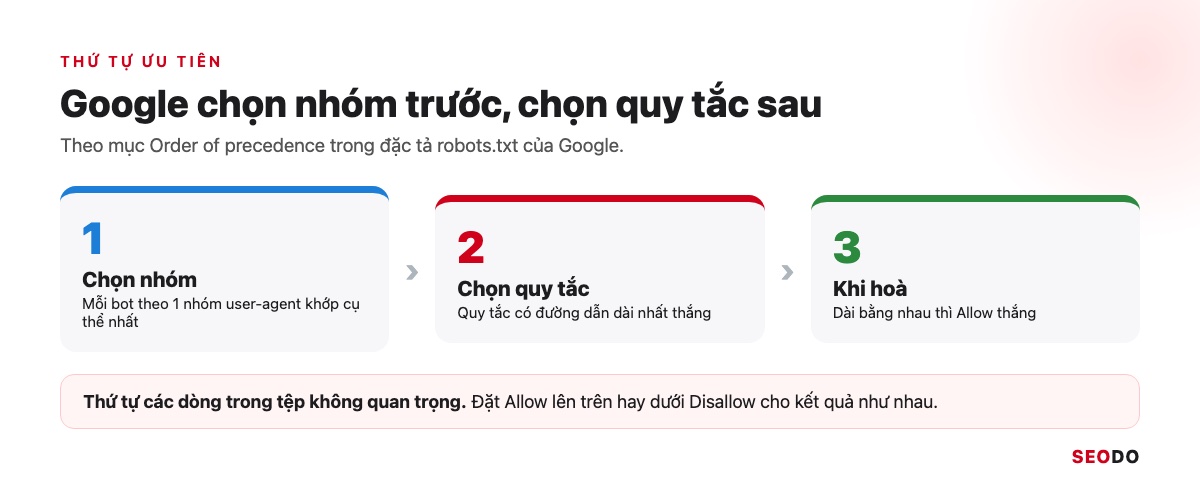
Google không đọc tệp từ trên xuống rồi dừng ở dòng đầu tiên khớp. Thứ tự ưu tiên gồm 2 tầng:
- Tầng nhóm: mỗi bot chỉ theo 1 nhóm có user-agent khớp cụ thể nhất, các nhóm khác bị bỏ qua.
- Tầng quy tắc: trong nhóm đó, quy tắc có đường dẫn dài nhất thắng.
- Khi hoà: 2 quy tắc dài bằng nhau thì quy tắc ít hạn chế hơn, tức Allow, thắng.
Thứ tự các nhóm và các dòng trong tệp không ảnh hưởng tới kết quả.
Theo mục Order of precedence trong đặc tả robots.txt của Google, mỗi bot chỉ theo một nhóm user-agent khớp cụ thể nhất. Trong nhóm đó, quy tắc có đường dẫn dài nhất thắng, nếu dài bằng nhau thì quy tắc ít hạn chế hơn là Allow thắng. Vì vậy, đặt dòng nào lên trước không làm thay đổi kết quả.
Bảng dưới gom 3 tình huống hay gây tranh cãi nhất khi tôi rà tệp cùng khách hàng. Ba H3 tiếp theo giải thích từng tầng.
| Quy tắc trong tệp | URL | Kết quả | Vì sao |
| Disallow: /blog/ và Allow: /blog/huong-dan/ | /blog/huong-dan/robots-txt/ | Được thu thập | Allow dài 16 ký tự, Disallow dài 6 ký tự |
| Allow: /trang và Disallow: /trang | /trang | Được thu thập | Dài bằng nhau nên Allow thắng |
| Nhóm * chặn /wp-admin/, nhóm Googlebot chỉ chặn /tam/ | /wp-admin/ với Googlebot | Được thu thập | Googlebot chỉ theo nhóm Googlebot, bỏ qua nhóm * |
4.1. Nhóm user-agent cụ thể nhất được dùng
Khi có nhóm riêng cho một bot, bot đó bỏ qua hoàn toàn nhóm *. Ví dụ tệp có nhóm Googlebot-Image thì Googlebot-Image chỉ đọc nhóm đó. Nhiều nhóm cùng ghi một user-agent sẽ được gộp lại thành một, nhưng nhóm cụ thể và nhóm * thì không bao giờ gộp. Thứ tự các nhóm trong tệp không ảnh hưởng gì.
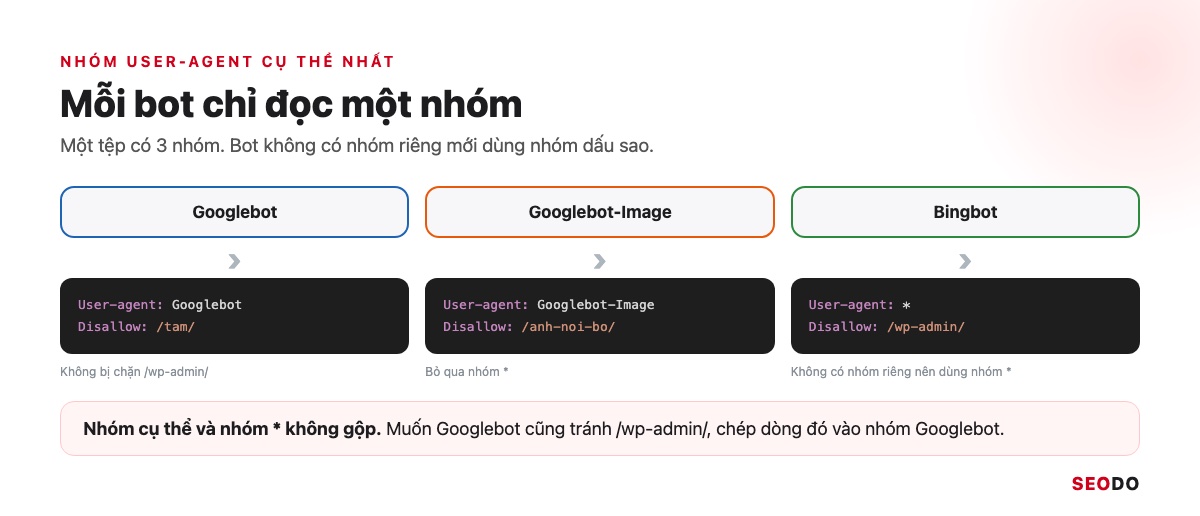
User-agent: *
Disallow: /wp-admin/

User-agent: Googlebot
Disallow: /tam/
Ở ví dụ này, Googlebot không bị chặn khỏi /wp-admin/. Nó đã có nhóm riêng nên chỉ bị chặn ở /tam/. Thêm nhóm Googlebot để chặn một thư mục là cách vô tình mở hết những gì nhóm * đang chặn. Muốn Googlebot cũng tránh /wp-admin/, bạn phải chép dòng đó vào nhóm Googlebot.
4.2. Quy tắc có đường dẫn dài nhất thắng
Trong cùng một nhóm, Google so độ dài đường dẫn của mọi quy tắc khớp với URL và chọn quy tắc dài nhất. Với URL /blog/huong-dan/robots-txt/, dòng Allow: /blog/huong-dan/ dài 16 ký tự nên thắng dòng Disallow: /blog/ chỉ dài 6 ký tự. Khi hai quy tắc dài bằng nhau, như Allow: /trang và Disallow: /trang, Google chọn quy tắc ít hạn chế hơn là Allow.
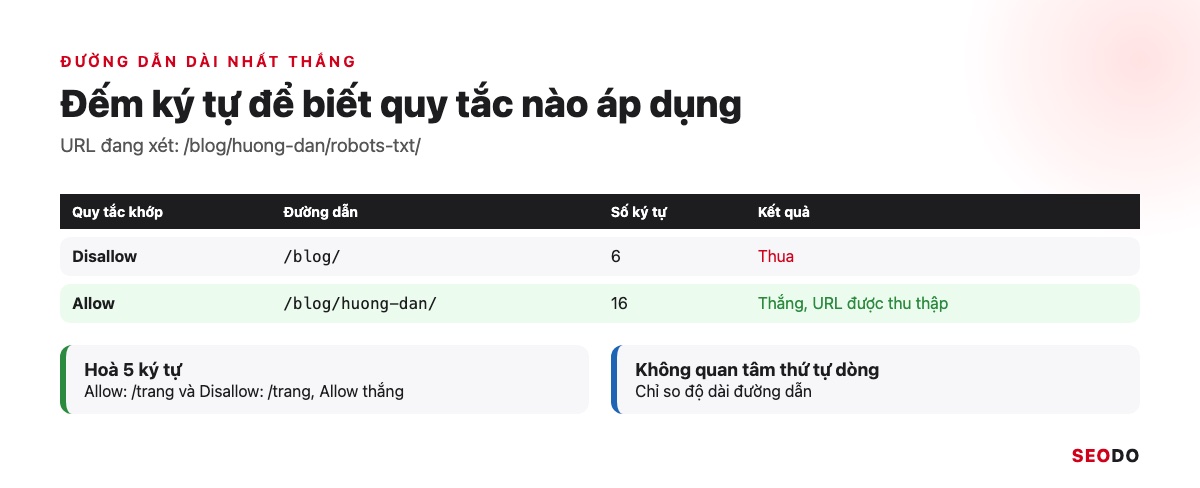
# Ví dụ 1: Allow dài hơn nên thắng
User-agent: *
Disallow: /blog/
Allow: /blog/huong-dan/

# Ví dụ 2: dài bằng nhau nên Allow thắng
User-agent: *
Allow: /trang
Disallow: /trang
4.3. Tự kiểm tra một URL có bị chặn không
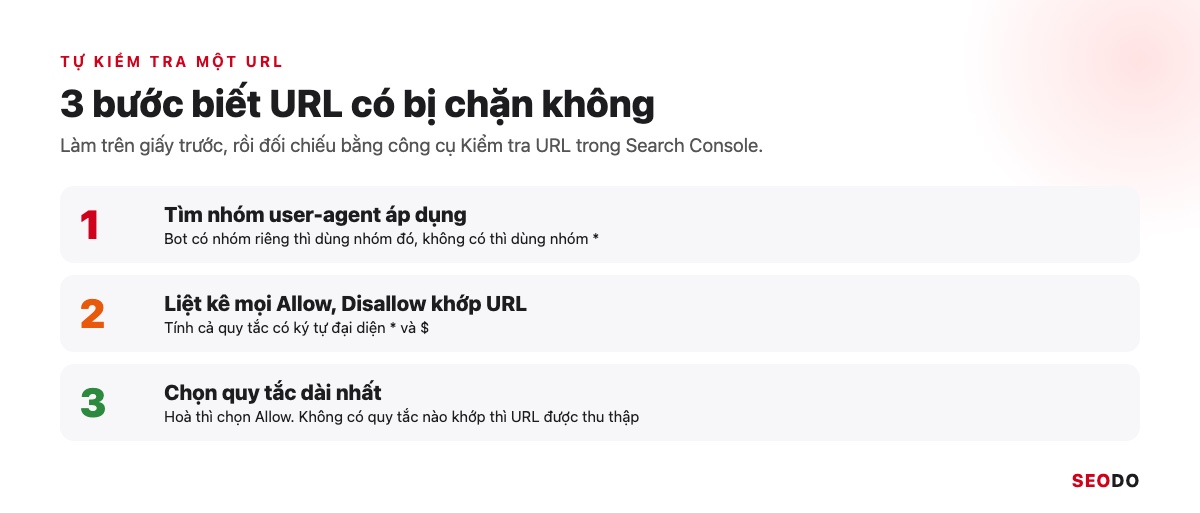
Khi nghi một URL bị chặn, bạn đi qua 3 bước. Bước 1, tìm nhóm user-agent áp dụng cho bot đang xét. Bước 2, liệt kê mọi dòng Allow và Disallow trong nhóm đó có đường dẫn khớp với URL. Bước 3, chọn quy tắc dài nhất, nếu hoà thì chọn Allow. Kết quả tự đoán xong nên được đối chiếu bằng công cụ Kiểm tra URL của Search Console ở phần 9.
5. Cách tạo file robots.txt và đưa lên website
Bốn bước sau đi từ kiểm tra tệp hiện có đến tải tệp mới lên hosting.
Tạo robots.txt gồm 4 bước theo tài liệu của Google:
- Kiểm tra: mở tên miền kèm /robots.txt để biết website đã có tệp chưa.
- Viết tệp: dùng trình soạn thảo văn bản thuần, lưu UTF-8.
- Tải lên: đặt tệp ở thư mục gốc của tên miền.
- Kiểm tra lại: mở tệp ở cửa sổ ẩn danh rồi báo Google tải lại nếu cần.
Google tự cập nhật bản lưu khoảng mỗi 24 giờ, bạn không phải gửi tệp ở đâu cả.
Google mô tả 4 bước tạo tệp trong tài liệu Create and submit a robots.txt file: tạo tệp tên robots.txt, thêm quy tắc, tải lên thư mục gốc và kiểm tra. Bạn có thể dùng công cụ tạo tệp tự động để có bản nháp nhanh, nhưng vẫn phải đọc lại từng dòng theo cú pháp ở phần 3, vì công cụ không biết cấu trúc URL thật của website.
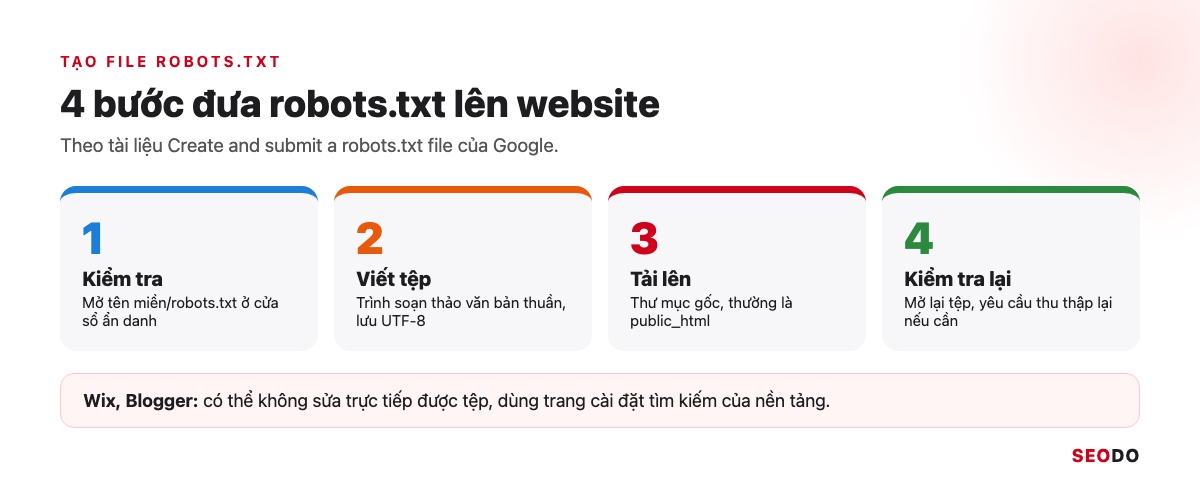
Nếu website chạy trên nền tảng như Wix hay Blogger, bạn có thể không sửa trực tiếp được tệp. Google khuyên dùng trang cài đặt tìm kiếm của nền tảng đó để ẩn hoặc hiện trang thay cho việc sửa robots.txt.
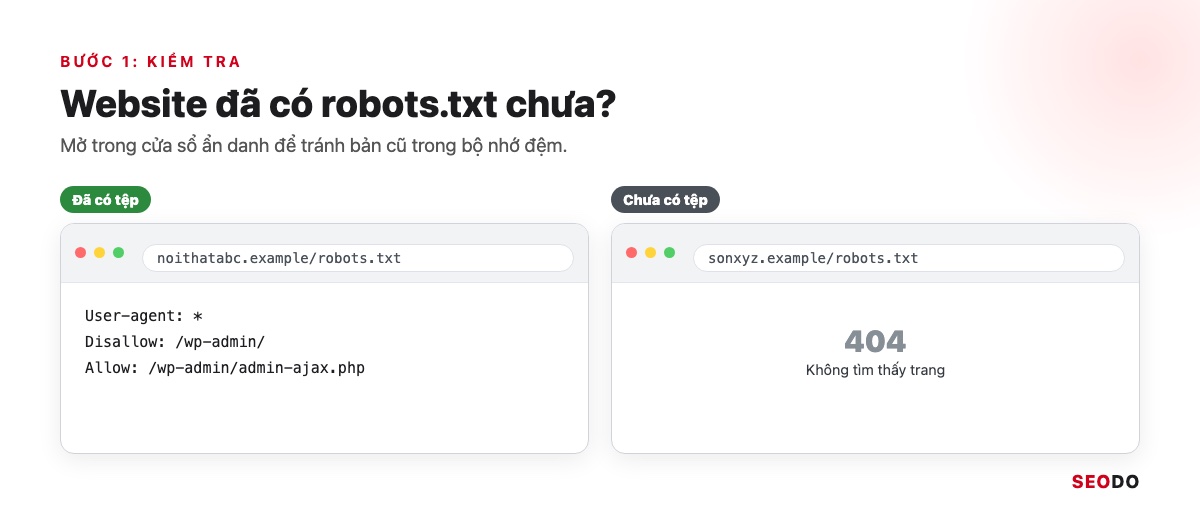
5.1. Bước 1: Kiểm tra website đã có robots.txt chưa
Mở https://noithatabc.example/robots.txt trong cửa sổ ẩn danh, thay bằng tên miền của bạn. Trình duyệt hiện các dòng chữ như User-agent, Disallow nghĩa là website đã có tệp. Nếu trang báo 404 thì chưa có. Dùng cửa sổ ẩn danh để tránh trình duyệt hiện bản cũ còn lưu trong bộ nhớ đệm.
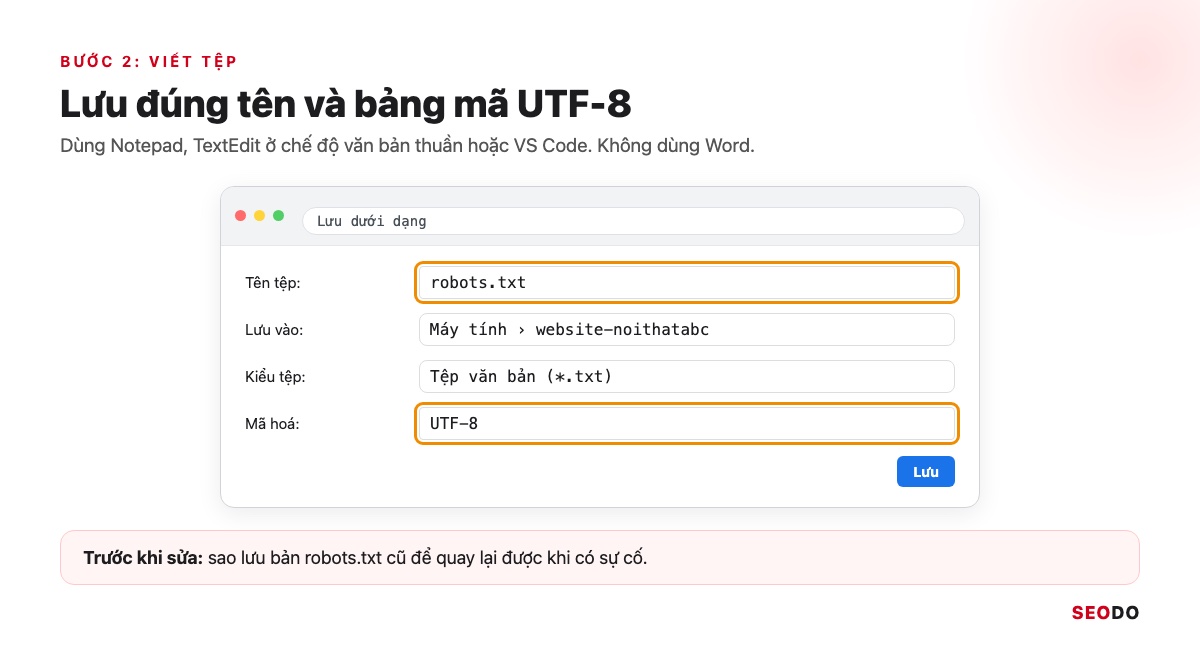
5.2. Bước 2: Viết tệp bằng trình soạn thảo văn bản
Dùng Notepad, TextEdit ở chế độ văn bản thuần, hoặc VS Code để viết tệp, lưu với bảng mã UTF-8 và tên robots.txt. Không dùng Word hay Google Docs, vì chúng có thể chèn định dạng và ký tự lạ làm hỏng dòng. Website đã có tệp thì sao lưu bản cũ trước khi sửa để quay lại được khi có sự cố.
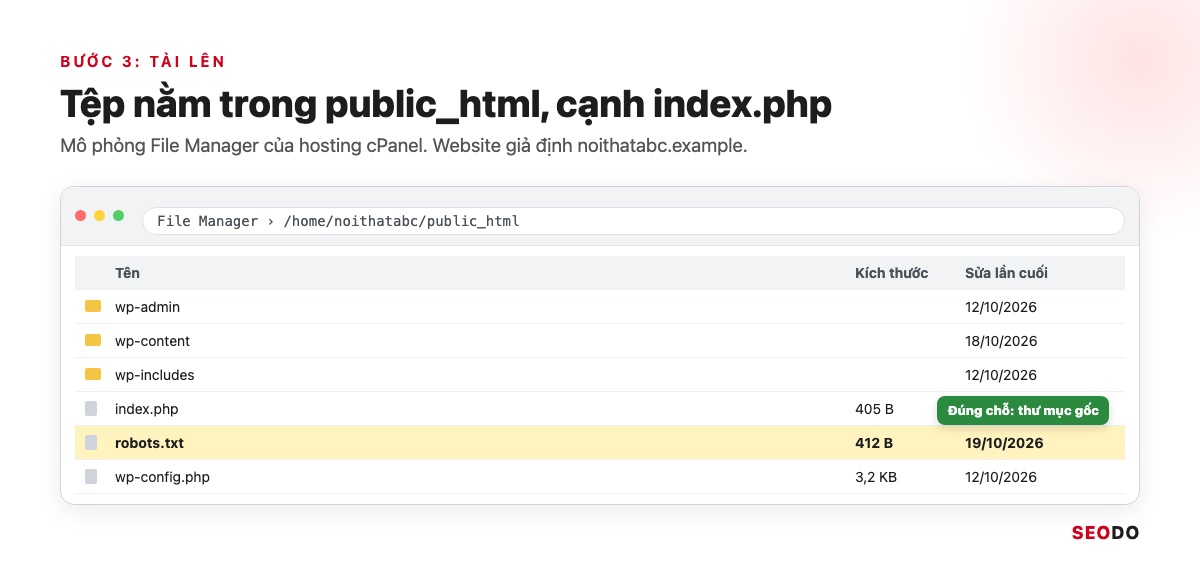
5.3. Bước 3: Tải tệp lên thư mục gốc
Tệp phải nằm ở thư mục gốc của tên miền, trên hosting dùng cPanel thường là thư mục public_html, cùng chỗ với tệp index.php. Đặt trong thư mục con như /blog/ thì bot không đọc. Bạn tải lên bằng File Manager của hosting hoặc phần mềm FTP. Không có quyền truy cập hosting thì nhờ người quản trị tên miền làm bước này.
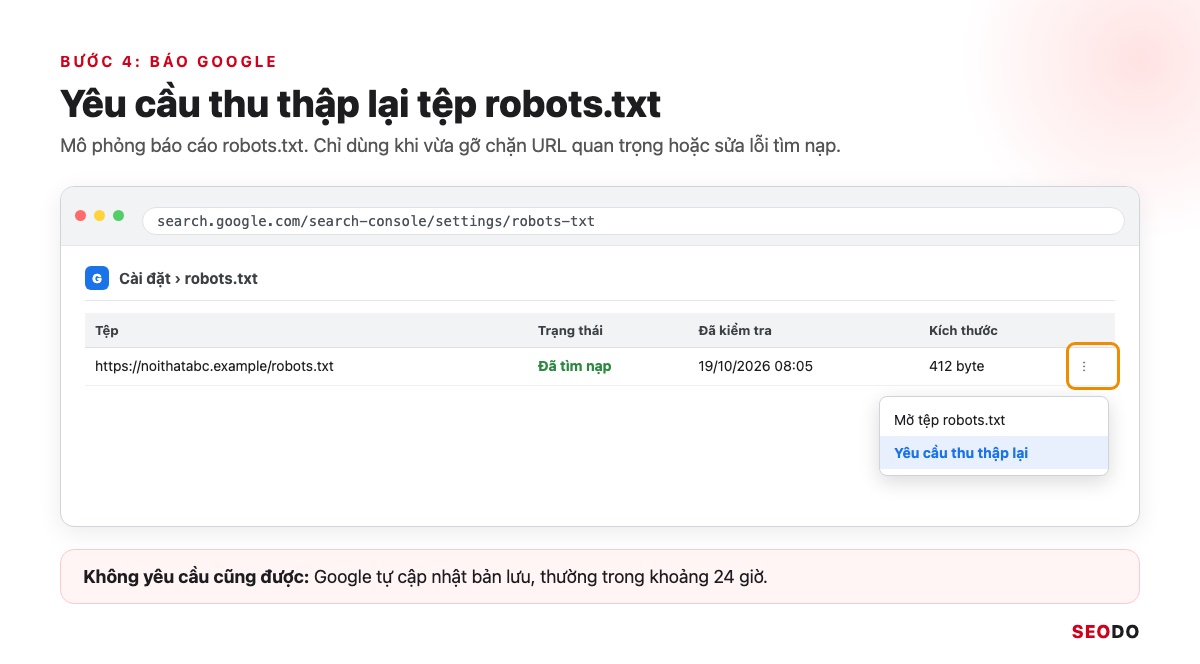
5.4. Bước 4: Kiểm tra công khai và báo Google
Mở lại URL tệp ở cửa sổ ẩn danh, thấy nội dung mới là tệp đã công khai. Google tự tìm tệp và cập nhật bản lưu, thường trong khoảng 24 giờ, nên bạn không cần gửi tệp ở đâu. Vừa gỡ chặn một URL quan trọng và cần Google biết sớm hơn thì bấm Yêu cầu thu thập lại trong báo cáo robots.txt, cách làm có ở phần 9.
6. Mẫu robots.txt chuẩn SEO cho WordPress
Ba mẫu dưới đây đi từ bản mặc định đến website bán hàng, mỗi dòng có lý do để bạn biết nên giữ hay bỏ.
WordPress tự tạo một robots.txt ảo, website thường chỉ cần thêm dòng Sitemap và chặn trang tìm kiếm nội bộ.
- Bản ảo mặc định: chặn /wp-admin/, mở lại /wp-admin/admin-ajax.php.
- Website doanh nghiệp, blog: thêm 2 dòng chặn trang tìm kiếm và 1 dòng Sitemap.
- Website bán hàng: thêm các dòng chặn tham số bộ lọc, sắp xếp, giỏ hàng.
- Không chặn: /wp-content/, /wp-includes/ hay thư mục chứa CSS, JavaScript.
Các mẫu là bản tham khảo, cần đối chiếu cấu trúc URL thật của website trước khi dùng.
WordPress tự sinh một robots.txt ảo khi trên máy chủ không có tệp thật. Thường thì việc cần làm chỉ là thêm dòng Sitemap và chặn trang tìm kiếm nội bộ. Các mẫu dưới đây là mẫu tham khảo, bạn cần đối chiếu cấu trúc URL thật của website trước khi dùng, vì mỗi theme và plugin đặt tên đường dẫn khác nhau.
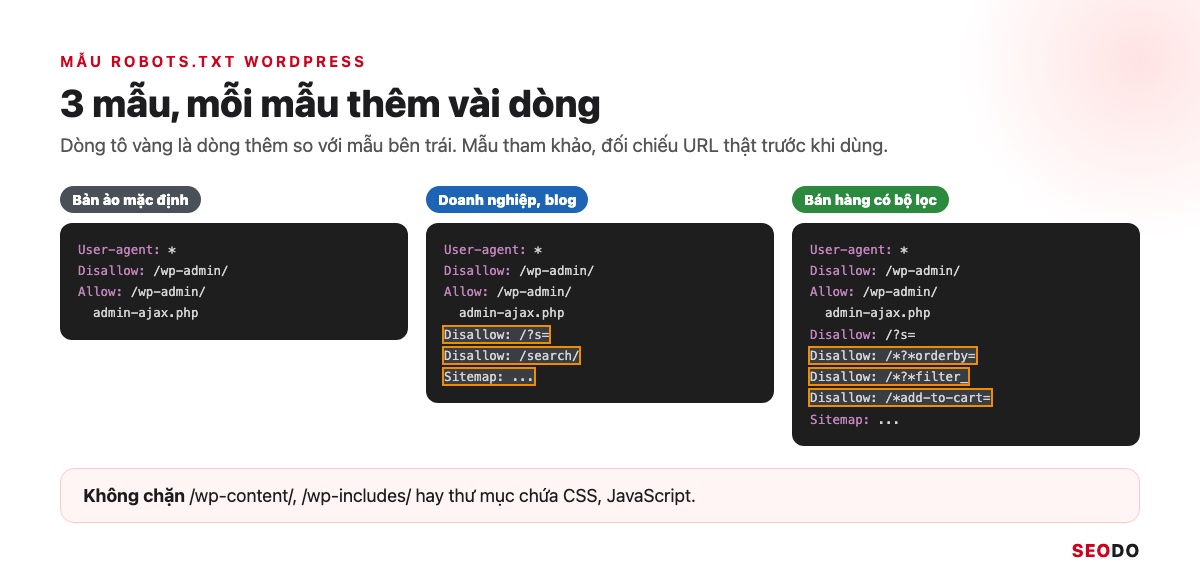
Tôi luôn dặn đội SEODO không chép mẫu cũ có dòng Disallow: /wp-includes/ hay Disallow: /wp-content/. Hai thư mục này chứa CSS, JavaScript và ảnh mà Google cần để hiển thị trang. Chặn chúng, Google sẽ thấy trang như một khung trắng thiếu bố cục.
6.1. Robots.txt ảo mặc định của WordPress
Theo tài liệu hàm do_robots() của WordPress, bản ảo mặc định gồm 3 dòng như khối dưới. Dòng Allow mở lại admin-ajax.php vì nhiều theme, plugin gọi tệp này từ phía người xem. Bạn có thể thấy thêm dòng Sitemap do WordPress hoặc plugin SEO tự thêm, nên cứ mở /robots.txt thật để xem chính xác website của bạn đang có gì.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
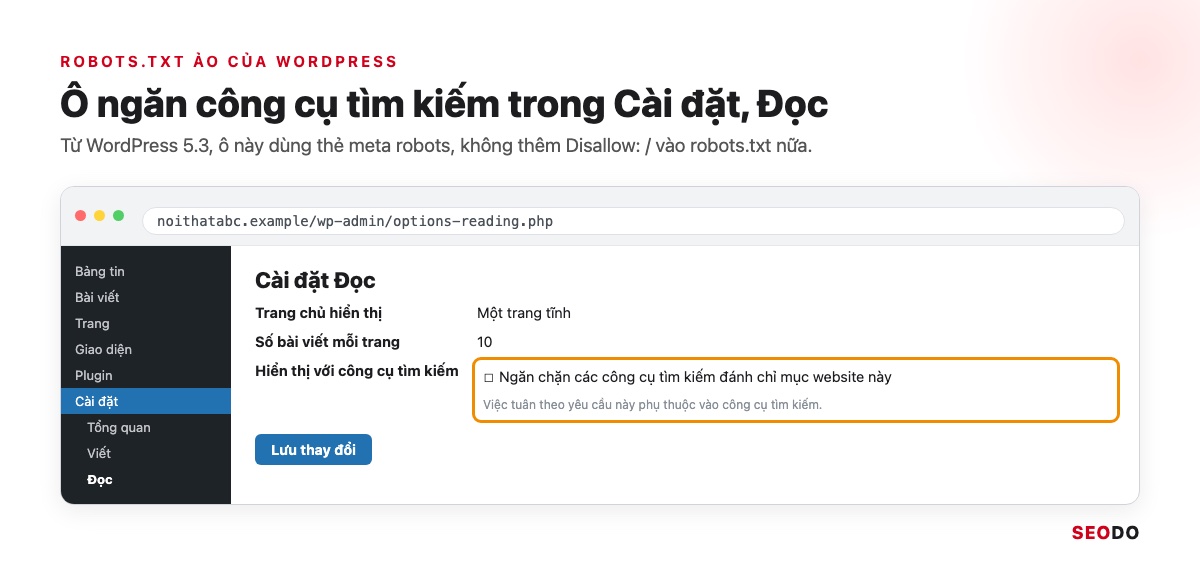
Từ WordPress 5.3, khi bật ô “Ngăn chặn các công cụ tìm kiếm đánh chỉ mục website này” trong Cài đặt, Đọc, WordPress không còn thêm Disallow: / mà dùng thẻ meta robots trên từng trang. Nếu thư mục gốc có tệp robots.txt thật, tệp thật được dùng và bản ảo không còn hiện ra nữa.
6.2. Mẫu cho website doanh nghiệp, blog
Mẫu này dành cho website giới thiệu dịch vụ hoặc blog dùng WordPress kèm plugin SEO tạo sitemap. Tiêu chí đạt gồm 3 điều: tệp có đúng 1 nhóm *, không chặn thư mục tài nguyên, và URL sitemap khi mở ra trả mã 200. Đường dẫn sitemap khác nhau theo plugin, nên kiểm tra trước khi điền.
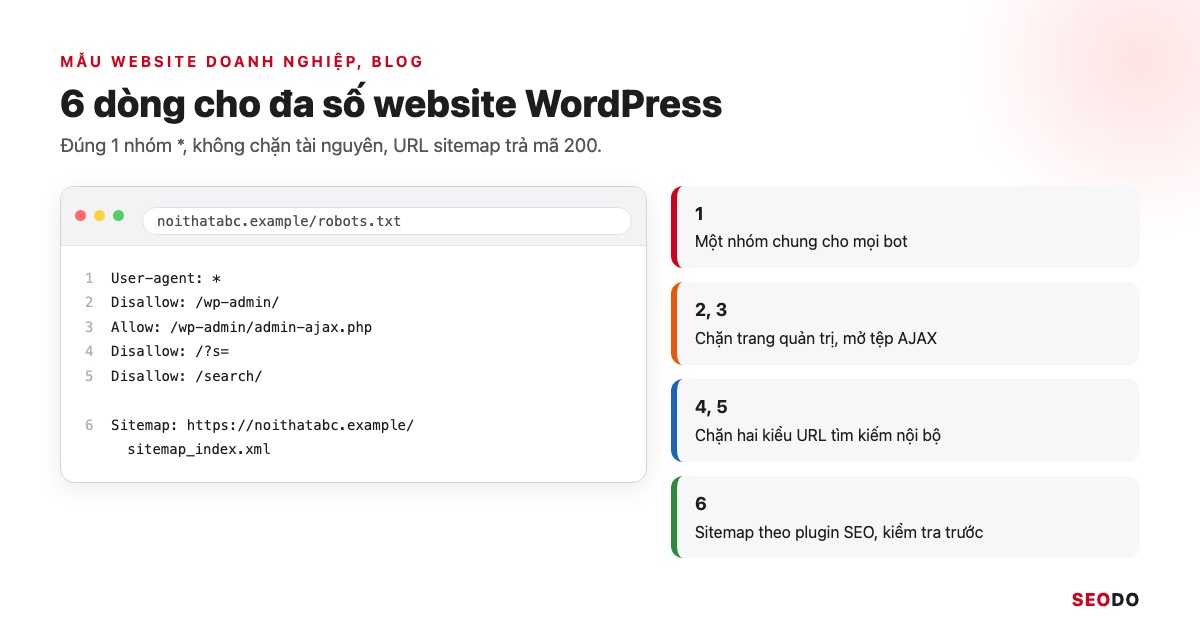
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://noithatabc.example/sitemap_index.xml| Dòng | Ý nghĩa | Vì sao |
| User-agent: * | Áp dụng cho mọi bot, trừ AdsBot | Một nhóm chung là đủ, ít nhóm thì ít lỗi ưu tiên |
| Disallow: /wp-admin/ | Chặn khu vực quản trị | Trang quản trị không có giá trị tìm kiếm |
| Allow: /wp-admin/admin-ajax.php | Mở lại tệp xử lý AJAX | Theme, plugin cần tệp này để hiển thị đúng |
| Disallow: /?s= | Chặn URL tìm kiếm nội bộ dạng tham số | Mỗi từ khoá tìm kiếm sinh ra một URL mới |
| Disallow: /search/ | Chặn URL tìm kiếm dạng thư mục | Một số theme dùng kiểu đường dẫn này |
| Sitemap: … | Khai báo sitemap chỉ mục | Giúp mọi công cụ tìm kiếm tìm thấy sitemap |
6.3. Mẫu cho website bán hàng có bộ lọc sản phẩm
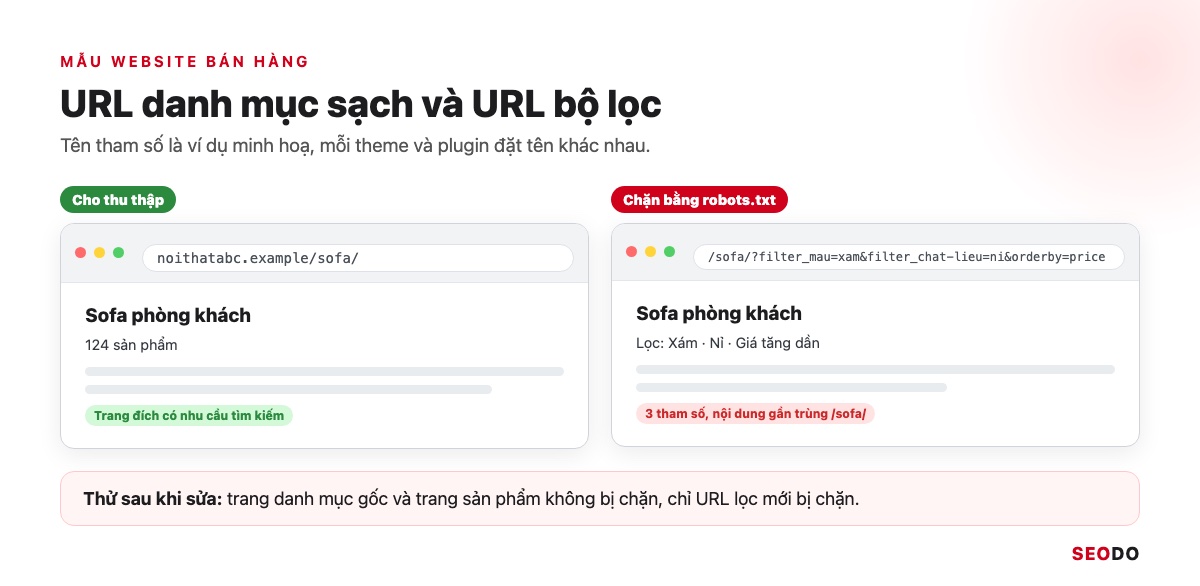
Website bán hàng sinh ra rất nhiều URL từ bộ lọc, sắp xếp và nút thêm vào giỏ. Mẫu dưới thêm các dòng chặn tham số theo cách Google gợi ý trong tài liệu faceted navigation. Tên tham số chỉ là ví dụ minh hoạ, mỗi theme và plugin đặt tên khác nhau, nên bạn phải xem URL thật của website trước khi chép.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /*?*orderby=
Disallow: /*?*filter_
Disallow: /*add-to-cart=

Sitemap: https://noithatabc.example/sitemap_index.xml
Trước khi chặn tham số, SEODO mở báo cáo Số liệu thống kê thu thập dữ liệu trong Search Console hoặc nhật ký máy chủ. Chỉ chặn tham số chiếm nhiều lượt thu thập mà không có trang đích nào cần lên Google. Thêm dòng xong, bạn thử ngay 3 URL bằng công cụ Kiểm tra URL: một trang danh mục gốc, một trang sản phẩm và một URL lọc. Hai URL đầu phải không bị chặn, URL cuối mới bị chặn.
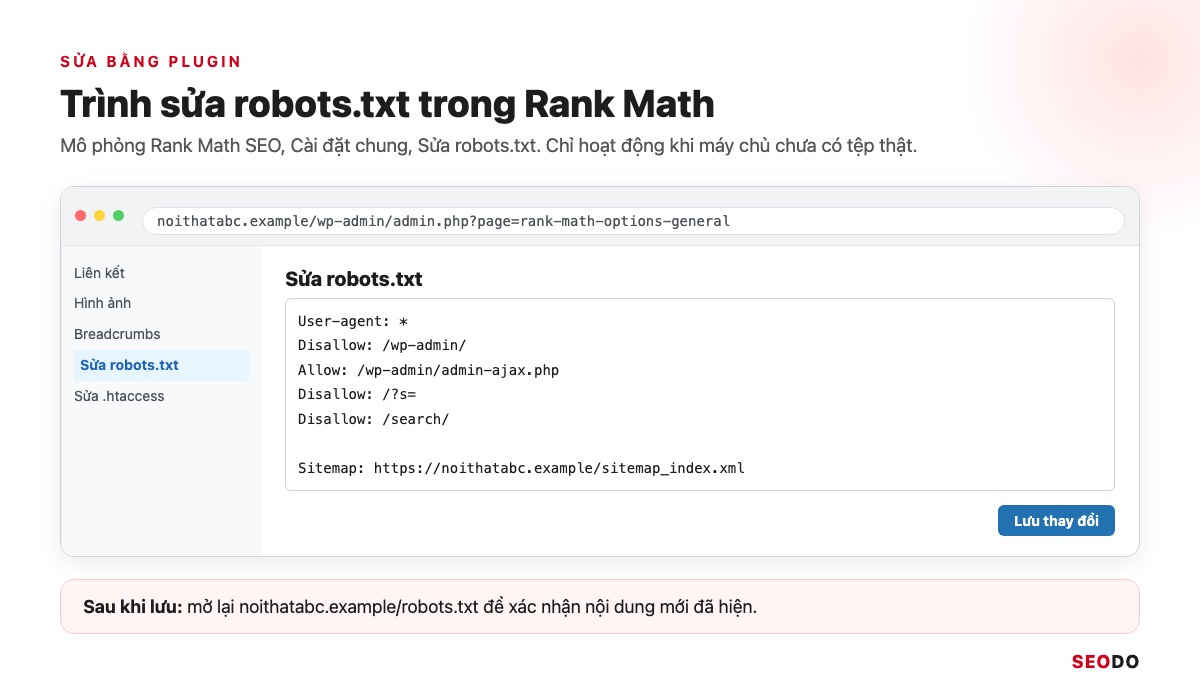
6.4. Sửa robots.txt bằng Rank Math, Yoast SEO, All in One SEO hoặc FTP
Plugin SEO cho phép sửa robots.txt ngay trong trang quản trị mà không cần mở hosting. Điều kiện là trên máy chủ chưa có tệp robots.txt thật, vì khi đã có tệp thật, plugin không ghi đè được và bạn phải sửa hoặc xoá tệp đó qua FTP. Sau khi lưu, luôn mở lại /robots.txt để xác nhận nội dung mới đã hiện.
| Cách | Đường dẫn menu | Khi nào dùng |
| Rank Math | Rank Math SEO, Cài đặt chung, Sửa robots.txt | Website đang dùng Rank Math |
| Yoast SEO | Yoast SEO, Công cụ, Trình chỉnh sửa tệp | Website đang dùng Yoast SEO |
| All in One SEO | All in One SEO, Công cụ, Trình chỉnh sửa Robots.txt | Website đang dùng AIOSEO |
| FTP hoặc File Manager | Thư mục public_html trên hosting | Đã có tệp thật, hoặc không dùng plugin SEO |
Tên menu có thể đổi theo phiên bản plugin, không thấy thì tìm chữ “robots” trong phần cài đặt. Chỉ dùng một plugin để sửa tệp, tránh hai bản ghi đè nhau.
7. Robots.txt cho bot AI: chặn hay cho phép?
Bot huấn luyện và bot tìm kiếm của AI là hai bot khác nhau, nên bạn chặn được bot này mà vẫn cho bot kia vào.
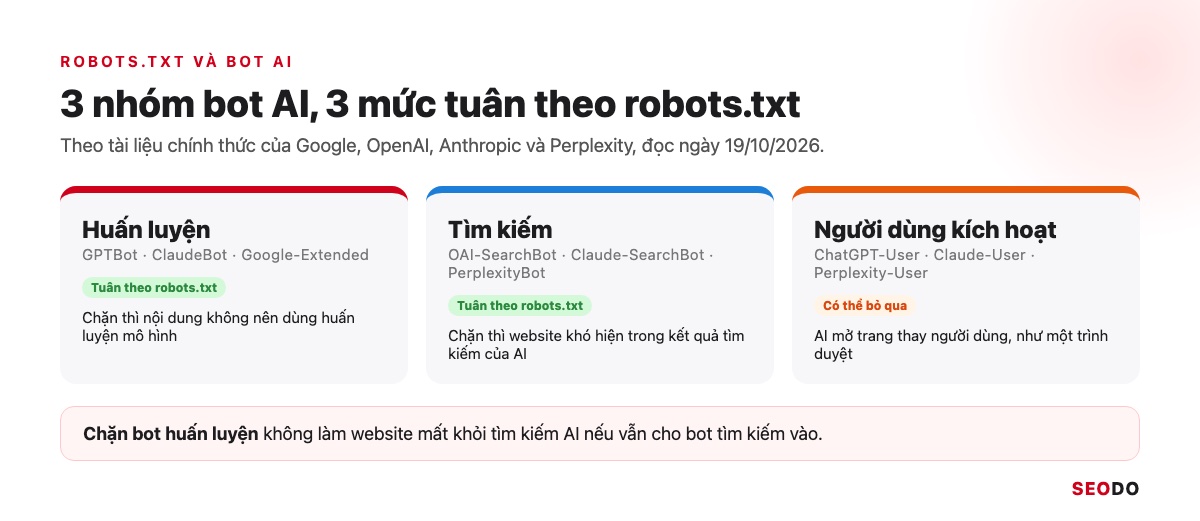
Mỗi hãng AI có bot riêng cho huấn luyện và cho tìm kiếm, nên chặn bot này không đồng nghĩa với chặn bot kia.
- Bot huấn luyện: GPTBot, ClaudeBot, Google-Extended.
- Bot tìm kiếm: OAI-SearchBot, Claude-SearchBot, PerplexityBot.
- Bot do người dùng kích hoạt: ChatGPT-User, Claude-User, Perplexity-User, một số có thể bỏ qua robots.txt.
- AI Overviews, AI Mode: không điều khiển bằng Google-Extended mà bằng cài đặt Search generative AI trong Search Console.
Chặn Googlebot để tránh AI Overviews sẽ kéo theo mất luôn Google Search.
Mỗi hãng AI dùng bot riêng cho huấn luyện mô hình và cho tìm kiếm. Vì vậy, chặn bot huấn luyện không làm website biến mất khỏi kết quả tìm kiếm của AI, miễn bạn vẫn cho bot tìm kiếm vào. Nên chặn hay cho phép tuỳ vào việc bạn coi trọng quyền với nội dung hay lượt hiển thị trong câu trả lời AI hơn.
Với website doanh nghiệp, tôi thường khuyên giữ bot tìm kiếm AI, vì khách hàng đã dùng các công cụ này để hỏi. Chặn bot huấn luyện hợp lý hơn với website có nội dung độc quyền như dữ liệu ngành. Cho bot vào cũng không bảo đảm website được AI trích dẫn, việc đó còn phụ thuộc chất lượng nội dung, như phân tích trong bài SEO thời AI Overview và bài SEO cho ChatGPT.
7.1. Bảng user-agent của bot AI có tài liệu chính thức
Bảng dưới chỉ gồm token đã có trong tài liệu chính thức của từng hãng, đọc ngày 19/10/2026. Bạn phải viết token đúng từng ký tự như tài liệu, vì sai một ký tự là quy tắc không áp dụng cho bot đó. Danh sách bot thay đổi khá nhanh, nên kiểm tra lại trang của hãng trước khi sửa tệp.
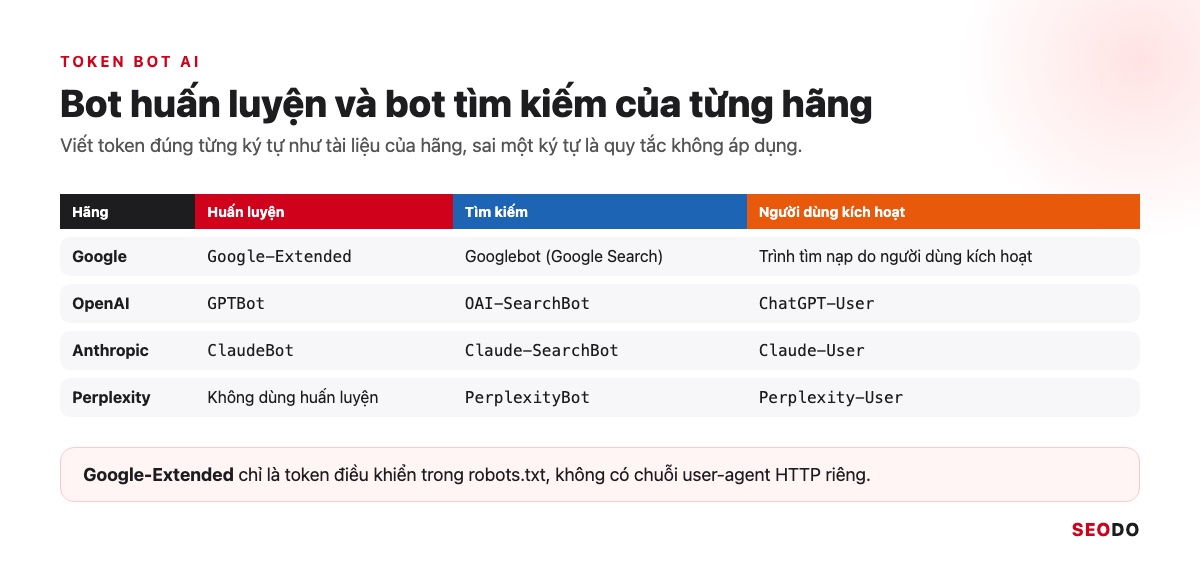
| Hãng | Token | Mục đích | Tuân theo robots.txt |
| Google-Extended | Huấn luyện Gemini và grounding trong Gemini Apps, Vertex AI | Có, chỉ là token điều khiển, không có chuỗi user-agent HTTP riêng | |
| OpenAI | GPTBot | Thu thập nội dung có thể dùng huấn luyện mô hình | Có |
| OpenAI | OAI-SearchBot | Đưa website vào kết quả tìm kiếm của ChatGPT | Có, thay đổi mất khoảng 24 giờ |
| OpenAI | ChatGPT-User | Mở trang khi người dùng yêu cầu trong ChatGPT | Có thể không áp dụng |
| Anthropic | ClaudeBot | Thu thập nội dung có thể dùng huấn luyện | Có, hỗ trợ cả Crawl-delay |
| Anthropic | Claude-SearchBot | Cải thiện chất lượng kết quả tìm kiếm | Có |
| Anthropic | Claude-User | Mở trang khi người dùng Claude hỏi | Có |
| Perplexity | PerplexityBot | Hiển thị website trong kết quả Perplexity, không dùng huấn luyện | Có |
| Perplexity | Perplexity-User | Mở trang để trả lời câu hỏi của người dùng | Thường bỏ qua |
7.2. Mẫu file chặn huấn luyện, giữ tìm kiếm AI
Mẫu dưới chặn 3 bot huấn luyện bằng một nhóm riêng, còn nhóm * của website giữ nguyên. Tiêu chí đạt là nhóm bot AI tách riêng, không sửa vào nhóm * hay nhóm Googlebot, nhờ vậy Google Search và các bot tìm kiếm AI không bị ảnh hưởng. Ba dòng User-agent liền nhau dùng chung một dòng Disallow, đúng cú pháp nhóm ở phần 3.1.
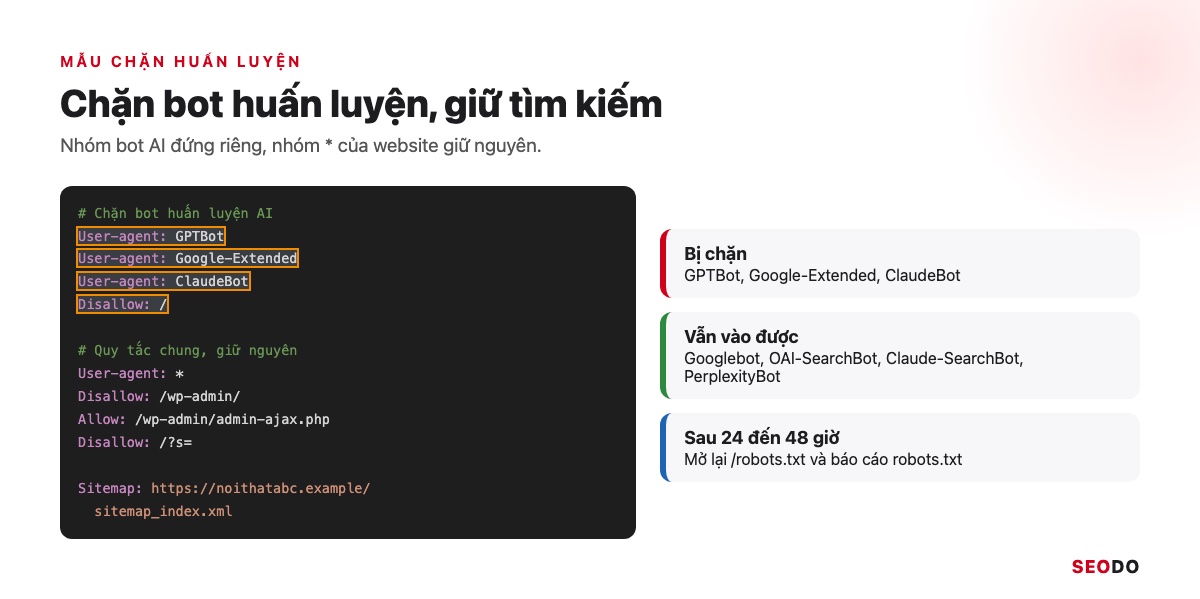
# Chặn bot huấn luyện AI
User-agent: GPTBot
User-agent: Google-Extended
User-agent: ClaudeBot
Disallow: /

# Quy tắc chung của website, giữ nguyên
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=

Sitemap: https://noithatabc.example/sitemap_index.xml
Sau khi tải tệp lên, chờ 24 đến 48 giờ rồi mở lại /robots.txt và báo cáo robots.txt để xác nhận Google đã tải bản mới. Với các hãng khác, thời gian nhận thay đổi do từng hãng quyết định, OpenAI ghi khoảng 24 giờ cho OAI-SearchBot.
7.3. AI Overviews và AI Mode không điều khiển bằng Google-Extended
Đây là chỗ nhiều người hiểu sai. Theo tài liệu về Google-Extended, token này không ảnh hưởng việc website có mặt trên Google Search và không là tín hiệu xếp hạng. Còn theo trang AI features and your website, robots.txt cho Googlebot là cách quản lý quyền thu thập, các thẻ nosnippet, data-nosnippet, max-snippet và noindex dùng để giới hạn thông tin hiển thị.
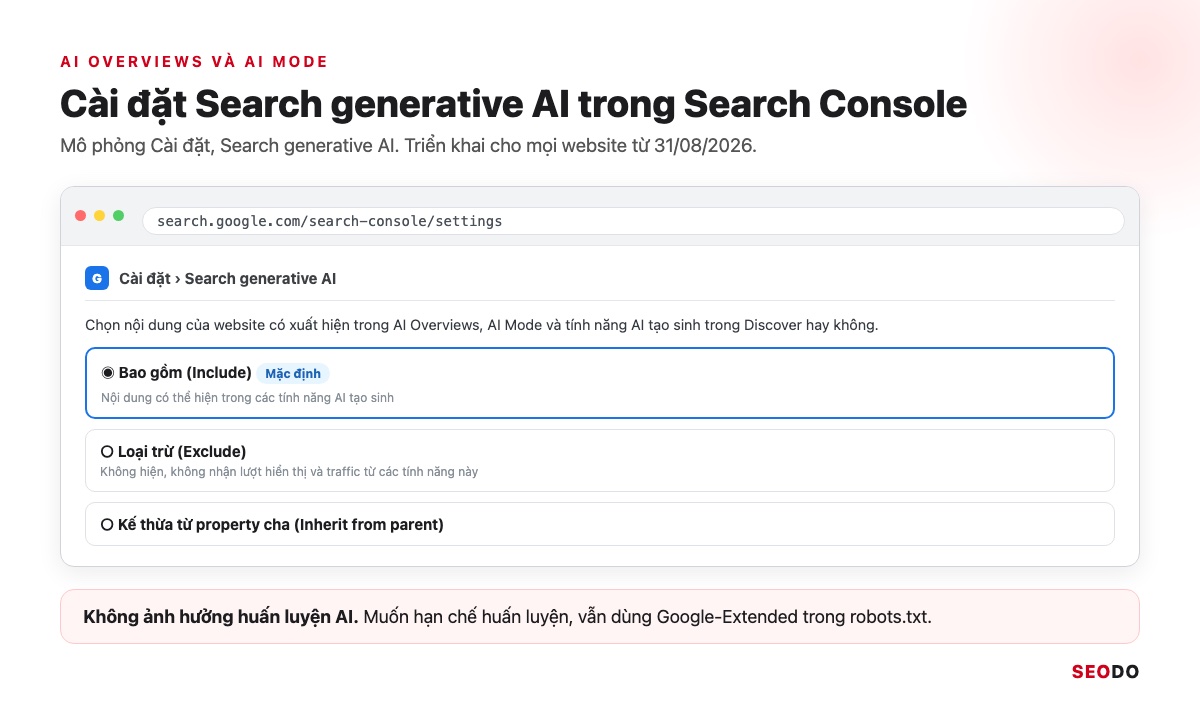
Từ 31/08/2026, Search Console có thêm cài đặt Search generative AI trong mục Cài đặt, triển khai cho mọi website. Cài đặt có 3 lựa chọn: bao gồm (mặc định), loại trừ và kế thừa từ property cha. Chọn loại trừ thì nội dung không hiện trong AI Overviews, AI Mode và tính năng AI tạo sinh trong Discover. Google ghi rõ cài đặt này không ảnh hưởng việc huấn luyện AI, muốn hạn chế huấn luyện thì vẫn dùng Google-Extended.
Chặn Googlebot trong robots.txt để tránh AI Overviews là cách làm sai, vì nó kéo theo mất luôn Google Search.
7.4. Bot do người dùng kích hoạt có thể bỏ qua robots.txt
Khi người dùng dán một đường dẫn và nhờ AI đọc, AI mở trang thay người đó, giống như một trình duyệt. Google ghi các trình tìm nạp do người dùng kích hoạt thường bỏ qua quy tắc robots.txt. OpenAI ghi với ChatGPT-User rằng quy tắc robots.txt có thể không áp dụng, còn Perplexity ghi Perplexity-User thường bỏ qua robots.txt.
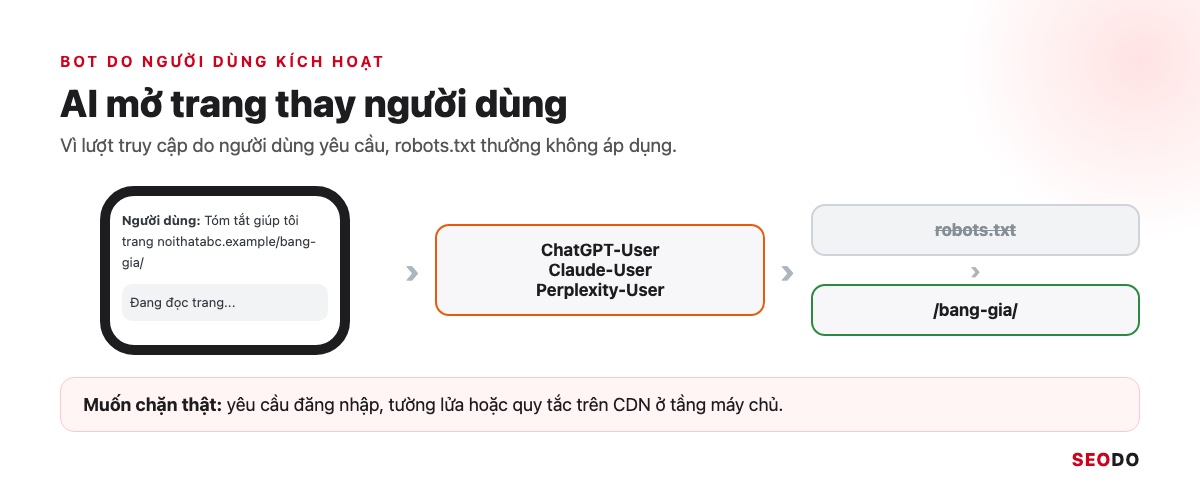
Muốn chặn thật những lượt truy cập này, bạn phải làm ở tầng máy chủ, như yêu cầu đăng nhập, tường lửa hoặc quy tắc trên CDN. Bot có thể không làm theo robots.txt.
8. Robots.txt khác gì thẻ meta robots và X-Robots-Tag?
So sánh ba công cụ giúp bạn chọn đúng cách khi muốn một trang không lên Google, tránh lỗi chặn nhầm khiến trang càng khó gỡ.
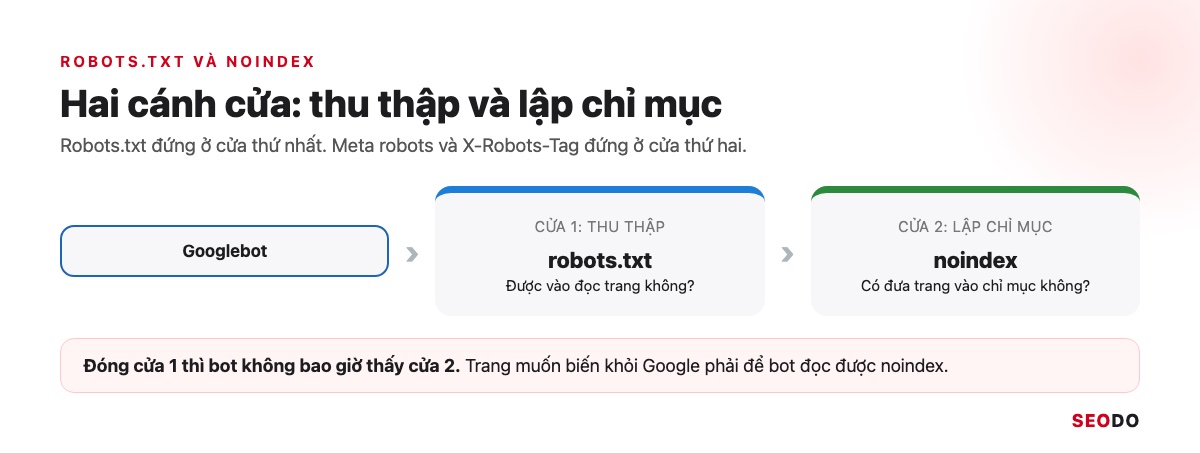
Robots.txt chặn thu thập, còn meta robots và X-Robots-Tag chặn lập chỉ mục.
- Robots.txt: đặt ở thư mục gốc, áp dụng theo đường dẫn cho cả website.
- Meta robots: đặt trong thẻ head của từng trang HTML.
- X-Robots-Tag: đặt trong header HTTP, dùng được cho PDF, ảnh và tệp không phải HTML.
Muốn trang không xuất hiện trên Google, phải để Google thu thập được trang rồi đọc noindex.
Robots.txt quyết định bot có được vào trang không, còn thẻ meta robots và X-Robots-Tag quyết định trang có được đưa vào chỉ mục không. Theo tài liệu Block Search indexing with noindex, noindex chỉ có tác dụng khi Google đọc được trang, nên trang muốn biến khỏi Google không được chặn trong robots.txt.
8.1. Bảng so sánh 3 công cụ
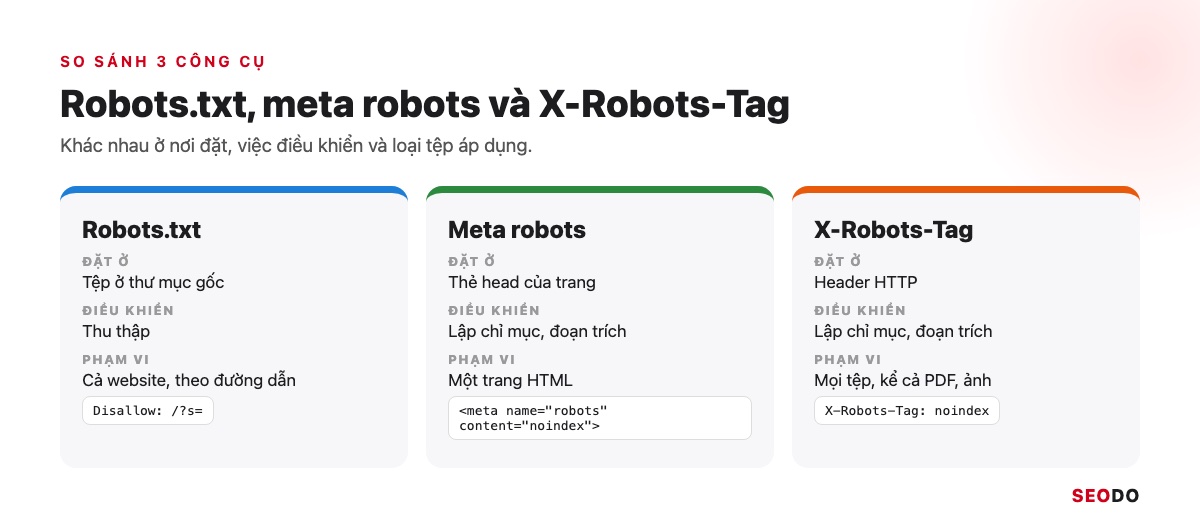
Ba công cụ khác nhau ở nơi đặt, việc điều khiển và phạm vi. Tiêu chí dễ nhớ nhất là X-Robots-Tag dùng cho PDF, ảnh và mọi tệp không phải HTML, vì những tệp này không có thẻ head để đặt meta robots. Chi tiết các giá trị của thẻ có trong mục Meta Robots của bài thẻ meta robots.
| Công cụ | Đặt ở đâu | Điều khiển | Phạm vi | Ví dụ |
| Robots.txt | Tệp ở thư mục gốc | Thu thập | Cả website, theo đường dẫn | Disallow: /?s= |
| Meta robots | Thẻ meta trong head của trang | Lập chỉ mục, hiển thị đoạn trích | Một trang HTML | <meta name=”robots” content=”noindex”> |
| X-Robots-Tag | Header HTTP do máy chủ trả về | Lập chỉ mục, hiển thị đoạn trích | Mọi loại tệp, kể cả PDF, ảnh | X-Robots-Tag: noindex |
8.2. Chọn công cụ theo tình huống
Nguyên tắc chung là trang cần biến khỏi Google thì dùng noindex, hoặc trả mã 404, 410 nếu trang không còn tồn tại, chứ không dùng Disallow. Website đang dựng thử thì khoá bằng mật khẩu. Bảng dưới gom 6 tình huống tôi hay được khách hỏi.
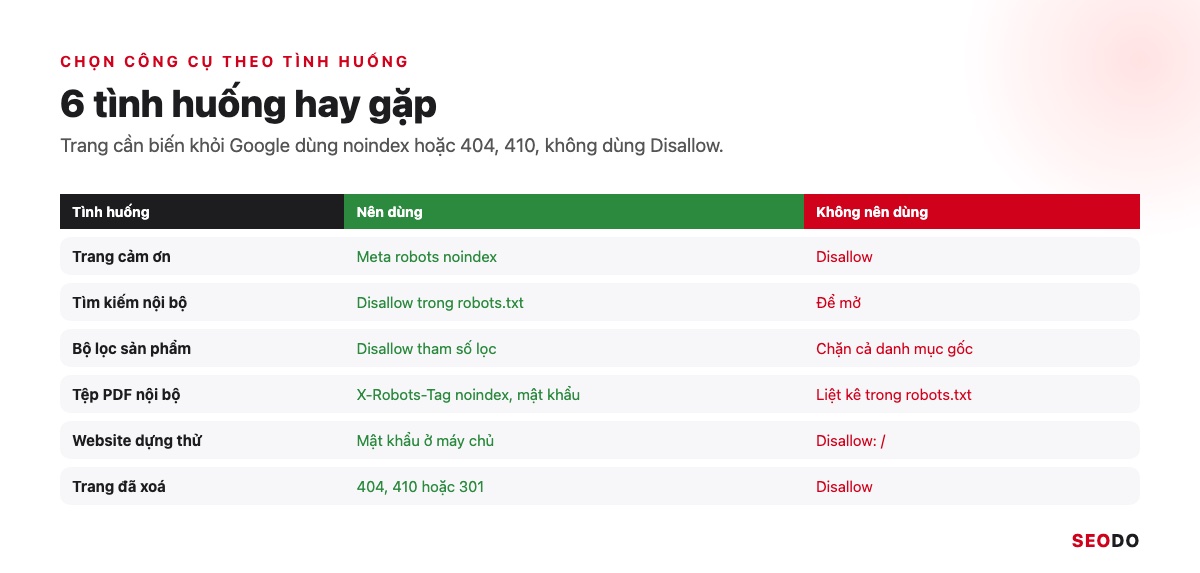
| Tình huống | Nên dùng | Không nên dùng |
| Trang cảm ơn sau khi gửi form | Meta robots noindex | Disallow, vì trang vẫn có thể được lập chỉ mục |
| Trang tìm kiếm nội bộ | Disallow trong robots.txt | Để mở, vì sinh ra vô số URL |
| Bộ lọc sản phẩm không có nhu cầu tìm kiếm | Disallow tham số lọc | Chặn cả trang danh mục gốc |
| Tệp PDF nội bộ | X-Robots-Tag noindex hoặc mật khẩu | Liệt kê đường dẫn trong robots.txt |
| Website đang dựng thử | Mật khẩu ở máy chủ | Disallow: / rồi quên gỡ khi ra mắt |
| Trang đã xoá | Mã 404 hoặc 410, hoặc 301 sang trang thay thế | Disallow, vì Google không thấy mã trả về |
Với các URL trùng nội dung mà bạn vẫn muốn gom tín hiệu về một trang gốc, thẻ canonical thường là lựa chọn tốt hơn chặn bằng robots.txt, vì Google vẫn đọc được trang để hiểu quan hệ giữa chúng.
8.3. Lỗi chặn robots.txt lên trang đã có noindex
Lỗi kết hợp hay gặp nhất là trang vừa gắn noindex vừa bị Disallow. Google ghi rõ trong tài liệu noindex rằng nếu trang bị robots.txt chặn, trình thu thập sẽ không bao giờ thấy quy tắc noindex, nên trang vẫn có thể hiện trên kết quả. Cách làm đúng là gỡ dòng Disallow, để Google thu thập lại và đọc được noindex.
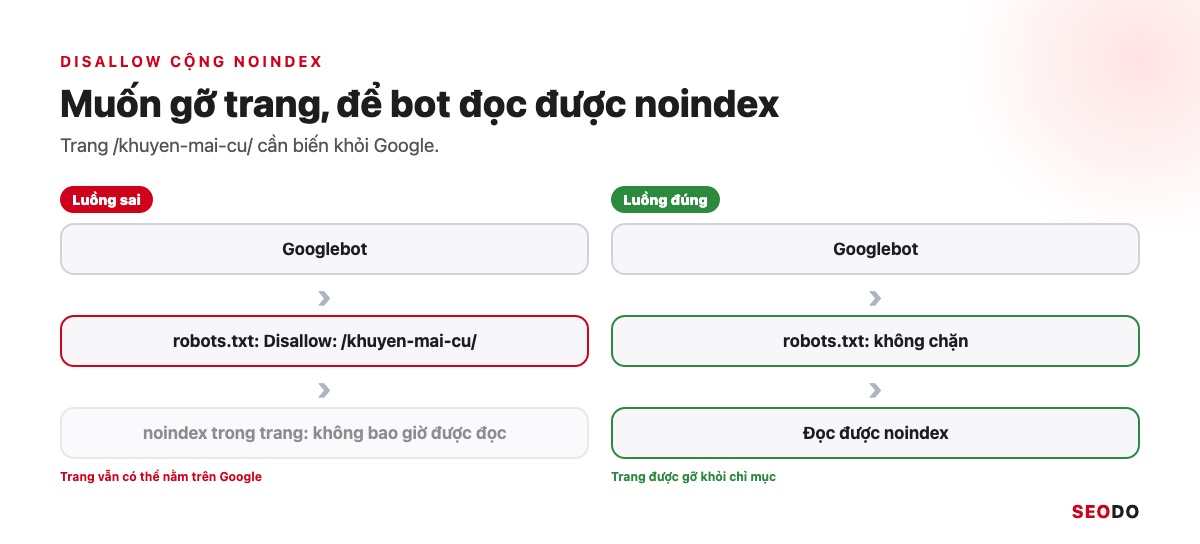
Khi trang đã ra khỏi chỉ mục, bạn mới cân nhắc chặn lại bằng robots.txt nếu muốn tiết kiệm lượt thu thập.
9. Cách kiểm tra robots.txt bằng Google Search Console
Ba báo cáo trong Search Console cho bạn biết Google đang đọc tệp nào, URL nào bị chặn và trang nào bị ảnh hưởng.
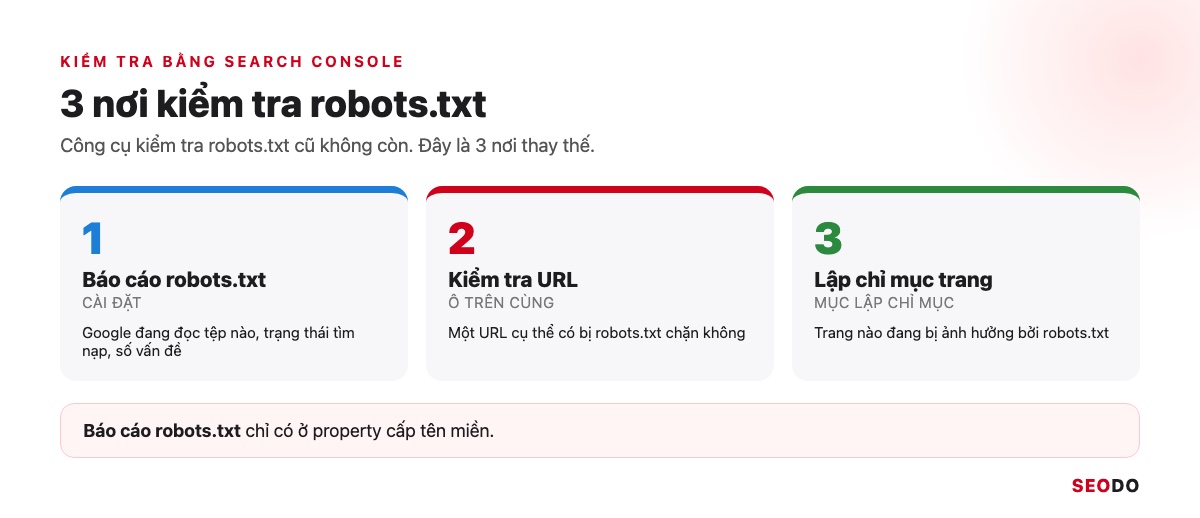
Công cụ kiểm tra robots.txt cũ không còn, việc kiểm tra hiện làm bằng 3 nơi trong Search Console:
- Báo cáo robots.txt: trong phần Cài đặt, hiện tệp của tối đa 20 host, trạng thái tìm nạp và số vấn đề.
- Công cụ Kiểm tra URL: cho biết một URL cụ thể có bị robots.txt chặn không.
- Báo cáo Lập chỉ mục trang: có 2 trạng thái liên quan robots.txt cần theo dõi.
Báo cáo robots.txt chỉ có ở property cấp tên miền.
Công cụ kiểm tra robots.txt cũ trong Search Console không còn, thay vào đó là báo cáo robots.txt nằm trong phần Cài đặt. Muốn biết một URL cụ thể có bị chặn không, bạn dùng công cụ Kiểm tra URL. Nếu bạn mới dùng Google Search Console, bài hướng dẫn cài đặt và sử dụng từ A đến Z chỉ cách thêm property và đọc các báo cáo chính trước khi kiểm tra robots.txt.
9.1. Đọc báo cáo robots.txt
Báo cáo chỉ có ở property cấp tên miền, tức Domain property hoặc URL-prefix không có đường dẫn phía sau. Theo Search Console Help, báo cáo hiện tệp robots.txt của tối đa 20 host, mỗi tệp có đường dẫn, trạng thái tìm nạp, thời điểm kiểm tra, kích thước tính bằng byte và số vấn đề. Lỗi làm một quy tắc không được dùng, còn cảnh báo thì không.
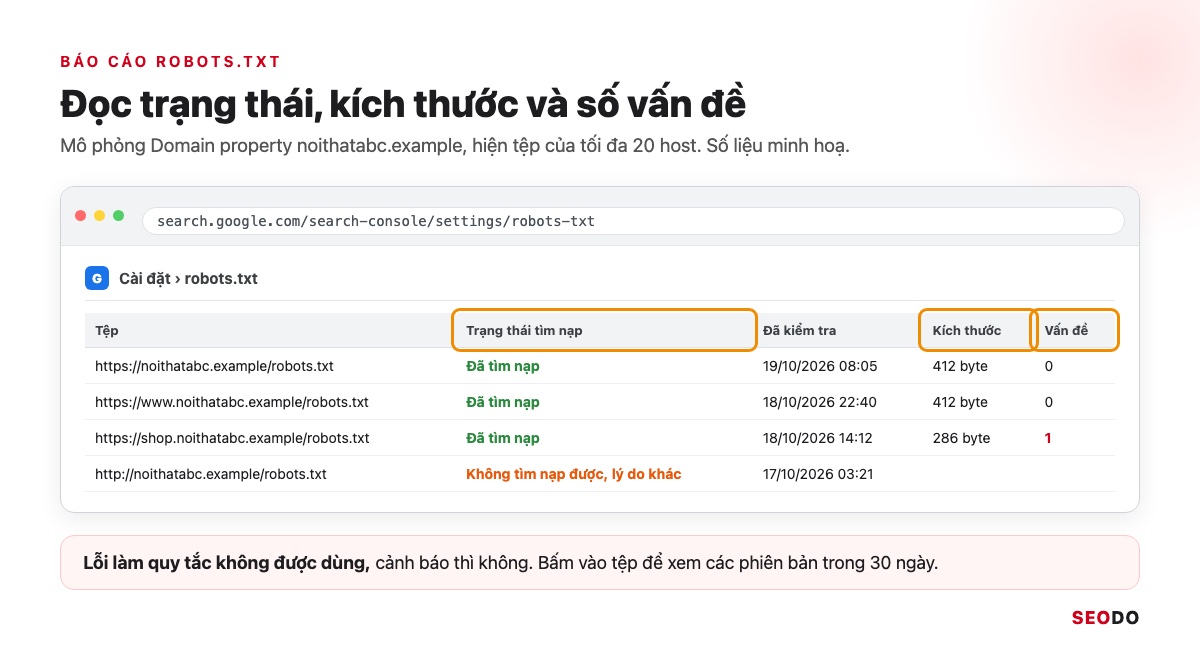
Trạng thái tìm nạp có 3 loại: đã tìm nạp, không tìm nạp được do 404, và không tìm nạp được do lý do khác. Bấm vào một tệp để xem nội dung Google đã tải và các phiên bản trong 30 ngày qua. Yêu cầu thu thập lại chỉ nên dùng khi bạn vừa gỡ chặn URL quan trọng hoặc vừa sửa lỗi tìm nạp. Nó không bảo đảm các URL vừa mở được thu thập ngay.
9.2. Kiểm tra một URL có bị chặn bằng công cụ Kiểm tra URL
Dán URL vào ô kiểm tra trên cùng của Search Console, rồi mở phần thu thập dữ liệu trong kết quả. Dòng cho phép thu thập sẽ ghi bị robots.txt chặn hay được phép. Công cụ chỉ dùng được cho URL thuộc property bạn quản lý, nên muốn thử website khác thì phải dùng công cụ bên ngoài.
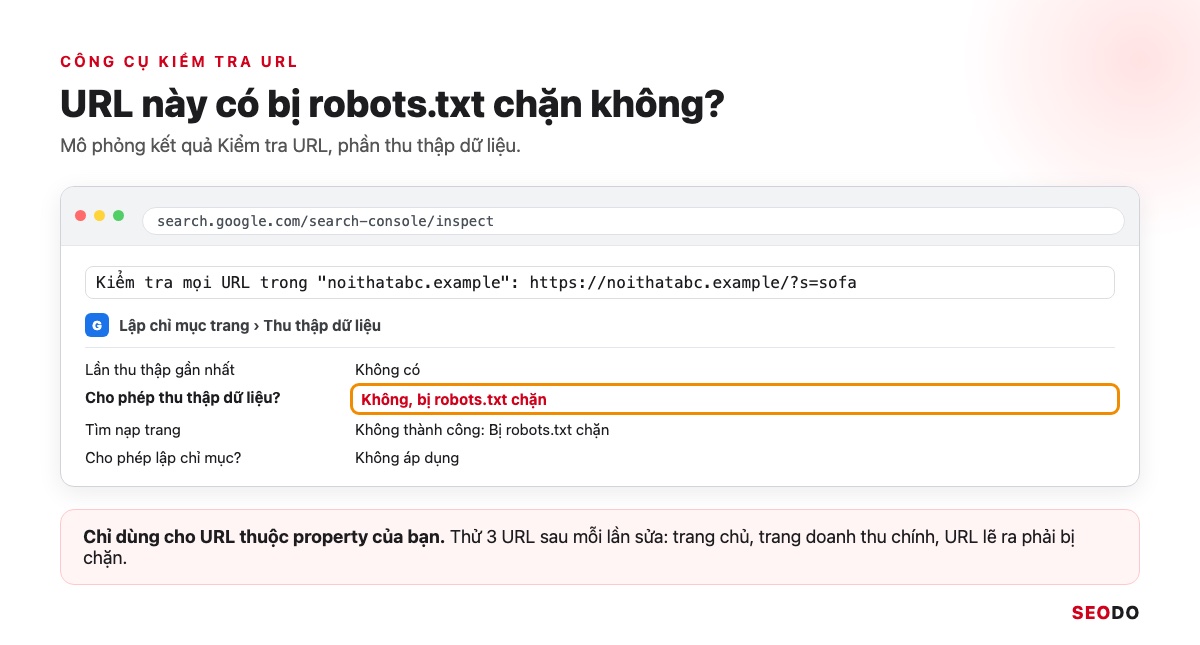
Sau mỗi lần sửa tệp, tôi thường thử 3 loại URL là trang chủ, trang mang doanh thu nhiều nhất và một URL lẽ ra phải bị chặn. Ba kết quả khớp kỳ vọng thì tệp mới đạt.
9.3. 2 trạng thái robots.txt trong báo cáo Lập chỉ mục trang
Báo cáo Lập chỉ mục trang có 2 trạng thái liên quan tới robots.txt. Trạng thái bị chặn bởi robots.txt (Blocked by robots.txt) nghĩa là Google không thu thập được trang, nhưng không bảo đảm trang không được lập chỉ mục. Trạng thái đã lập chỉ mục dù bị robots.txt chặn (Indexed, though blocked by robots.txt) thuộc nhóm cảnh báo, nghĩa là trang đã lên Google dù bot không đọc được nội dung.
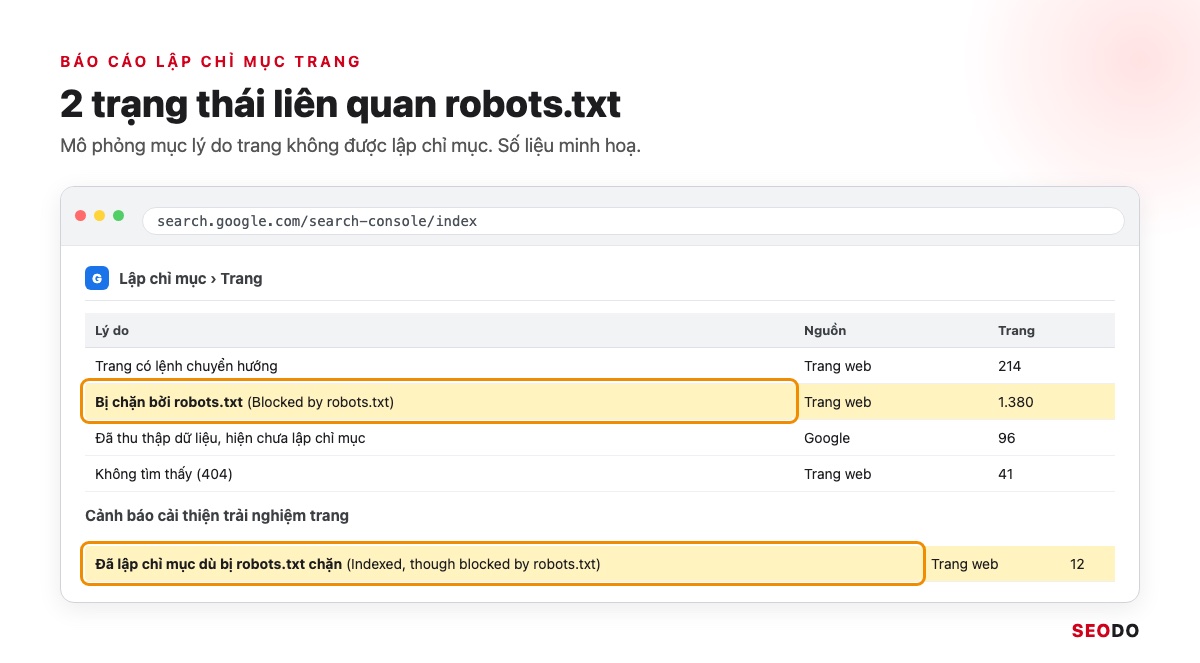
| Trạng thái | Nghĩa | Việc cần làm |
| Bị chặn bởi robots.txt | Google không thu thập được trang | Trang cần lên Google thì gỡ Disallow, trang không cần thì để nguyên |
| Đã lập chỉ mục dù bị robots.txt chặn | Trang có trên Google nhưng bot không đọc được nội dung | Muốn trang ra khỏi Google thì gỡ chặn và gắn noindex, muốn trang lên tốt thì gỡ Disallow |
10. 7 lỗi robots.txt hay gặp và cách sửa
Bảy lỗi dưới đây kèm dấu hiệu trong Search Console để bạn tự rà website mà không cần đọc lại cả tệp.
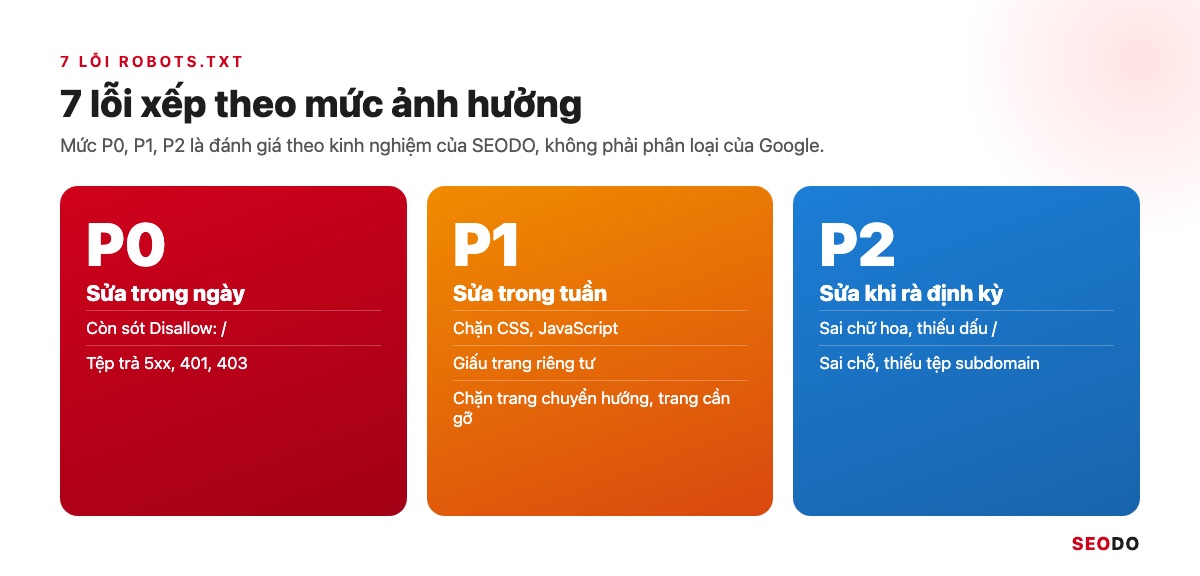
7 lỗi robots.txt chia theo mức ảnh hưởng, theo kinh nghiệm của SEODO:
- P0, sửa ngay trong ngày: còn sót Disallow: /, tệp trả lỗi 5xx hoặc 401, 403.
- P1, sửa trong tuần: chặn CSS, JavaScript, chặn trang đang chuyển hướng hoặc cần gỡ, dùng robots.txt để giấu trang riêng tư.
- P2, sửa khi rà định kỳ: sai chữ hoa, thiếu dấu gạch chéo, quên tệp cho subdomain.
Bảng tóm tắt 7 lỗi nằm ở cuối phần này.
Bảy lỗi dưới đây là những lỗi robots.txt đội SEODO hay gặp khi làm SEO audit. Mỗi lỗi có dấu hiệu nhận biết trong Search Console, nguyên nhân, cách sửa và mức ảnh hưởng. Mức P0, P1, P2 là đánh giá theo kinh nghiệm của SEODO, không phải phân loại của Google. Ví dụ dùng website giả định để bạn dễ hình dung.
10.1. Còn sót Disallow: / từ bản dựng thử
Dấu hiệu là báo cáo Lập chỉ mục trang tăng đột biến số trang bị chặn bởi robots.txt, kéo theo lượt hiển thị trong báo cáo Hiệu suất giảm mạnh. Nguyên nhân thường là website dựng thử có dòng Disallow: / và tệp được chép nguyên sang bản chính khi ra mắt. Cách sửa là xoá dòng đó, rồi bấm Yêu cầu thu thập lại trong báo cáo robots.txt.
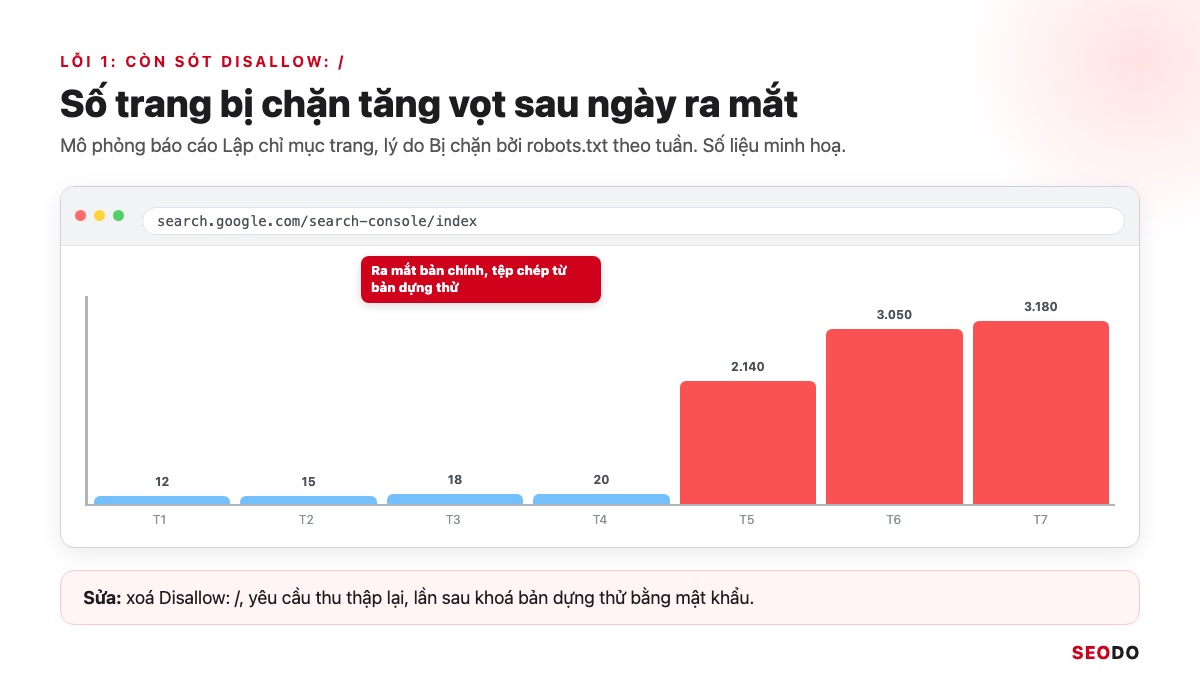
Để không lặp lại, website dựng thử nên khoá bằng mật khẩu, đừng Disallow. Mật khẩu chặn được cả người lẫn bot, và không bị chép theo khi chuyển dữ liệu sang bản chính. Mức ảnh hưởng: P0.
10.2. Chặn thư mục chứa CSS, JavaScript
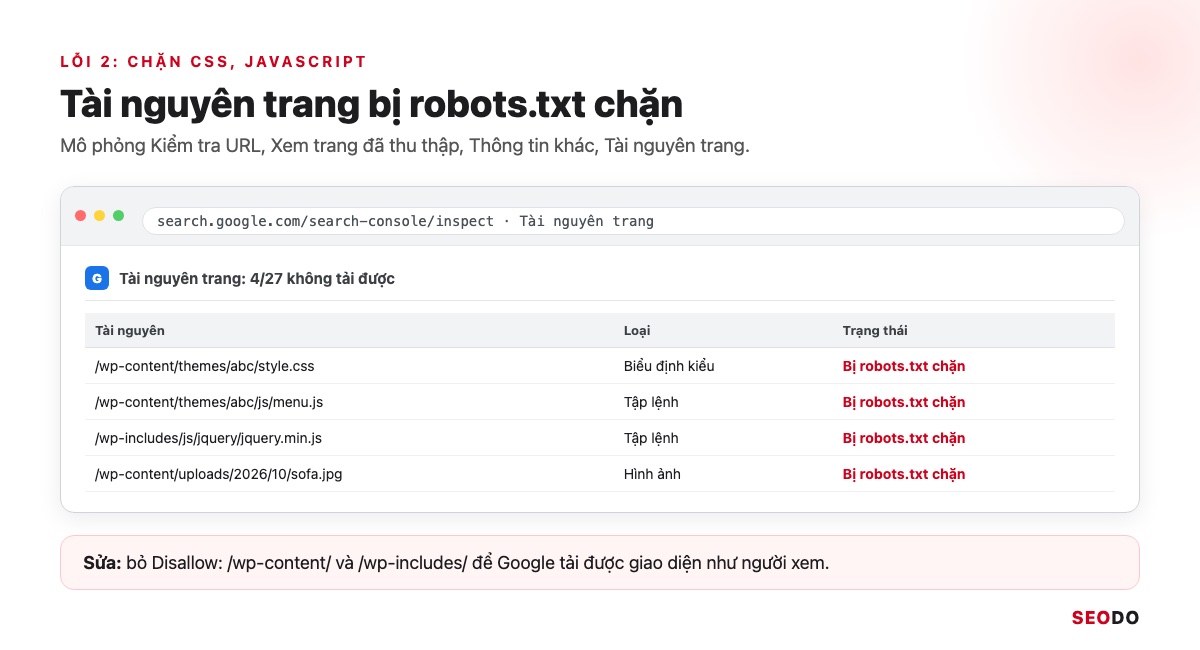
Dấu hiệu là khi mở công cụ Kiểm tra URL, xem trang đã thu thập, phần tài nguyên trang báo một số tệp không tải được vì robots.txt. Nguyên nhân thường là mẫu cũ có Disallow: /wp-content/ hoặc /wp-includes/. Google khuyên không chặn tệp tài nguyên nếu thiếu chúng Google khó hiểu trang, nên cách sửa là bỏ các dòng chặn thư mục theme, plugin và tài nguyên. Mức ảnh hưởng: P1.
10.3. Dùng robots.txt để giấu trang riêng tư
Dấu hiệu là trong tệp có những đường dẫn như /quan-tri-noi-bo/ hay /bao-gia-khach-hang/, và các URL này vẫn hiện trên Google với phần mô tả trống. Nguyên nhân là hiểu nhầm robots.txt là công cụ bảo mật. Cách sửa là gỡ các dòng đó khỏi robots.txt, khoá thư mục bằng mật khẩu hoặc gắn noindex. Mức ảnh hưởng: P1, vì ai mở tệp cũng thấy đường dẫn các thư mục này.
10.4. Sai chữ hoa, chữ thường hoặc thiếu dấu gạch chéo
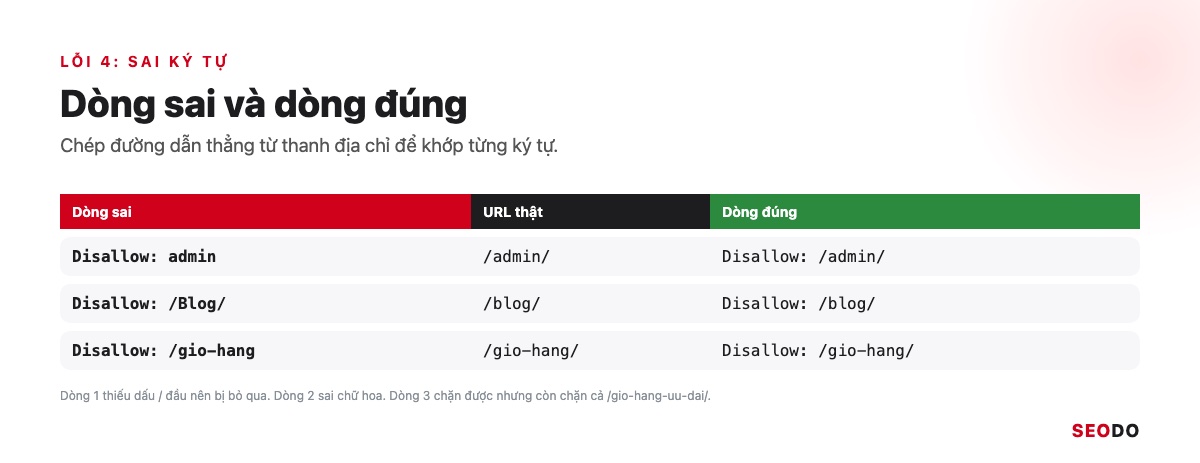
Dấu hiệu là URL vẫn được thu thập dù bạn đã viết Disallow cho nó. Nguyên nhân hay gặp là Disallow: admin thiếu dấu / ở đầu nên bị bỏ qua, hoặc Disallow: /Blog/ trong khi URL thật là /blog/. Cách sửa là đối chiếu đường dẫn trong tệp với URL thật từng ký tự, tốt nhất là chép thẳng từ thanh địa chỉ. Mức ảnh hưởng: P2.
10.5. Đặt tệp sai chỗ hoặc quên tệp cho subdomain
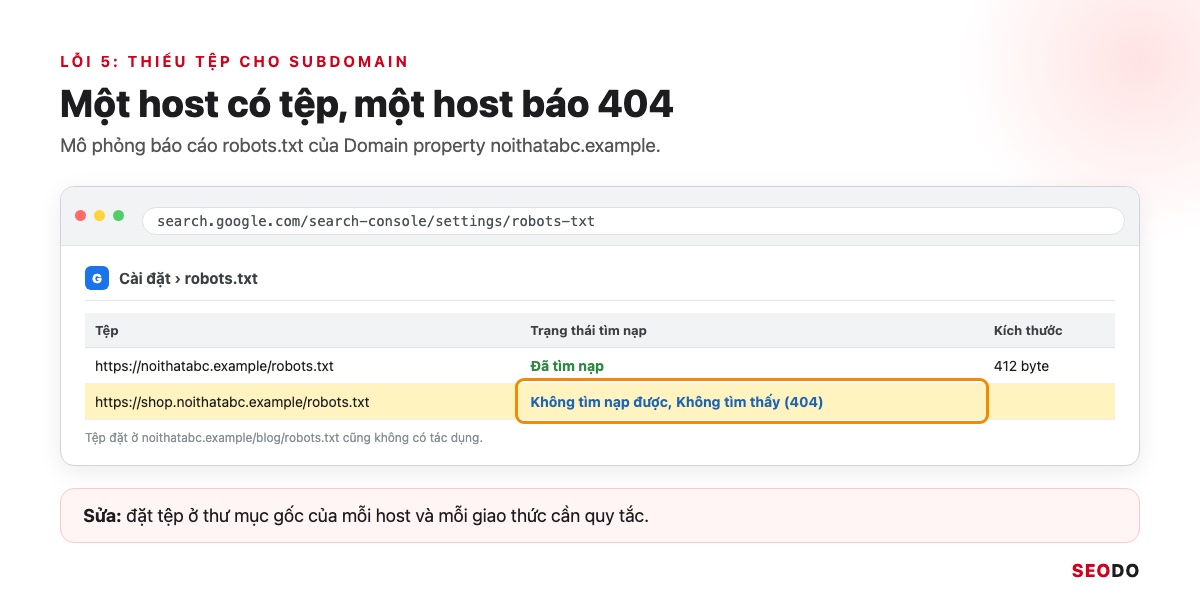
Dấu hiệu là báo cáo robots.txt không thấy tệp của một host, hoặc host đó báo 404. Nguyên nhân là tệp đặt ở /blog/robots.txt, hoặc website mở thêm subdomain như shop.noithatabc.example mà không tạo tệp riêng. Cách sửa là đặt tệp ở thư mục gốc của mỗi host và mỗi giao thức cần quy tắc. Mức ảnh hưởng: P2, vì host thiếu tệp vẫn được thu thập bình thường, chỉ là không chặn được gì.
10.6. Tệp robots.txt trả lỗi 5xx hoặc 401, 403
Dấu hiệu là báo cáo robots.txt hiện trạng thái không tìm nạp được do lý do khác. Lỗi 5xx kéo dài làm Google ngừng thu thập website trong 12 giờ đầu rồi dùng bản lưu cũ đến 30 ngày, nên đây là lỗi P0. Google cũng dặn không dùng mã 401, 403 để giảm tốc độ thu thập. Cách sửa là kiểm tra mã trả về của /robots.txt bằng tab Network trong DevTools hoặc lệnh curl -I, rồi xem tường lửa, CDN có đang chặn Googlebot không.
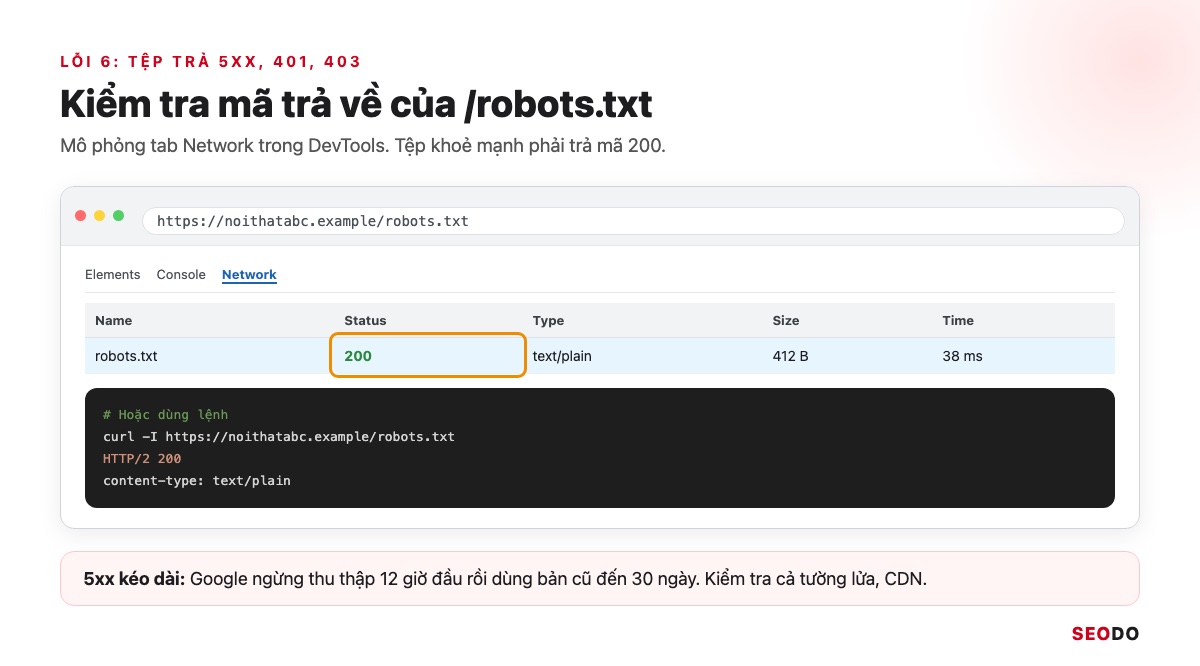
10.7. Chặn trang đang chuyển hướng hoặc trang cần gỡ khỏi Google
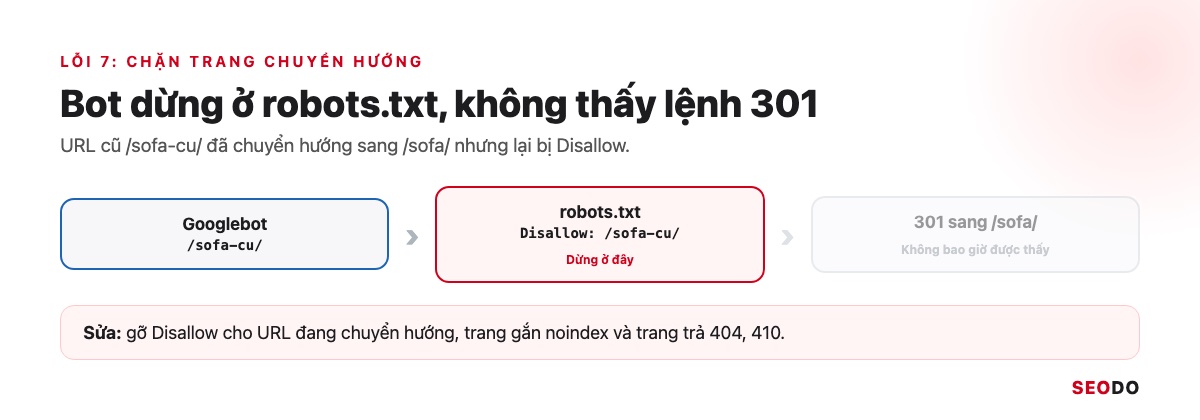
Dấu hiệu là URL cũ đã chuyển hướng 301 nhưng Google vẫn giữ URL cũ trong kết quả, hoặc trang đã gắn noindex, đã trả 404 mà mãi không biến mất. Nguyên nhân là các URL này bị Disallow, nên Google không vào được để thấy lệnh chuyển hướng, thẻ noindex hay mã 404. Cách sửa là gỡ Disallow cho chúng. Cách đặt chuyển hướng đúng có trong bài redirect 301. Mức ảnh hưởng: P1.
Tóm tắt 7 lỗi
| Lỗi | Dấu hiệu | Cách sửa | Mức |
| 1. Còn sót Disallow: / | Số trang bị chặn bởi robots.txt tăng đột biến | Xoá dòng, yêu cầu thu thập lại, khoá bản dựng thử bằng mật khẩu | P0 |
| 2. Chặn CSS, JavaScript | Kiểm tra URL báo tài nguyên không tải được | Bỏ Disallow thư mục tài nguyên | P1 |
| 3. Giấu trang riêng tư | Đường dẫn nhạy cảm nằm trong tệp, URL hiện không có mô tả | Gỡ khỏi tệp, dùng mật khẩu hoặc noindex | P1 |
| 4. Sai chữ hoa, thiếu dấu / | URL vẫn được thu thập dù đã Disallow | Chép đường dẫn từ URL thật | P2 |
| 5. Sai chỗ, thiếu tệp subdomain | Host báo 404 hoặc không có trong báo cáo | Đặt tệp ở gốc mỗi host | P2 |
| 6. Tệp trả 5xx, 401, 403 | Không tìm nạp được do lý do khác | Sửa máy chủ, tường lửa, CDN để tệp trả 200 | P0 |
| 7. Chặn trang chuyển hướng, trang cần gỡ | URL cũ, trang noindex mãi không rời kết quả | Gỡ Disallow cho các URL đó | P1 |
11. Câu hỏi thường gặp về robots.txt
Những câu trả lời ngắn cho các thắc mắc hay gặp nhất khi sửa robots.txt.
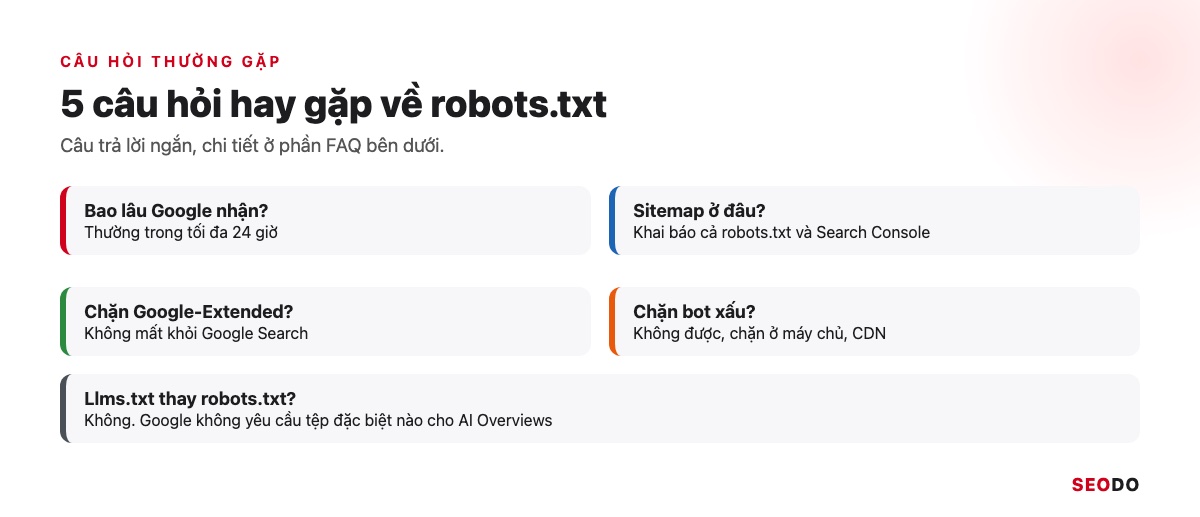
- Thời gian nhận thay đổi: Google thường làm mới bản lưu robots.txt trong tối đa 24 giờ.
- Sitemap: nên khai báo cả trong robots.txt lẫn Search Console.
- Google-Extended: chặn token này không làm website mất khỏi Google Search.
- Bot xấu: robots.txt không chặn được, phải chặn ở máy chủ, tường lửa hoặc CDN.
- Llms.txt: không thay được robots.txt, Google không yêu cầu tệp đặc biệt nào cho AI Overviews.
11.1. Sửa robots.txt bao lâu thì Google nhận?
Google thường lưu bản đệm robots.txt tối đa 24 giờ, và có thể lâu hơn khi không tải được tệp. Cần nhanh hơn thì bấm Yêu cầu thu thập lại trong báo cáo robots.txt của Search Console. Google sẽ tải tệp mới sớm hơn, nhưng không bảo đảm các URL vừa mở chặn được thu thập ngay.
11.2. Có cần khai báo sitemap trong robots.txt khi đã gửi trên Search Console không?
Không bắt buộc, nhưng nên làm cả hai. Dòng Sitemap trong robots.txt để mọi công cụ tìm kiếm, không riêng Google, tìm thấy sitemap. Còn gửi sitemap trên Search Console thì theo dõi được trạng thái đọc, số URL được phát hiện và lỗi của từng tệp sitemap.
11.3. Chặn Google-Extended có làm website mất khỏi Google Search không?
Không. Tài liệu của Google ghi Google-Extended không ảnh hưởng việc website có mặt trên Google Search và không phải tín hiệu xếp hạng. Token này chỉ điều khiển việc dùng nội dung để huấn luyện Gemini và grounding. Muốn ra khỏi AI Overviews thì dùng cài đặt Search generative AI trong Search Console.
11.4. Robots.txt có chặn được bot xấu không?
Không. Mỗi bot tự quyết có làm theo robots.txt hay không, và bot thu thập dữ liệu trái phép thường bỏ qua tệp này. Muốn chặn chúng, bạn cần quy tắc ở máy chủ, tường lửa ứng dụng web hoặc CDN, chặn theo địa chỉ IP, tần suất truy cập hoặc dấu hiệu hành vi.
11.5. Website có cần tệp llms.txt thay cho robots.txt không?
Không thay được. Robots.txt là chuẩn RFC 9309 mà Google và các hãng AI đã công bố cách đọc. Google ghi rõ không cần tạo tệp máy đọc hay tệp văn bản riêng nào để xuất hiện trong AI Overviews, và không có tài liệu nào của Google xác nhận dùng llms.txt.
Nguồn tham khảo
- Google Search Central: Giới thiệu và hướng dẫn về tệp robots.txt (cập nhật 10/12/2025)
- Google Crawling Infrastructure: How Google interprets the robots.txt specification (cập nhật 31/08/2026)
- Google Crawling Infrastructure: Create and submit a robots.txt file (cập nhật 21/11/2025)
- Google Crawling Infrastructure: Useful robots.txt rules, Update your robots.txt file
- Google Crawling Infrastructure: Google common crawlers (cập nhật 15/10/2026), Google user-triggered fetchers (cập nhật 19/08/2026)
- Google Search Central: Managing crawling of faceted navigation URLs
- Google Search Central Blog: A note on unsupported rules in robots.txt (07/2019)
- Google Search Central: Block Search indexing with noindex, AI features and your website (cập nhật 10/12/2025)
- Search Console Help: robots.txt report, Page indexing report, URL Inspection tool, Search generative AI control
- IETF: RFC 9309 Robots Exclusion Protocol (09/2022)
- WordPress Developer Resources: do_robots()
- OpenAI: Overview of OpenAI Crawlers. Anthropic Help Center: ClaudeBot và các bot của Anthropic. Perplexity: Perplexity Crawlers