
 WulingTăng trưởng bền vững từ chiến lược SEO
 SCGNghiệm thu dự án sớm 2 tháng
 cirCOVượt KPI trước 3 tháng
Bạn đăng bài mới cả tuần mà tìm trên Google vẫn không thấy, trong khi bài đối thủ vừa đăng đã có mặt? Trước khi viết lại, bạn cần biết Google đã ghé trang đó chưa.
Tôi là Thái Doãn Kiên, làm SEO từ năm 2016 và đã cùng đội ngũ SEODO triển khai gần 1.000 dự án. Google chỉ đưa lên kết quả những trang nó đã tìm thấy và đọc được, nên trang bị bỏ sót không mang về khách nào, dù nội dung viết kỹ đến đâu.
Khâu này bạn tự kiểm tra được bằng công cụ miễn phí của Google. Nắm được cách Googlebot đi qua website, bạn biết trang nào đã được ghé, trang nào bị bỏ sót và tự sửa 8 lỗi crawl hay gặp.
Tóm tắt nhanh
- Google crawl là gì: là lúc Googlebot tìm và tải các trang trên website về để Google đọc nội dung.
- Crawl khác index thế nào: crawl là Google ghé và tải trang, index là Google lưu trang vào kho để có thể hiện trên kết quả.
- Vì sao trang mới chưa lên Google: Google chưa tìm ra trang, bị chặn không vào được, hoặc đã vào nhưng chưa lập chỉ mục.
- Xem Google đã ghé chưa ở đâu: công cụ Kiểm tra URL trong Search Console cho biết lần thu thập gần nhất.
- Làm gì để Google crawl tốt hơn: có link nội bộ trỏ tới, nằm trong sitemap, máy chủ nhanh.
- Sai lầm hay gặp: tưởng robots.txt làm trang biến khỏi Google, hoặc lo crawl budget khi website mới vài trăm trang.
1. Google crawl là gì?
Phân biệt crawl với index để biết trang đang kẹt ở khâu nào.
Google crawl là bước 1 trong 3 giai đoạn của Google Search, do Googlebot thực hiện.
Google không bảo đảm sẽ crawl mọi trang, kể cả trang đạt chuẩn.
Google crawl (thu thập dữ liệu) là quá trình Googlebot, chương trình tự động của Google, tìm và tải văn bản, hình ảnh, video từ các trang trên Internet để Google đọc được nội dung. Đây là bước đầu trong 3 giai đoạn của Google Search, theo tài liệu How Google Search works (cập nhật 18/12/2025).
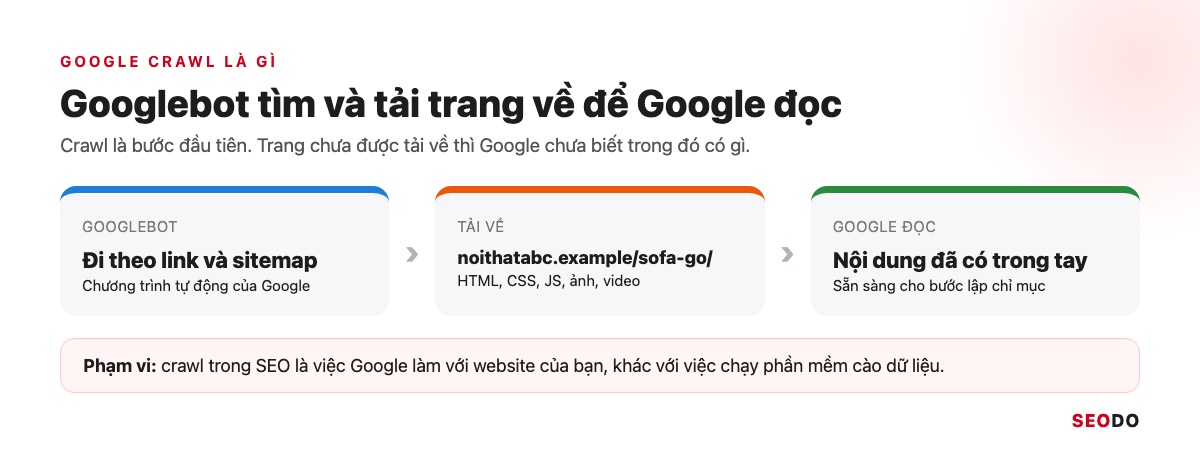
Đây là khái niệm nền khi tìm hiểu SEO là gì, vì nó là việc Google làm với chính website của bạn. Cụm “crawl data” theo nghĩa chạy phần mềm cào dữ liệu từ website khác là chủ đề khác.
1.1. Googlebot là gì và có mấy loại?
Googlebot là tên chung của trình thu thập dữ liệu Google dùng cho Search, gồm Googlebot Smartphone và Googlebot Desktop. Theo tài liệu What is Googlebot (cập nhật 03/02/2026), đa số yêu cầu thu thập đến từ bản di động.
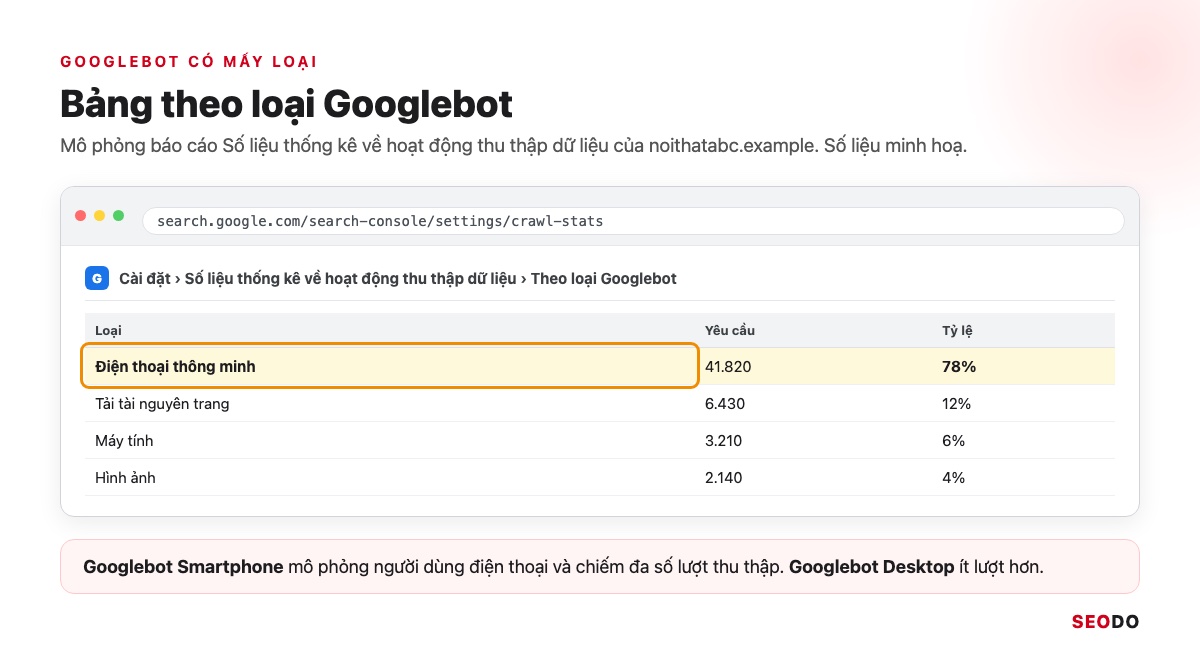
| Loại | Mô phỏng | Khi nào gặp |
| Googlebot Smartphone | Người dùng điện thoại | Đa số lượt thu thập |
| Googlebot Desktop | Người dùng máy tính | Ít lượt hơn bản di động |
1.2. Crawl, index và hiển thị kết quả khác nhau thế nào?
Khác nhau ở việc Google làm với trang. Crawl là tải trang về, index là phân tích và lưu vào chỉ mục, phân phát là chọn trang để hiện khi có người tìm.
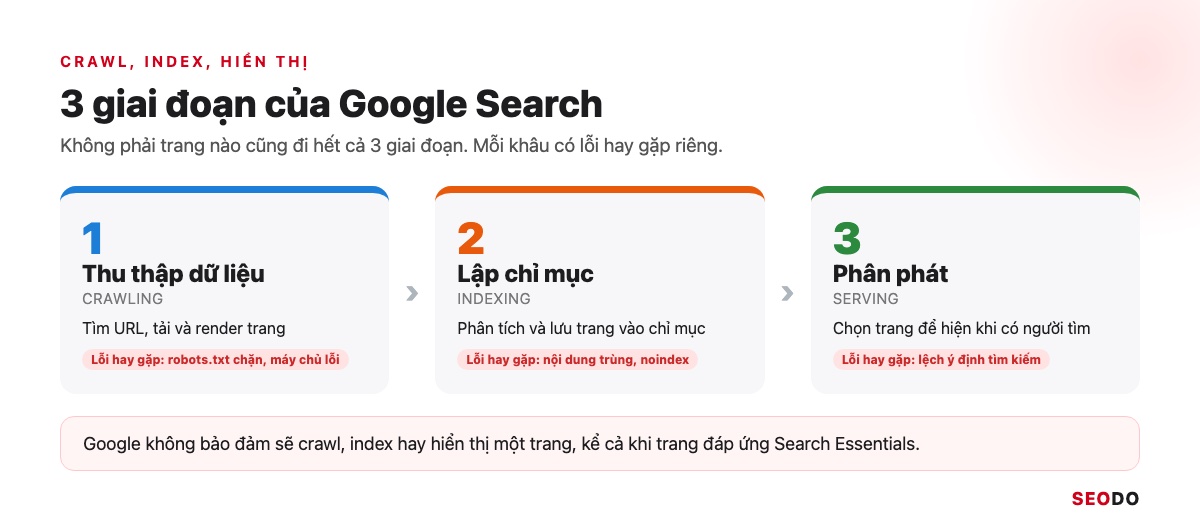
| Giai đoạn | Google làm gì | Lỗi hay gặp |
| Thu thập dữ liệu | Tìm URL, tải và render trang | Bị robots.txt chặn, máy chủ lỗi |
| Lập chỉ mục | Phân tích, lưu trang vào chỉ mục | Nội dung trùng, có noindex |
| Phân phát | Chọn trang cho truy vấn | Nội dung lệch ý định tìm kiếm |
Đã crawl mà chưa lên Google thì xem bài Google index và cách giúp trang được lập chỉ mục.
2. Google crawl website như thế nào?
Biết Googlebot làm gì ở từng bước thì biết dò lỗi ở đâu trước.
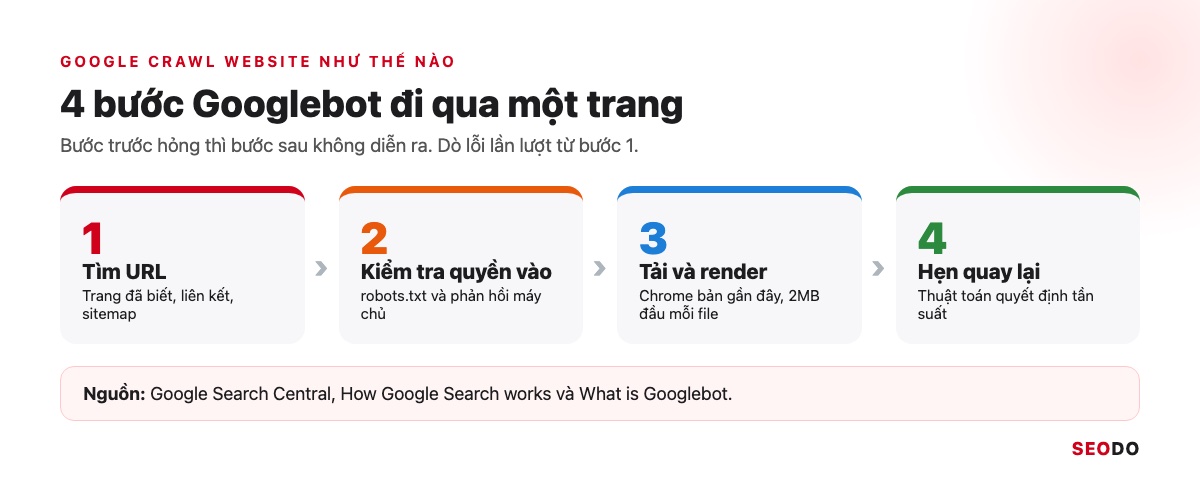
Google crawl website theo 4 bước:
- Tìm URL từ trang đã biết, liên kết và sitemap.
- Kiểm tra robots.txt và phản hồi máy chủ.
- Tải và render trang, đọc tối đa 2MB đầu mỗi file.
- Quyết định lúc quay lại bằng thuật toán.
Google crawl website theo 4 bước nối tiếp, từ lúc tìm ra URL tới lúc hẹn ngày quay lại. Bước trước hỏng thì bước sau không diễn ra, nên bạn dò lần lượt từ bước 1.
2.1. Bước 1: Tìm URL qua liên kết và sitemap
Không có danh bạ trung tâm nào chứa mọi trang web, nên Googlebot tìm URL từ 3 nguồn:
- Trang Google đã thu thập trước đó.
- Liên kết từ trang đã biết, ví dụ trang danh mục trỏ tới bài mới.
- Sitemap chủ website gửi lên.
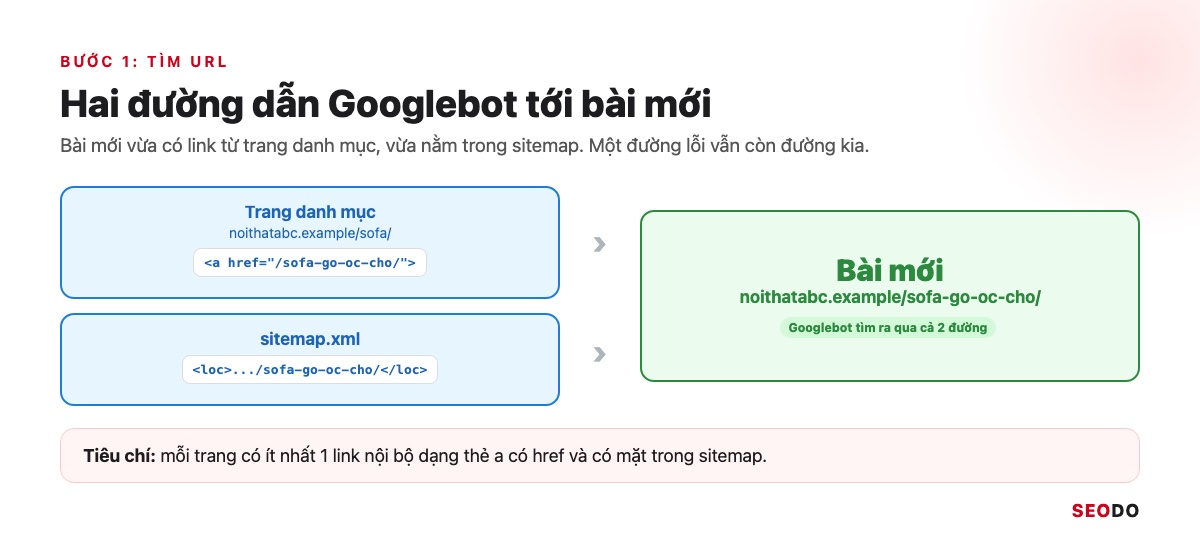
Tiêu chí là mỗi trang có ít nhất 1 link nội bộ dạng thẻ a có href và có mặt trong sitemap. Một đường lỗi thì Googlebot vẫn còn đường kia.
2.2. Bước 2: Kiểm tra robots.txt và phản hồi máy chủ
Googlebot đọc robots.txt để biết URL nào được vào, rồi mới gửi yêu cầu tới URL. Máy chủ chậm hoặc trả lỗi 500 thì Google hiểu là cần giảm tốc, số trang được ghé giảm theo.
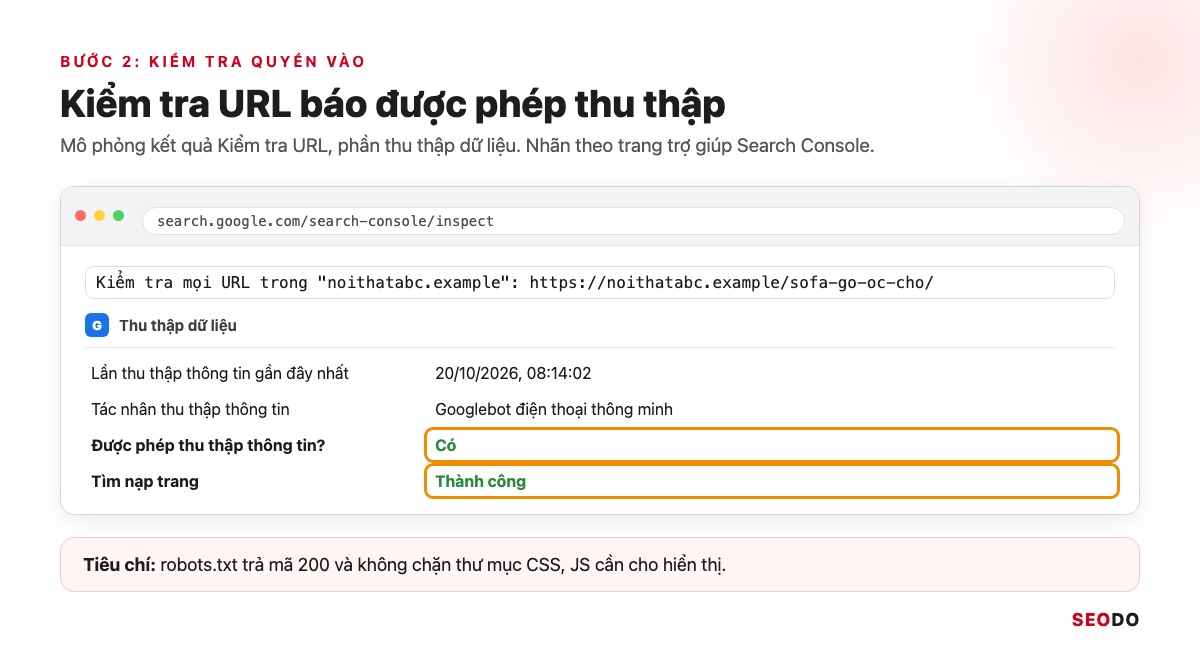
Tiêu chí là robots.txt trả mã 200, không chặn thư mục CSS, JS cần cho hiển thị, và Kiểm tra URL ghi “Được phép thu thập thông tin? Có”.
2.3. Bước 3: Tải và hiển thị trang bằng Chrome
Googlebot tải HTML rồi render trang, chạy JavaScript bằng một phiên bản Chrome gần đây. Theo tài liệu Googlebot, nó chỉ đọc 2MB đầu của mỗi file, tính trên dữ liệu chưa nén, riêng PDF là 64MB. Con số 15MB còn ghi ở nhiều bài cũ không khớp tài liệu hiện tại.
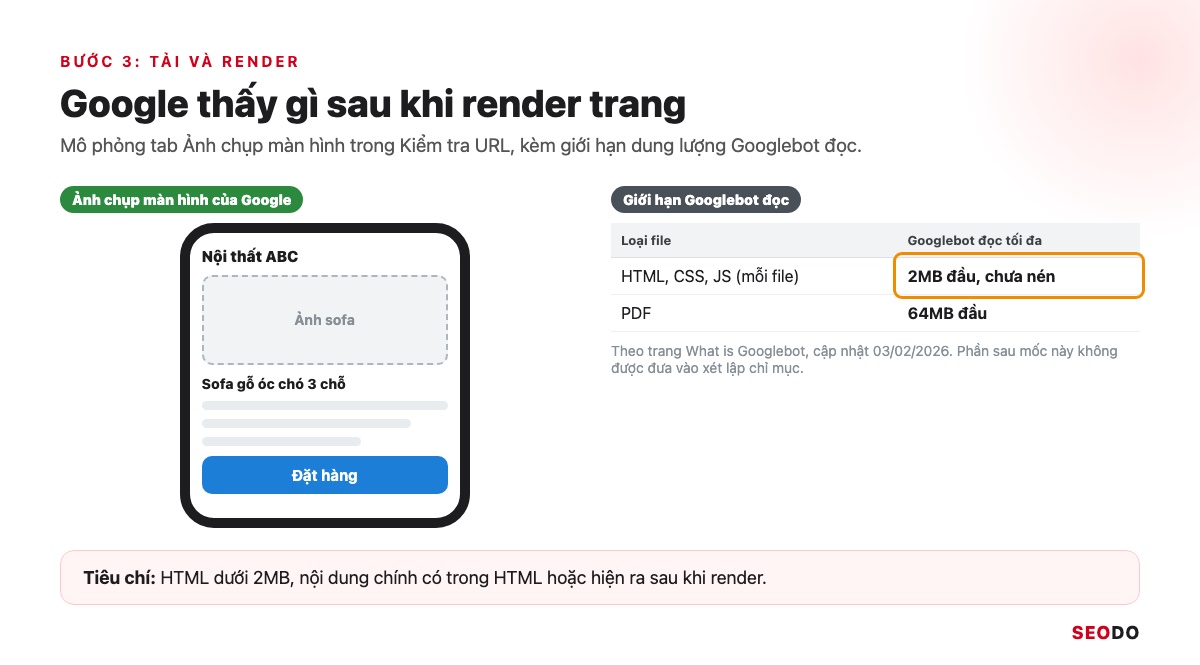
Tiêu chí là HTML dưới 2MB, nội dung chính có trong HTML hoặc hiện ra sau render. Tab Ảnh chụp màn hình trong Kiểm tra URL cho thấy Google nhìn trang ra sao.
2.4. Bước 4: Quyết định tần suất quay lại
Thuật toán của Googlebot tự quyết định tần suất ghé và số trang lấy mỗi lần. Với đa số website, Googlebot không truy cập quá một lần mỗi vài giây tính trung bình.
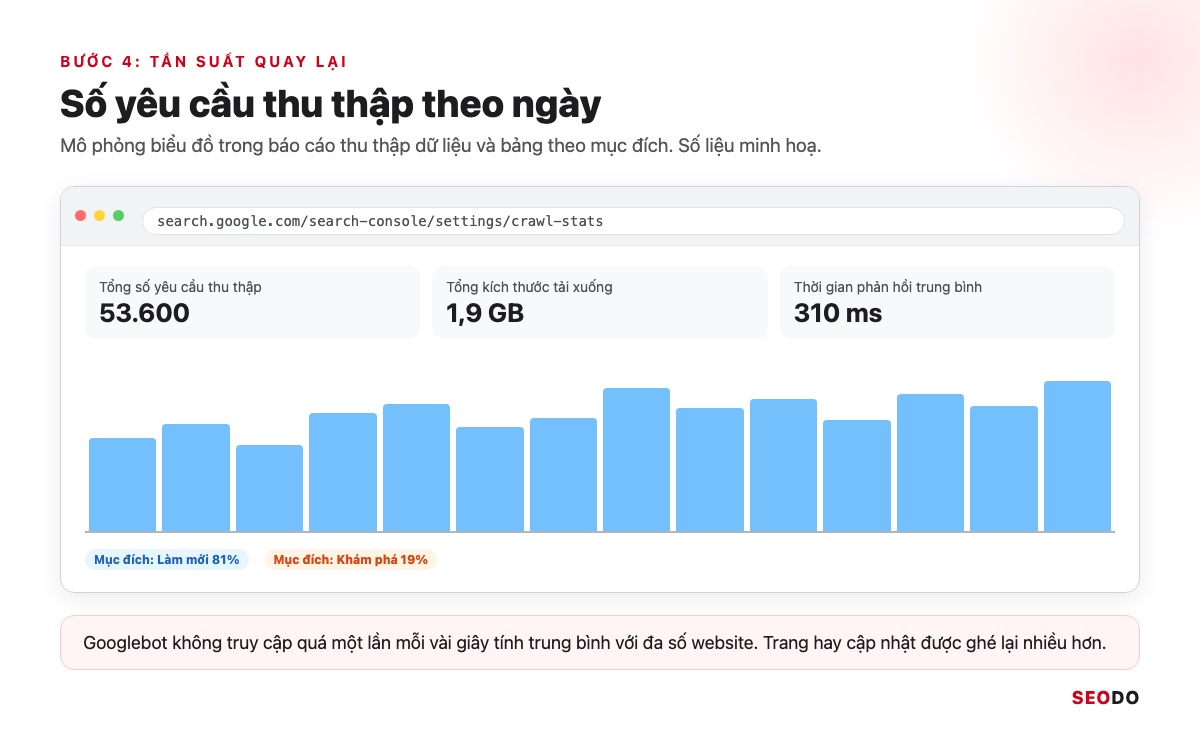
Trang hay cập nhật được ghé lại nhiều hơn, thể hiện ở mục đích Làm mới trong báo cáo thu thập dữ liệu.
3. Vì sao Google crawl quan trọng với SEO?
Ba hệ quả khi khâu crawl trục trặc và nhóm website cần theo dõi sát.
Trang chưa được crawl thì không thể lên kết quả tìm kiếm. Website trên 10.000 trang thay đổi hằng ngày cần theo dõi khâu này đều nhất.
Google thu thập dữ liệu để có nội dung đưa vào chỉ mục, nên trang chưa được crawl thì không thể lên kết quả tìm kiếm. Khâu crawl có vấn đề sẽ gây 1 trong 3 hệ quả:
- Bài mới đăng nhiều ngày chưa có trên Google.
- Giá hay khuyến mãi đã sửa nhưng kết quả tìm kiếm vẫn hiện bản cũ.
- Trang bị loại khỏi chỉ mục khi máy chủ lỗi nhiều ngày.
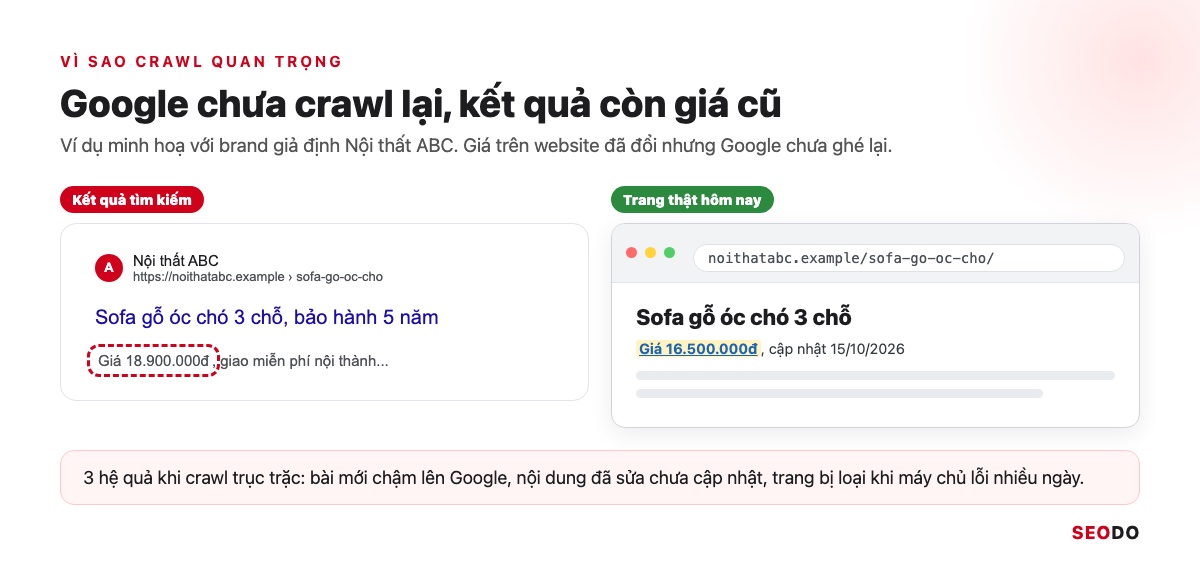
Vì vậy trong quy trình SEO audit, khâu thu thập được kiểm tra trước nội dung và liên kết.
3.1. Website nào cần để ý crawl nhiều nhất?
Cần để ý nhất là website có nhiều URL hoặc URL thay đổi liên tục:
- Website tin tức đăng bài mỗi ngày.
- Website bán hàng có hàng nghìn sản phẩm.
- Website có bộ lọc sinh nhiều URL.
- Website vừa đổi tên miền hoặc cấu trúc URL.
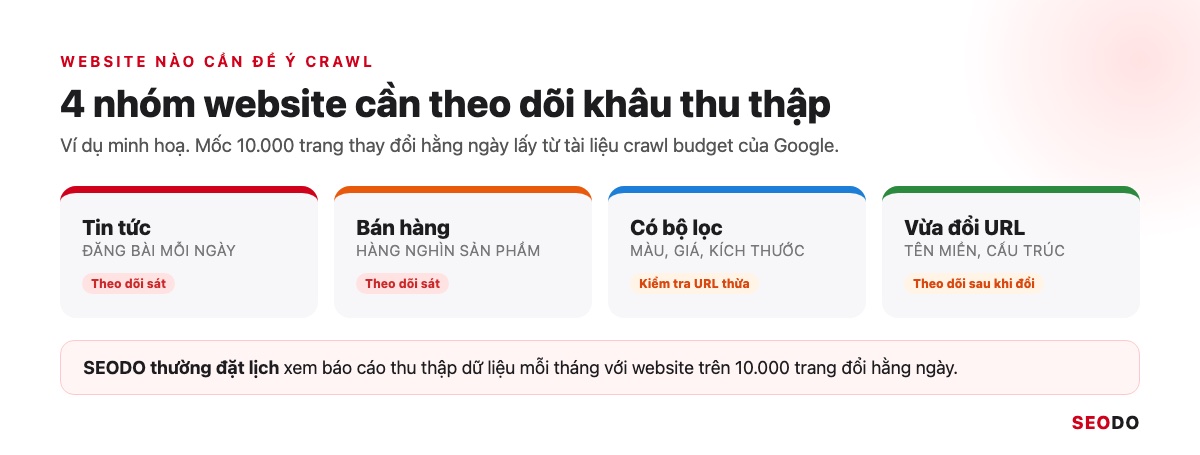
Google lấy mốc 10.000 trang thay đổi hằng ngày. Với website ở mức này, SEODO thường đặt lịch xem báo cáo thu thập dữ liệu mỗi tháng. Doanh nghiệp có website lớn nhưng chưa có người theo dõi phần này có thể giao việc rà định kỳ cho dịch vụ SEO.
4. Crawl budget là gì, website nào cần quan tâm?
Đối chiếu quy mô website với 3 mốc của Google trước khi bỏ công tối ưu.
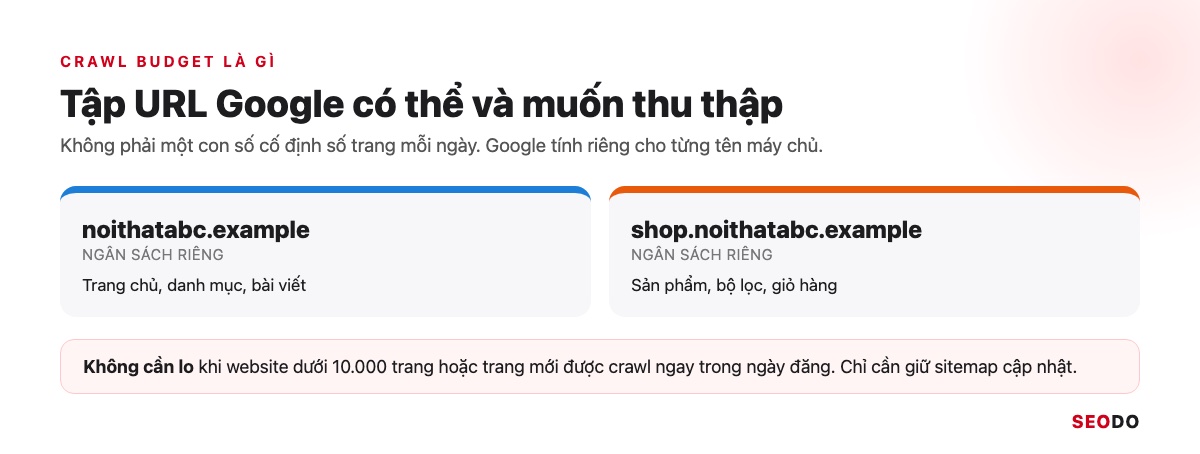
Crawl budget phụ thuộc giới hạn khả năng thu thập và nhu cầu thu thập. Website dưới 10.000 trang, có trang mới được crawl trong ngày đăng thì không cần lo.
Crawl budget (ngân sách thu thập dữ liệu) là tập URL mà Google có thể và muốn thu thập trên website, theo tài liệu Optimize your crawl budget (cập nhật 22/07/2026). Nó không phải số trang cố định mỗi ngày, và Google tính riêng cho từng tên máy chủ.
4.1. Giới hạn khả năng thu thập và nhu cầu thu thập
Crawl budget do 2 yếu tố quyết định. Giới hạn khả năng là mức Google tự đặt để không làm quá tải máy chủ, nhu cầu là mức Google muốn lấy dựa trên giá trị của URL.
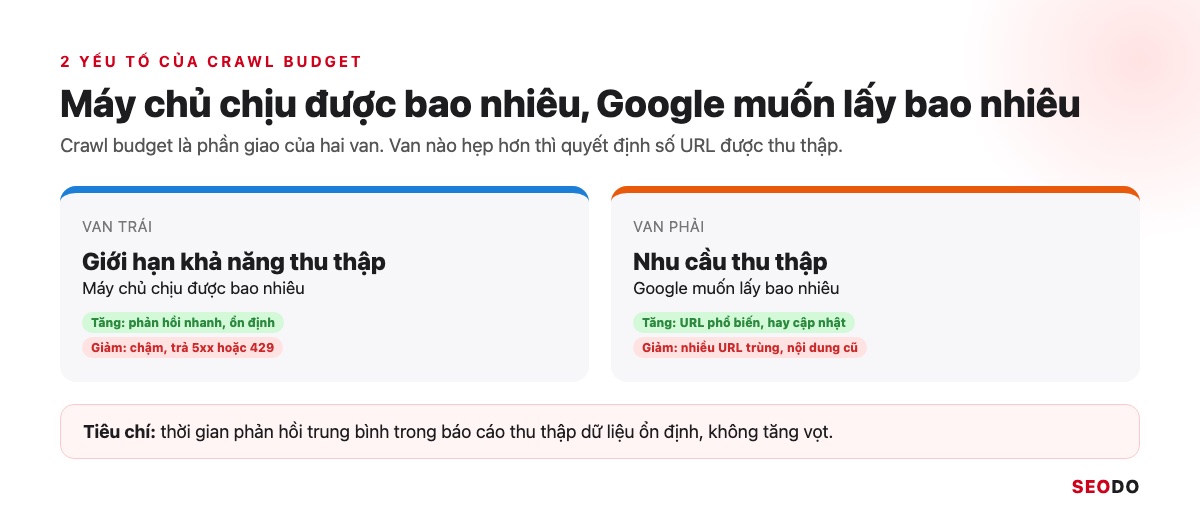
| Yếu tố | Làm tăng | Làm giảm |
| Giới hạn khả năng thu thập | Máy chủ phản hồi nhanh, ổn định | Phản hồi chậm, trả 5xx hoặc 429 |
| Nhu cầu thu thập | URL phổ biến, hay cập nhật | Nhiều URL trùng, nội dung cũ |
Tiêu chí là thời gian phản hồi trung bình ổn định, không tăng vọt.
4.2. Ngưỡng quy mô cần tối ưu crawl budget
Google chỉ khuyên tối ưu crawl budget khi website thuộc 1 trong 3 trường hợp:
- Trên 1 triệu trang, nội dung đổi khoảng mỗi tuần.
- Trên 10.000 trang, nội dung đổi hằng ngày.
- Nhiều URL ở trạng thái “Đã phát hiện ‑ hiện chưa được lập chỉ mục”.
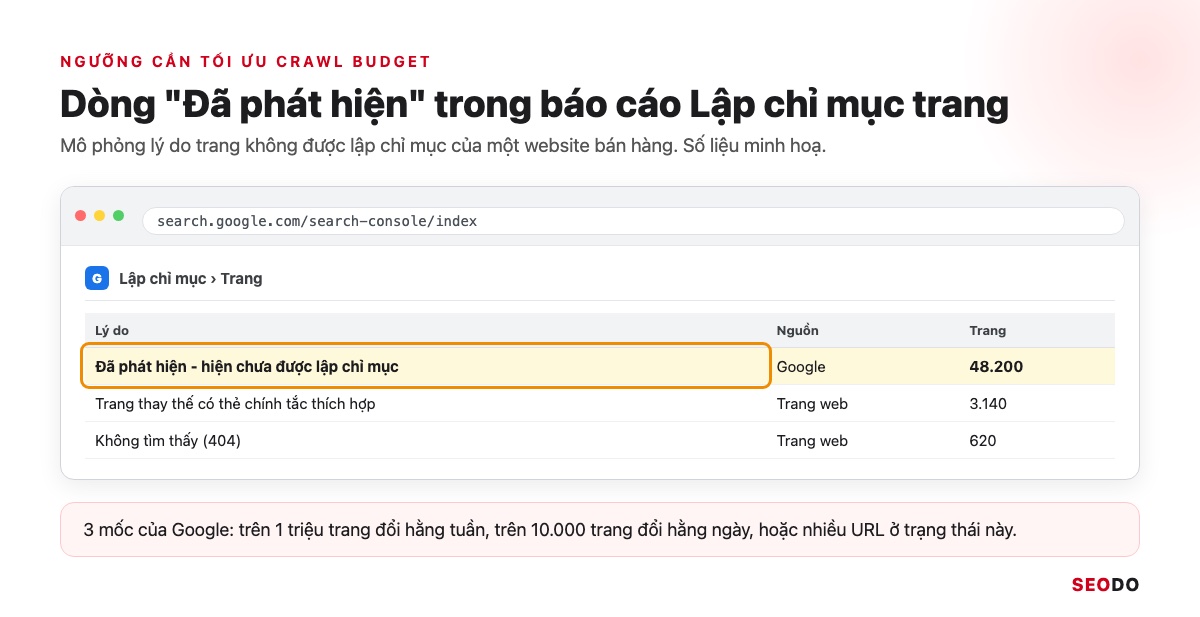
Google ghi đây là ước lượng thô. Bạn đếm số URL trong sitemap rồi so với 3 dòng trên.
4.3. Những việc không nên làm với crawl budget
Google khuyên tránh 3 việc:
- Dùng noindex để tiết kiệm, vì Google vẫn tải trang rồi mới bỏ.
- Dùng robots.txt để tạm chuyển ngân sách sang trang khác.
- Chặn trang đã xoá bằng robots.txt, trong khi nên trả 404 hoặc 410.
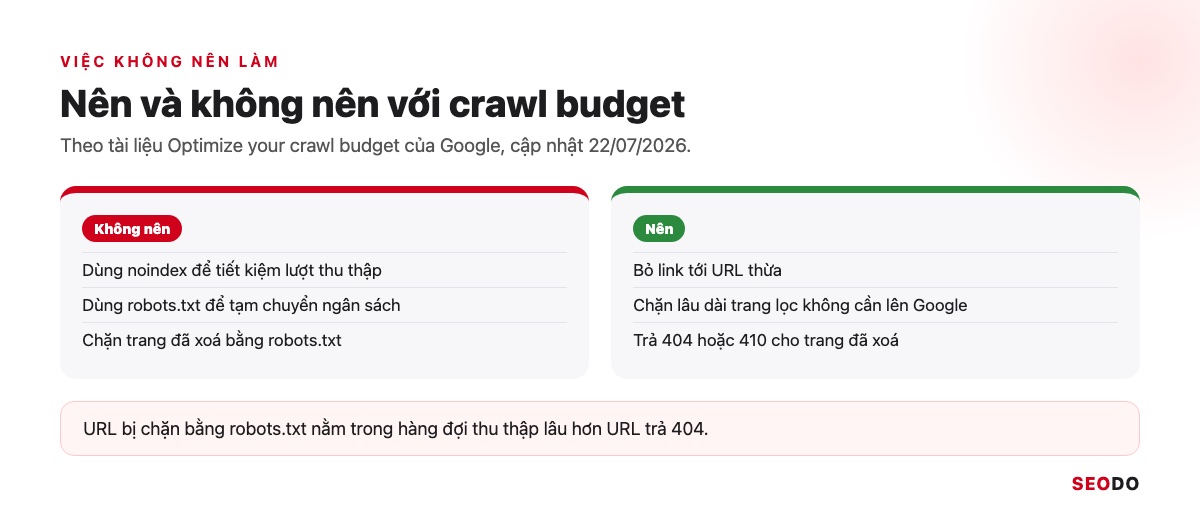
URL bị chặn nằm trong hàng đợi thu thập lâu hơn URL trả 404. Trang lọc không bao giờ cần lên Google thì chặn lâu dài bằng robots.txt.
5. Cách kiểm tra Googlebot đã crawl trang của bạn chưa
Ba cách từ nhanh đến chi tiết, chọn theo việc cần xem một trang hay cả website.
- Kiểm tra URL: lần thu thập gần nhất của 1 trang.
- Báo cáo thu thập dữ liệu: cả website, trạng thái máy chủ 90 ngày.
- Log máy chủ: từng lượt Googlebot vào.
Mở công cụ Kiểm tra URL trong Google Search Console để xem lần thu thập gần nhất của một trang. Xem cả website thì dùng báo cáo Số liệu thống kê về hoạt động thu thập dữ liệu, cần từng lượt thì đọc log máy chủ.
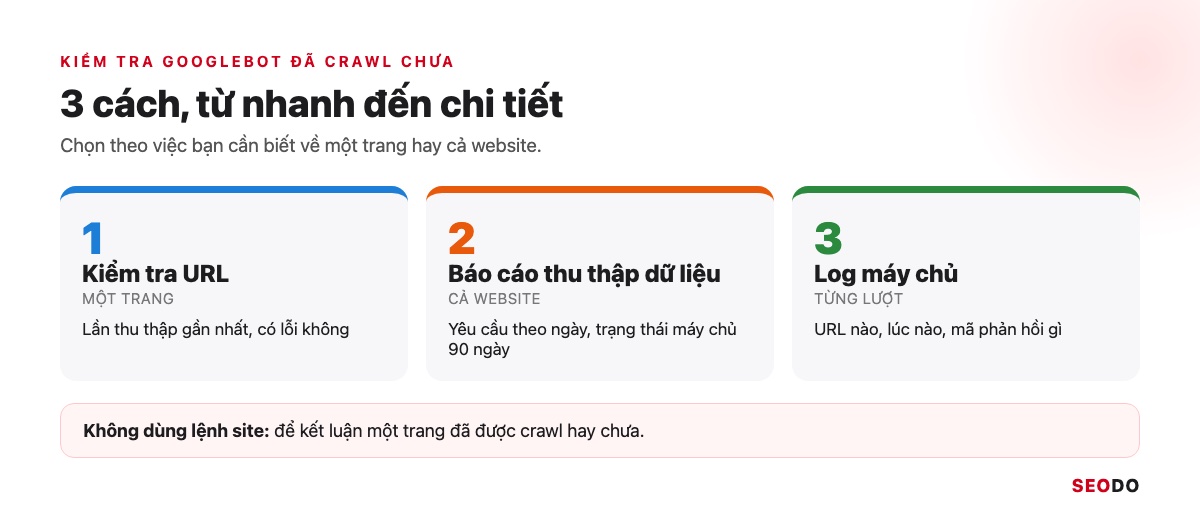
Lệnh site: không dùng để kết luận trang đã được crawl.
5.1. Công cụ Kiểm tra URL
Kiểm tra URL là công cụ trong Search Console cho biết Google đã thu thập một trang chưa và vào lúc nào. Dán URL vào ô tìm kiếm trên cùng rồi đọc 4 dòng:
- Lần thu thập thông tin gần đây nhất: ngày giờ Googlebot ghé.
- Tác nhân thu thập thông tin: bản điện thoại hay máy tính.
- Được phép thu thập thông tin?: robots.txt có chặn không.
- Tìm nạp trang: Google tải được trang không.
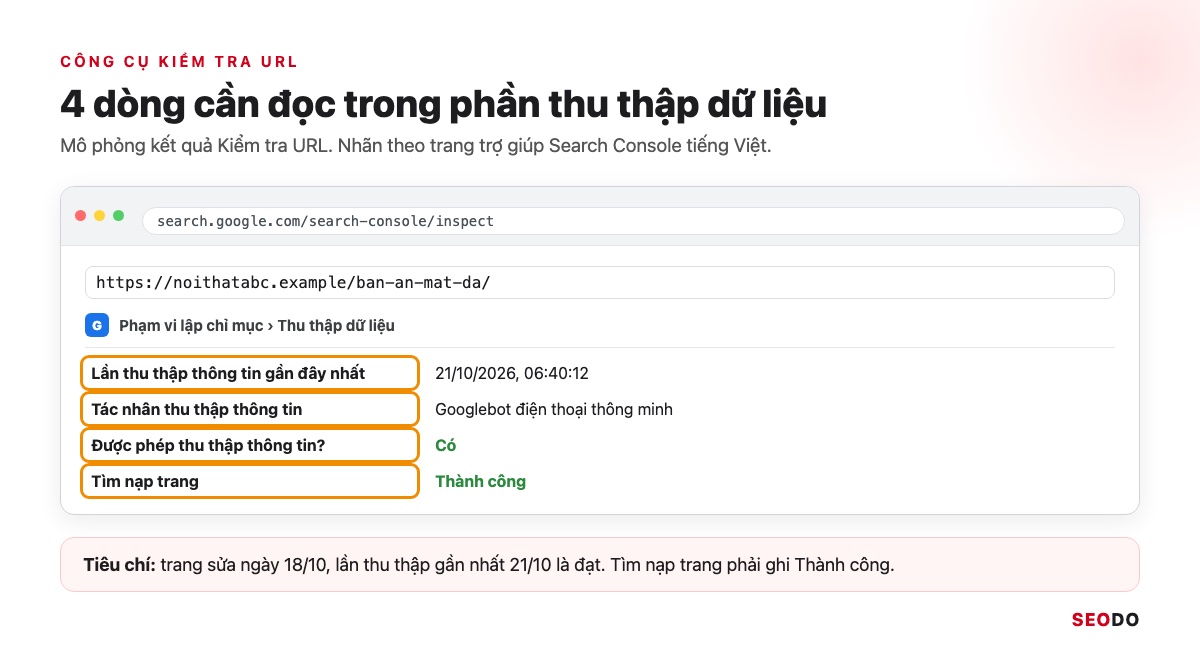
Tiêu chí là lần thu thập gần nhất sau ngày bạn sửa trang và Tìm nạp trang ghi Thành công.
5.2. Báo cáo Số liệu thống kê về hoạt động thu thập dữ liệu
Báo cáo này cho thấy Googlebot thu thập cả website ra sao, mở trong Cài đặt. Báo cáo chỉ có ở tài sản cấp miền gốc, và website dưới 1.000 trang thường không cần xem chi tiết.
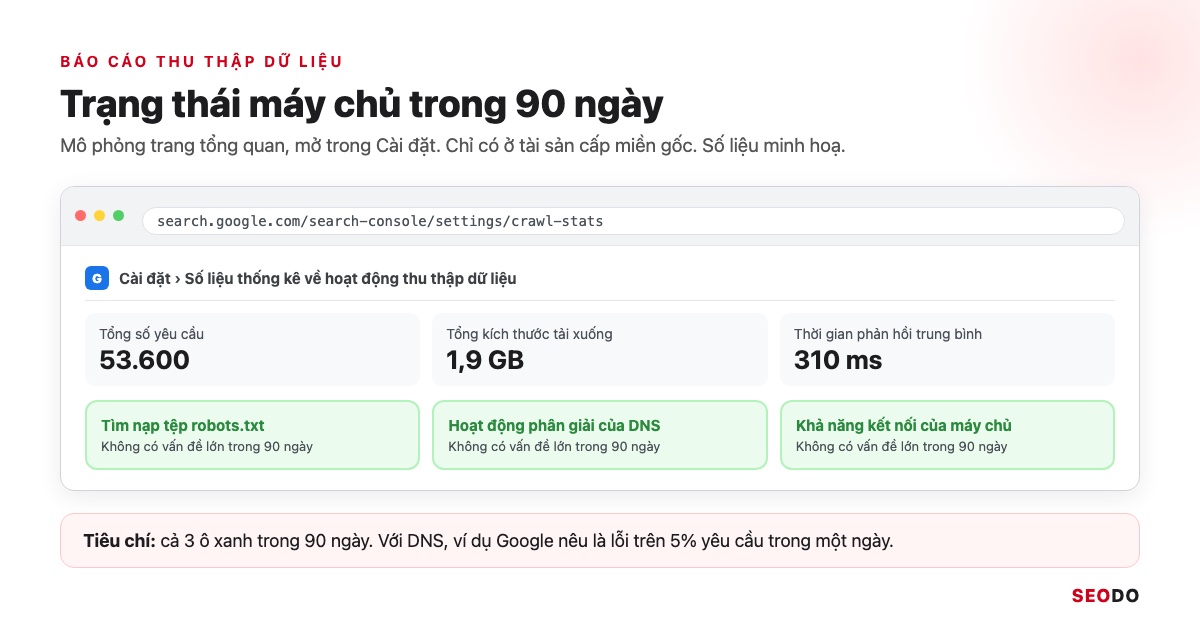
Báo cáo có 3 phần cần đọc:
- Biểu đồ theo ngày: số yêu cầu, dung lượng tải xuống, thời gian phản hồi.
- Bảng phân nhóm: theo phản hồi, loại tệp, mục đích, loại Googlebot.
- Trạng thái máy chủ: robots.txt, DNS, kết nối.
Tiêu chí là trạng thái máy chủ không có vấn đề lớn trong 90 ngày. Với DNS, ví dụ Google đưa ra là lỗi trên 5% yêu cầu trong một ngày.
5.3. Đọc log máy chủ và xác minh Googlebot thật
Log máy chủ ghi từng lượt Googlebot vào URL nào và nhận mã gì. User-agent dễ bị giả mạo, nên bạn xác minh bằng tra DNS ngược hoặc đối chiếu dải IP Google công bố.
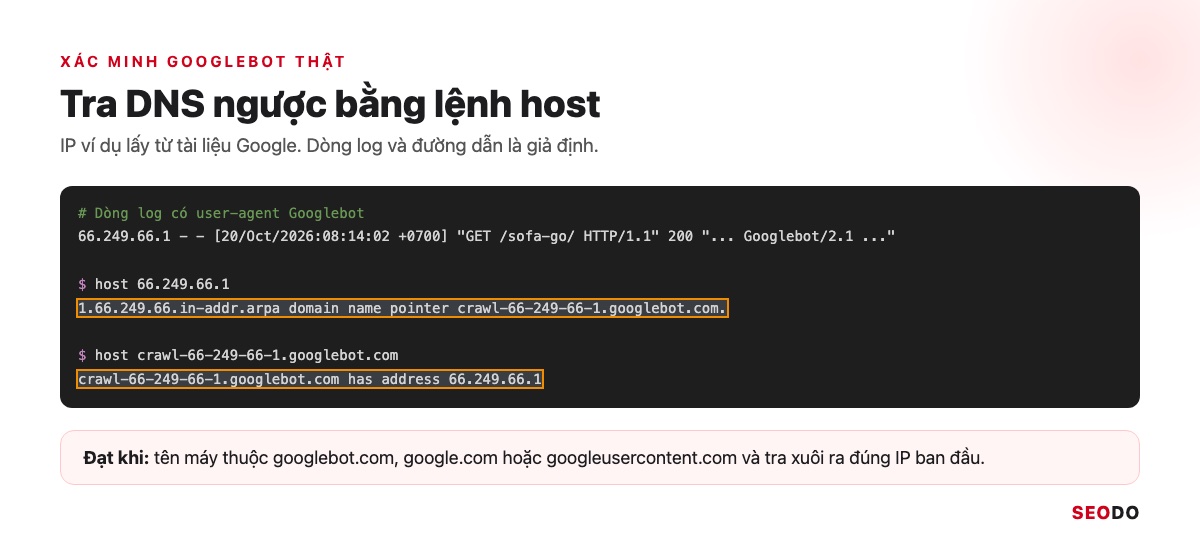
66.249.66.1 - - [20/Oct/2026:08:14:02 +0700] "GET /sofa-go/ HTTP/1.1" 200 "... Googlebot/2.1 ..."
$ host 66.249.66.1
... domain name pointer crawl-66-249-66-1.googlebot.com.
Tiêu chí là tên máy phân giải ra tên miền của Google như googlebot.com, rồi tra xuôi ra đúng IP ban đầu. Website lớn có thể phân tích log bằng Screaming Frog.
6. 8 lỗi crawl website thường gặp và cách sửa
Mỗi lỗi có dấu hiệu, cách Google xử lý và việc cần sửa.
- Không vào được: robots.txt, máy chủ, tường lửa.
- Vào nhầm chỗ: URL vô hạn, chuỗi chuyển hướng.
- Không thấy nội dung: link JavaScript, file quá 2MB, trang lỗi trả 200.
8 lỗi crawl chia 3 nhóm theo chỗ Googlebot gặp vấn đề. Mã phản hồi trong báo cáo thu thập dữ liệu được Google xếp nhóm như sau.
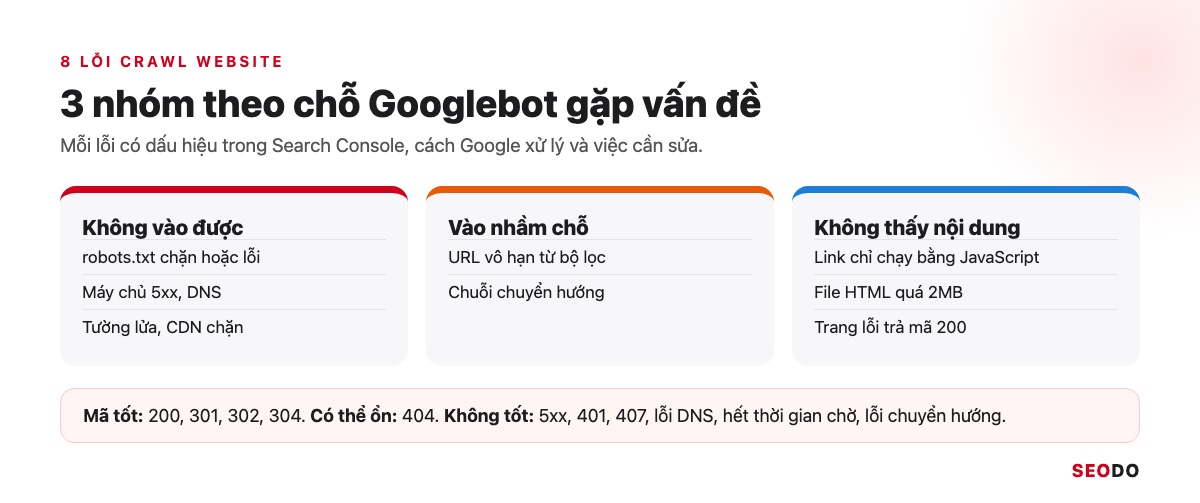
| Nhóm | Mã phản hồi |
| Tốt | 200, 301, 302, 304 |
| Có thể ổn | 404 |
| Không tốt | 5xx, 401, 407, 4xx khác, lỗi DNS, hết thời gian chờ, lỗi chuyển hướng |
6.1. robots.txt chặn nhầm hoặc trả lỗi máy chủ
Theo đặc tả robots.txt (cập nhật 31/08/2026), file trả 5xx thì Google dừng thu thập cả website trong 12 giờ đầu, sau đó dùng bản tốt gần nhất trong 30 ngày.
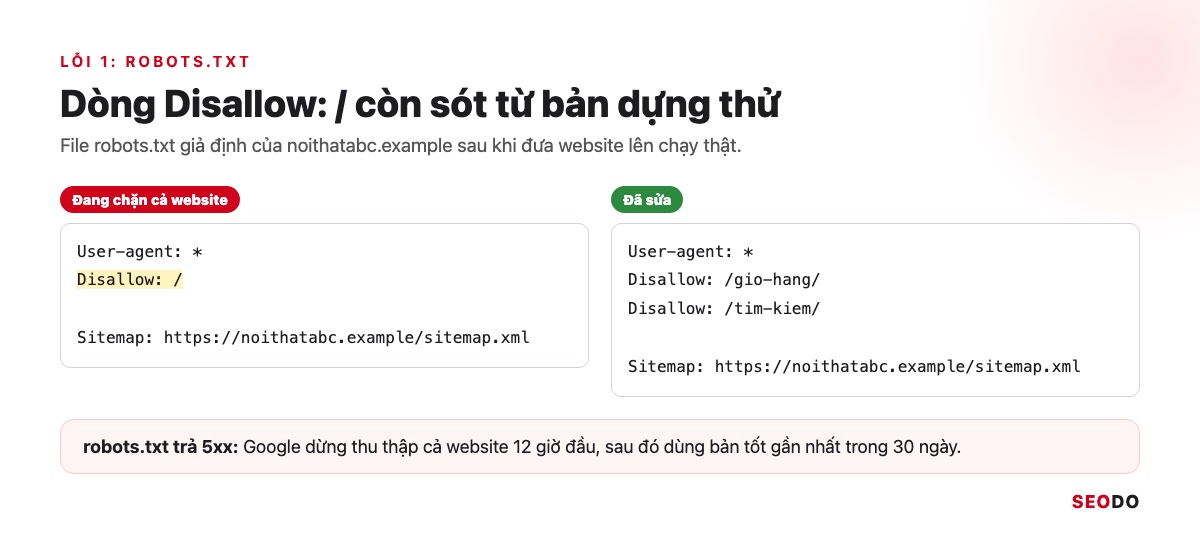
Tiêu chí là robots.txt trả 200 hoặc 404, không còn Disallow: / sót từ bản dựng thử. Xem thêm cú pháp và quy tắc trong robots.txt.
6.2. Máy chủ trả lỗi 5xx, quá tải hoặc lỗi DNS
Nhiều URL trả 500, 503 hoặc 429 thì Google giảm tốc độ thu thập cả tên máy chủ. Lỗi lặp trên cùng URL nhiều ngày thì URL có thể bị loại khỏi chỉ mục (Reduce the Google crawl rate, cập nhật 06/10/2026).
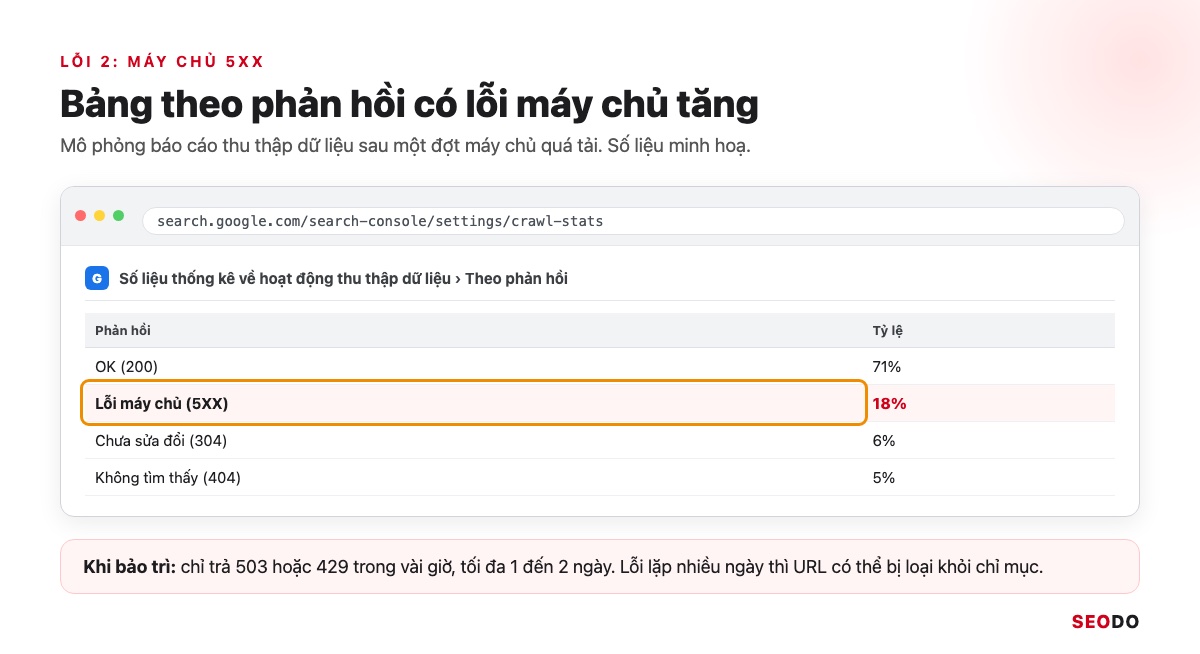
Tiêu chí là khi bảo trì chỉ trả 503 hoặc 429 trong vài giờ, tối đa 1 đến 2 ngày.
6.3. Tường lửa hoặc CDN chặn Googlebot
Tường lửa của CDN có thể chặn nhầm Googlebot hoặc hiện trang xác minh “bạn có phải người thật”. Theo Google (Crawling December, 24/12/2024), hết thời gian chờ mạng làm URL bị gỡ khỏi chỉ mục, nên lúc tạm chặn bot thì trả 503.
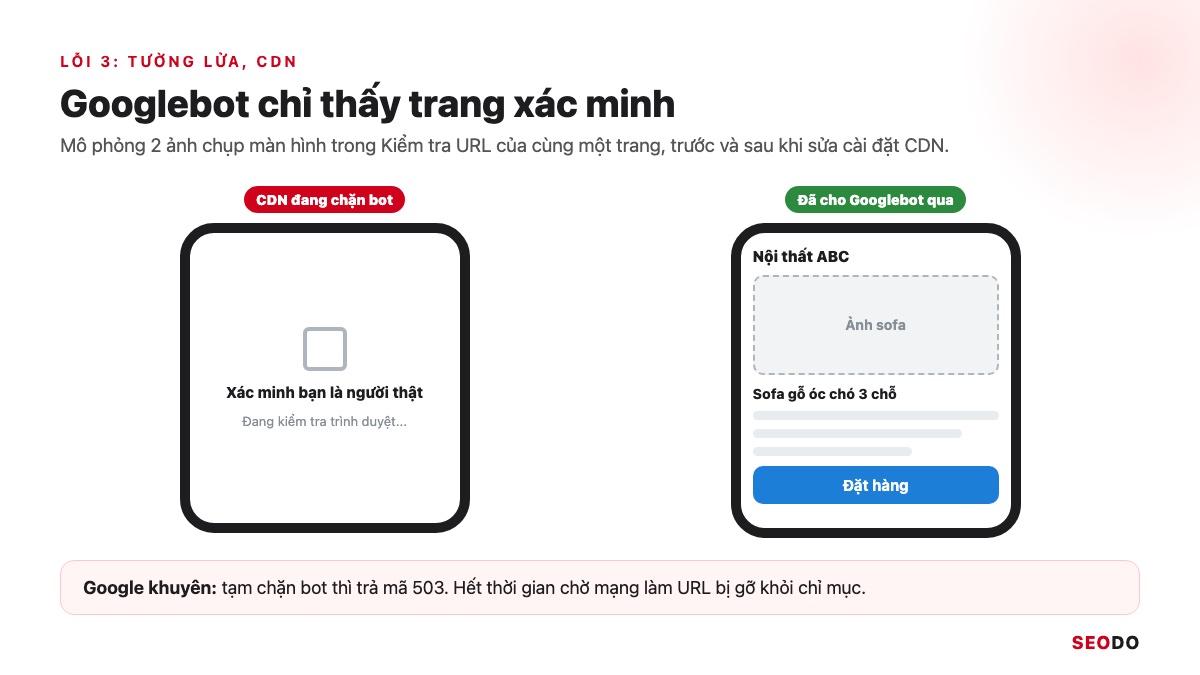
Tiêu chí là Ảnh chụp màn hình trong Kiểm tra URL hiện đúng trang, rà lại cài đặt CDN và tường lửa mỗi lần bật chống bot.
6.4. Bộ lọc, lịch, tham số sinh URL vô hạn
Bộ lọc nhiều tầng hay tham số sắp xếp có thể sinh hàng nghìn URL gần giống nhau, làm Googlebot tốn lượt. Dấu hiệu là URL mẫu trong báo cáo thu thập toàn ?sort= hay ?color=.
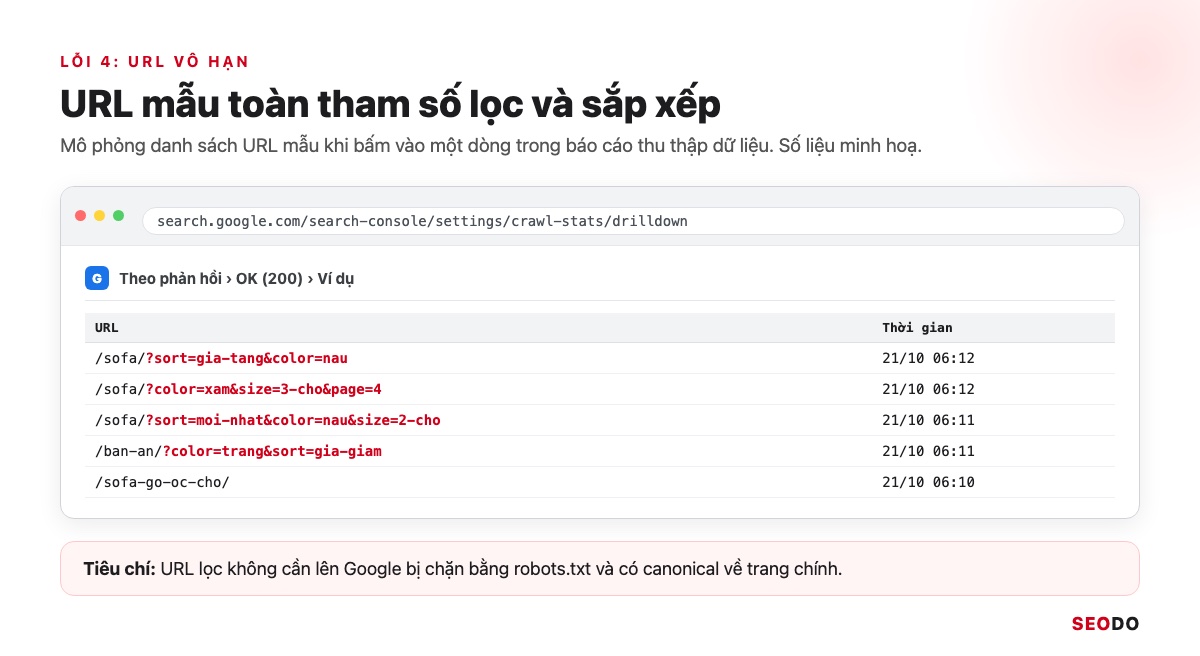
Tiêu chí là URL lọc không cần lên Google bị chặn bằng robots.txt và có canonical về trang chính. Xem thêm cách xử lý trang phân trang và bộ lọc.
6.5. Chuỗi chuyển hướng và vòng lặp chuyển hướng
Mỗi bước chuyển hướng tốn thêm một lượt yêu cầu, vòng lặp làm Googlebot không tới được trang đích.
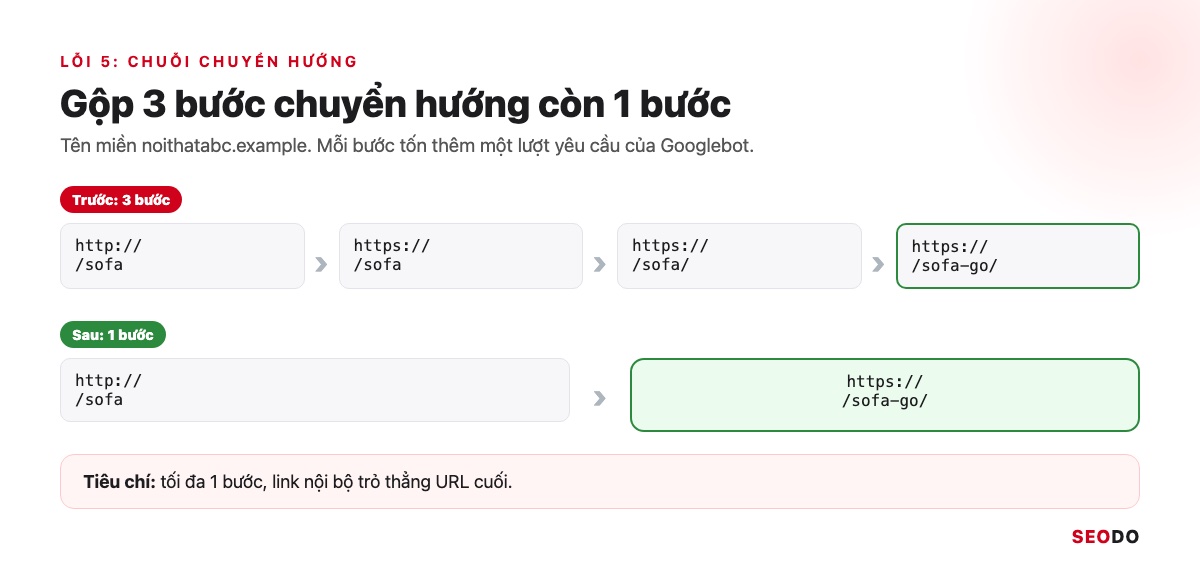
Tiêu chí là tối đa 1 bước, link nội bộ trỏ thẳng URL cuối. Khi đổi URL, đặt redirect 301 thẳng về URL mới.
6.6. Link chỉ chạy bằng JavaScript và trang mồ côi
Google đi theo thẻ a có href, nút bấm JavaScript không có href thì Googlebot bỏ qua. Trang không có link nội bộ nào trỏ tới là trang mồ côi.
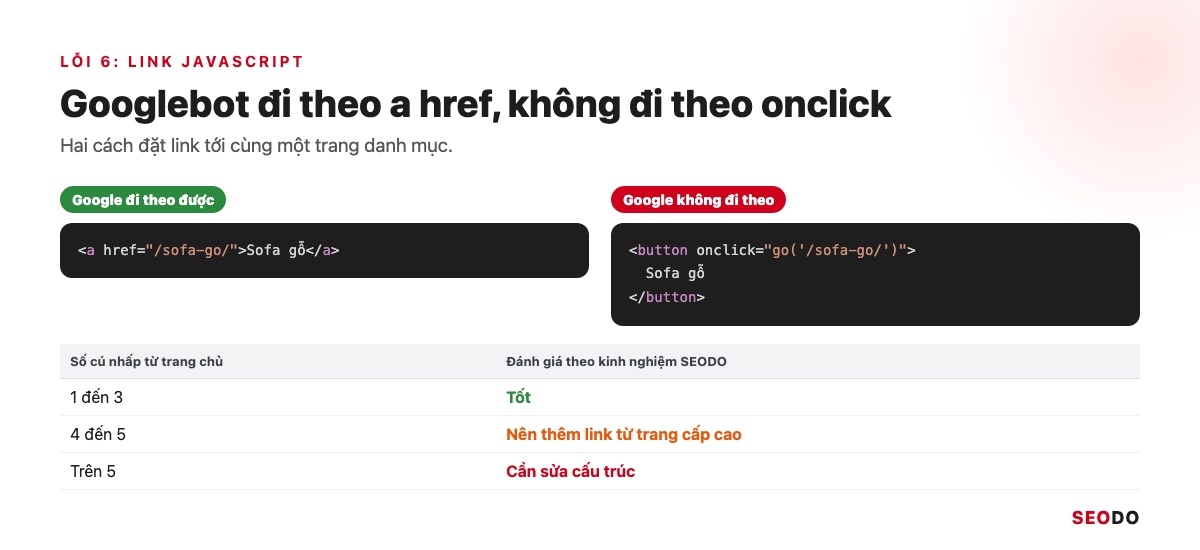
Tiêu chí là mọi trang có ít nhất 1 liên kết nội bộ. Theo kinh nghiệm của SEODO, trang quan trọng cách trang chủ tối đa 4 cú nhấp.
| Số cú nhấp từ trang chủ | Đánh giá |
| 1 đến 3 | Tốt |
| 4 đến 5 | Nên thêm link từ trang cấp cao |
| Trên 5 | Cần sửa cấu trúc |
6.7. Trang quá nặng vượt giới hạn Googlebot đọc
Googlebot dừng ở 2MB đầu của HTML chưa nén, phần sau không được xét lập chỉ mục. Trang nhúng khối JSON lớn dễ vượt mốc này.
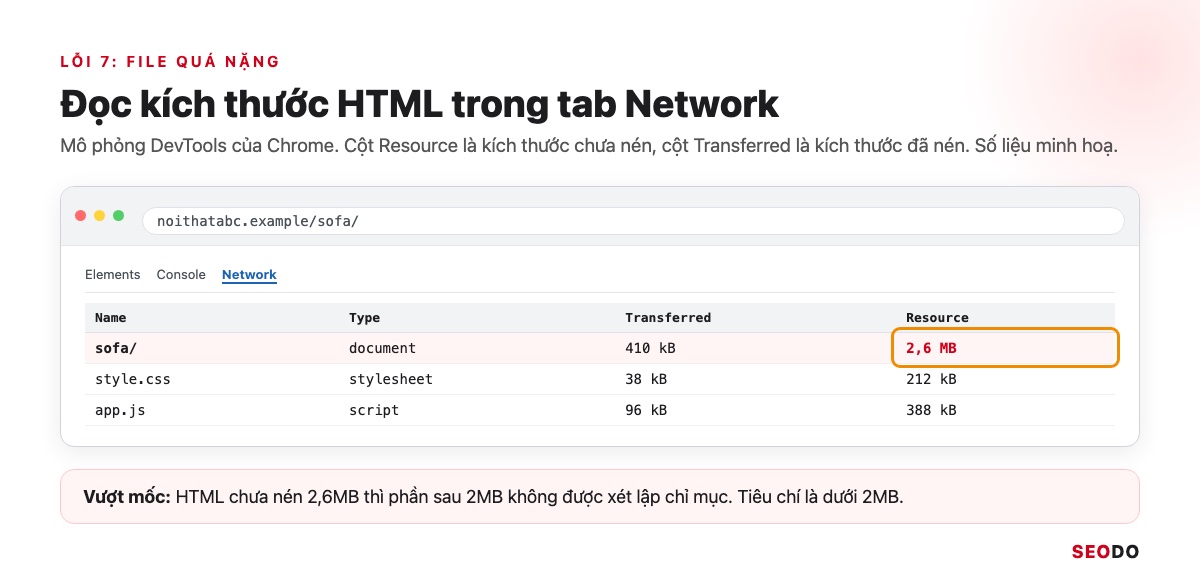
Xem kích thước chưa nén của HTML trong tab Network của DevTools. Tiêu chí là dưới 2MB.
6.8. Lỗi trả mã 200 kèm trang báo lỗi (soft 404)
Soft 404 là trang báo “không tìm thấy” nhưng máy chủ trả 200. Google có thể xếp trang vào Lỗi 404 mềm hoặc coi các trang lỗi giống nhau là trùng lặp.
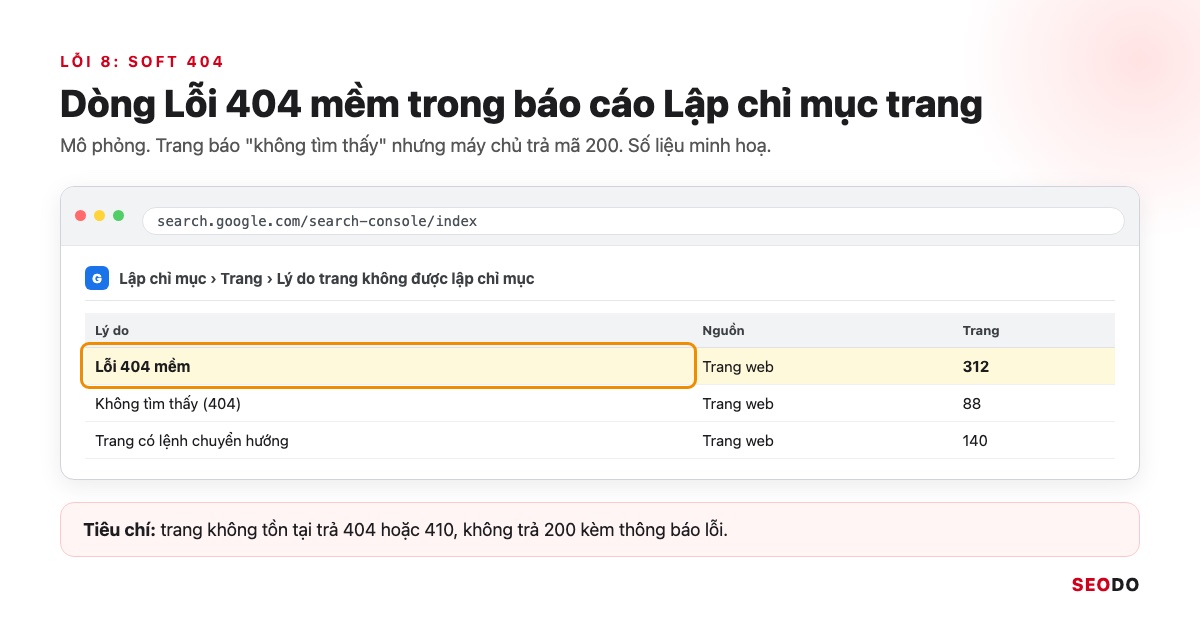
Tiêu chí là trang không tồn tại trả 404 hoặc 410. Chi tiết ở bài lỗi 404 not found.
Tóm tắt 8 lỗi crawl
| Lỗi | Dấu hiệu | Cách sửa |
| robots.txt | Bị robots.txt chặn | Trả 200, bỏ Disallow: / |
| Máy chủ 5xx | Lỗi 5xx tăng | 503 tối đa 1 đến 2 ngày |
| CDN chặn | Ảnh chụp là trang xác minh | Tạm chặn thì trả 503 |
| URL vô hạn | URL mẫu toàn tham số | robots.txt, canonical |
| Chuỗi chuyển hướng | Lỗi chuyển hướng | Tối đa 1 bước |
| Link JavaScript | Trang chưa được phát hiện | Thêm a href |
| File quá 2MB | Thiếu nội dung | HTML dưới 2MB |
| Soft 404 | Lỗi 404 mềm | Trả 404 hoặc 410 |
7. Cách giúp Googlebot thu thập dữ liệu nhanh và đúng trang
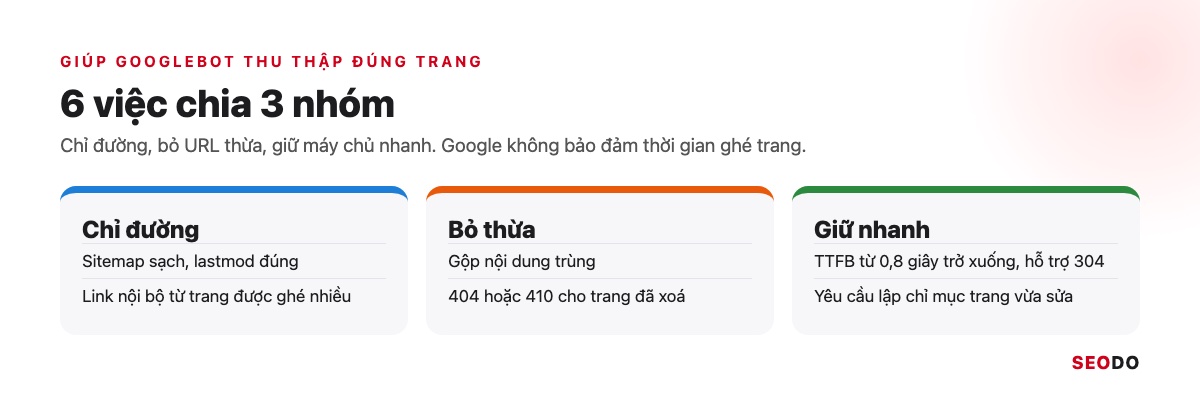
Sáu việc để Googlebot dành lượt cho trang bạn muốn lên Google.
Chỉ đường bằng sitemap và link nội bộ, bỏ URL thừa, giữ TTFB từ 0,8 giây trở xuống. Google không bảo đảm thời gian ghé trang.
Cho Google biết trang nào cần thu thập bằng link nội bộ và sitemap, bỏ URL thừa, rồi giữ máy chủ phản hồi nhanh. Google cũng không nhận tiền để thu thập website thường xuyên hơn.
7.1. Giữ sitemap chỉ gồm URL cần lên Google, có lastmod đúng
Tiêu chí là 100% URL trong sitemap trả 200, có canonical về chính nó, lastmod chỉ đổi khi nội dung đổi.
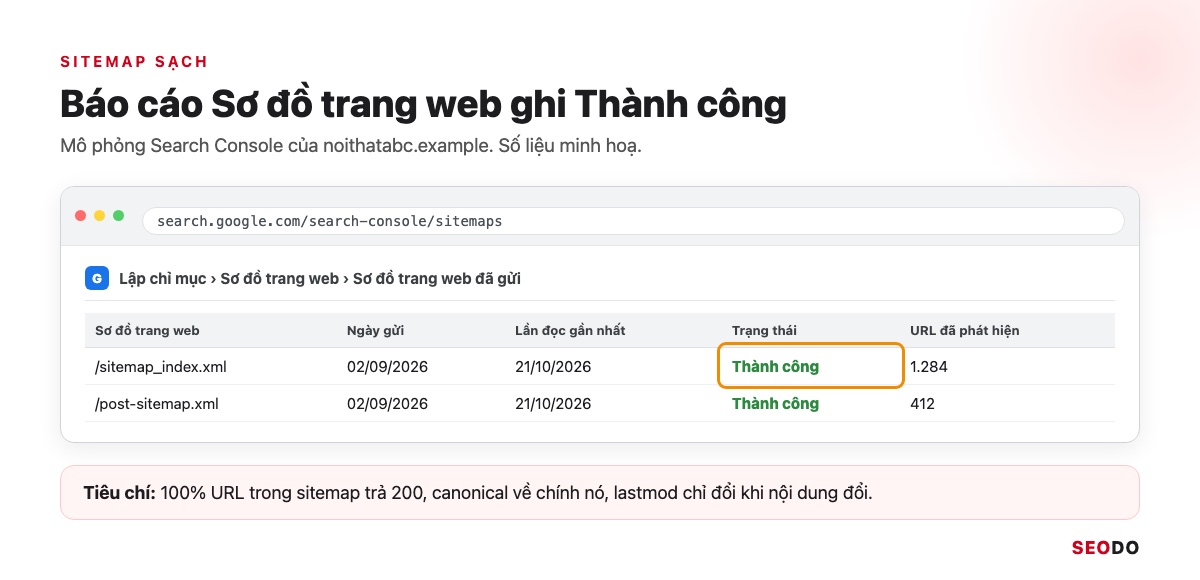
Báo cáo Sơ đồ trang web phải ghi Thành công. Cách tạo và gửi sitemap XML có hướng dẫn riêng.
7.2. Đặt link nội bộ tới trang mới từ trang được ghé nhiều
Trang chủ và trang danh mục đổi nội dung thường xuyên nên Googlebot hay quay lại. Tiêu chí là bài mới có link từ đó trong ngày đăng, cách trang chủ tối đa 4 cú nhấp.
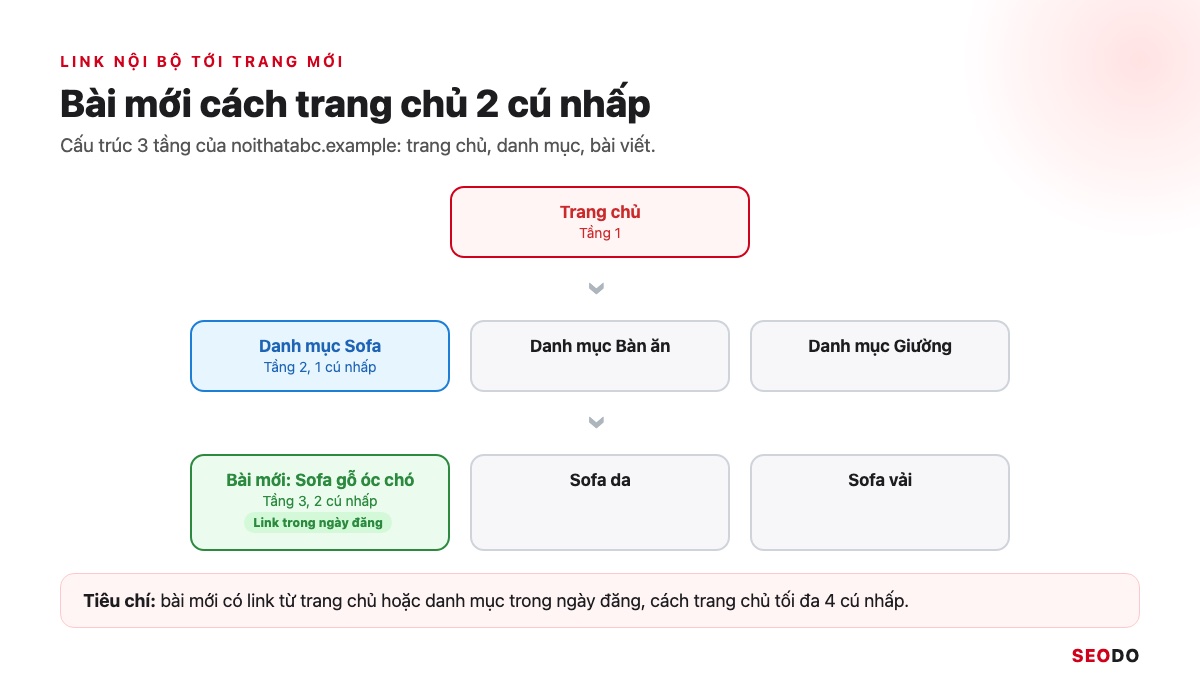
Website nhiều sản phẩm cần cấu trúc website nhiều tầng rõ ràng.
7.3. Hợp nhất nội dung trùng lặp
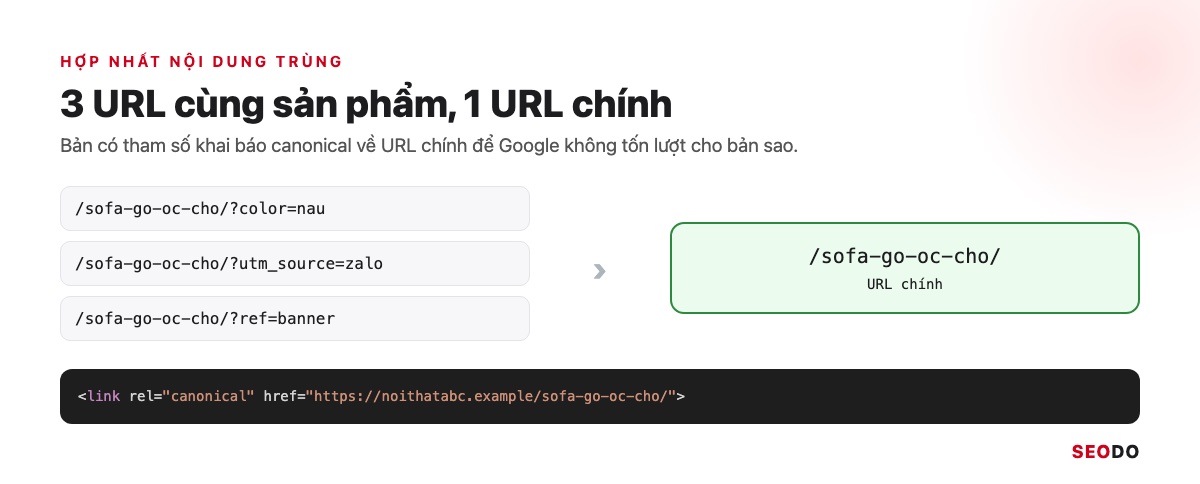
Nhiều URL cùng nội dung làm Google tốn lượt cho bản sao. Tiêu chí là mỗi nội dung có 1 URL chính, bản trùng có thẻ canonical hoặc 301 về đó.
7.4. Giữ máy chủ phản hồi nhanh và hỗ trợ mã 304
Trang chưa đổi thì máy chủ trả 304 để Google dùng lại bản đã lưu. Tiêu chí là TTFB từ 0,8 giây trở xuống (web.dev).
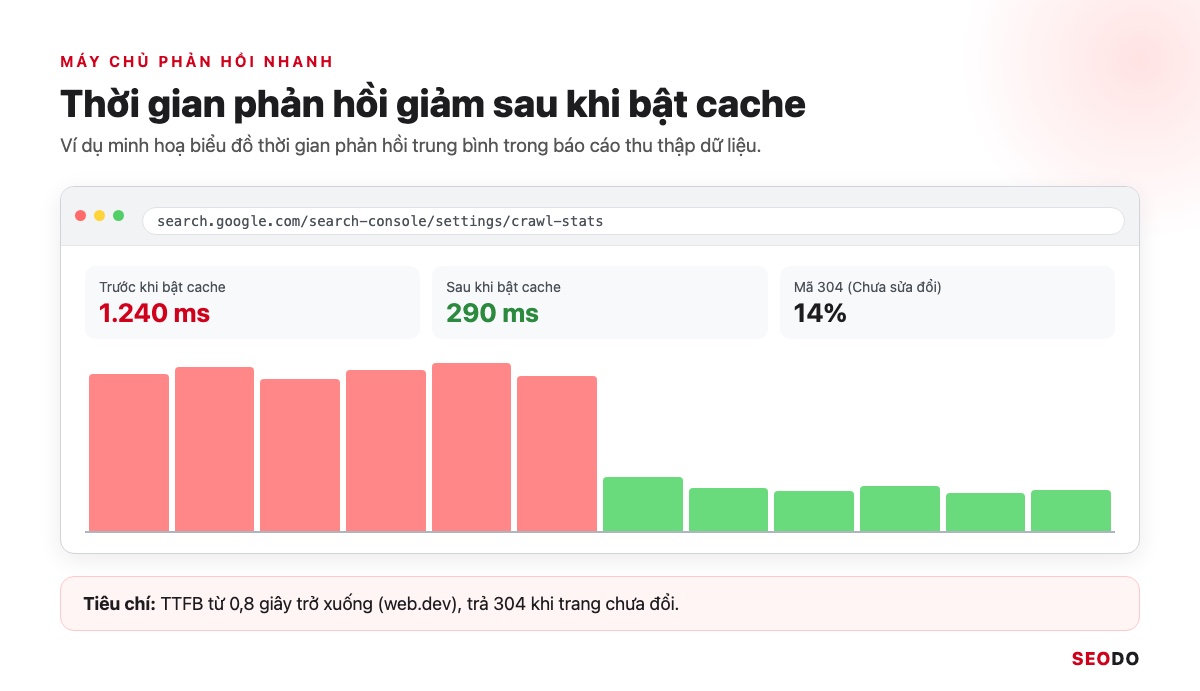
Bật cache và các việc tối ưu tốc độ website kéo con số này xuống.
7.5. Trả 404 hoặc 410 cho trang đã xoá
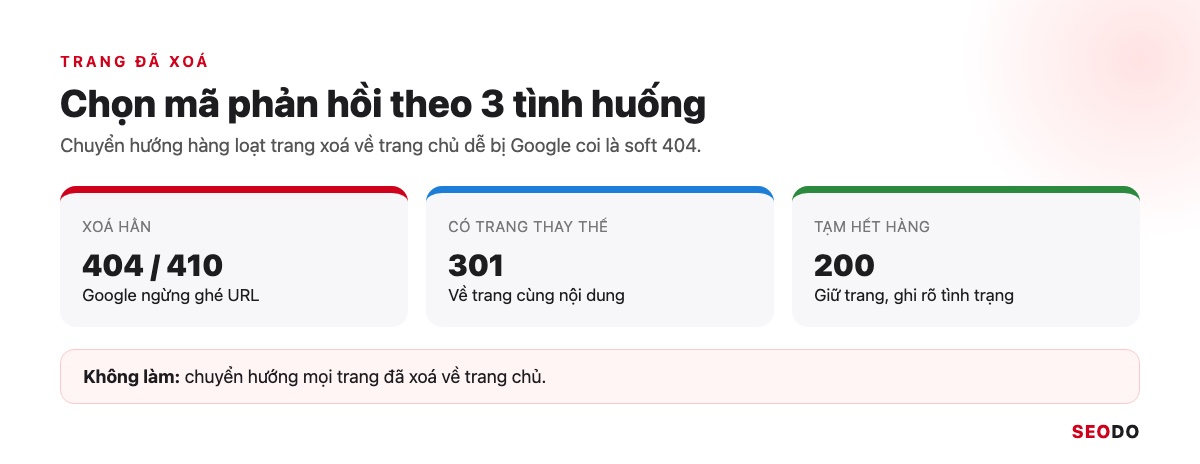
Trả 404 hoặc 410 để Google ngừng ghé URL đã xoá. Chuyển hướng hàng loạt về trang chủ dễ bị coi là soft 404, nên chọn mã theo tình huống:
- Xoá hẳn: 404 hoặc 410.
- Có trang thay thế: 301.
- Tạm hết hàng: giữ 200.
7.6. Yêu cầu lập chỉ mục cho trang quan trọng vừa sửa
Nút Yêu cầu lập chỉ mục có hạn mức mỗi ngày, gửi lặp không nhanh hơn, và việc thu thập có thể mất vài ngày đến vài tuần.
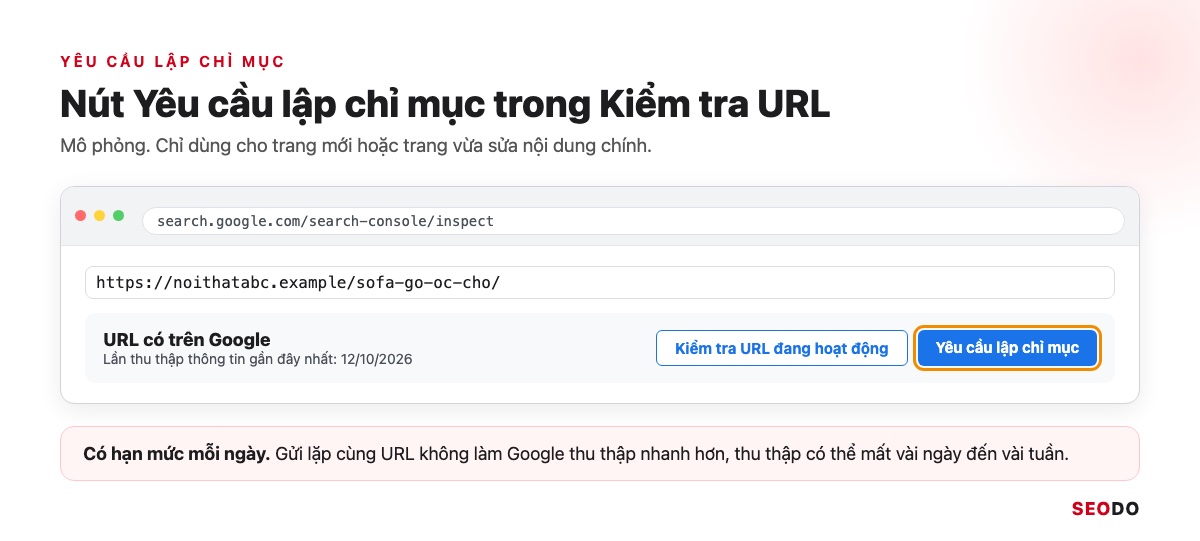
Tiêu chí là chỉ gửi trang mới hoặc vừa sửa nội dung chính. Thao tác có trong bài gửi URL lên Google.
8. 5 hiểu lầm về Google crawl nên bỏ
Năm mẹo cũ đặt cạnh tài liệu Google hiện hành.
Cả 5 điều đều trái tài liệu Google. Gây hại nhất là dùng robots.txt để ẩn trang.
Các hiểu lầm về Google crawl đến từ mẹo cũ.
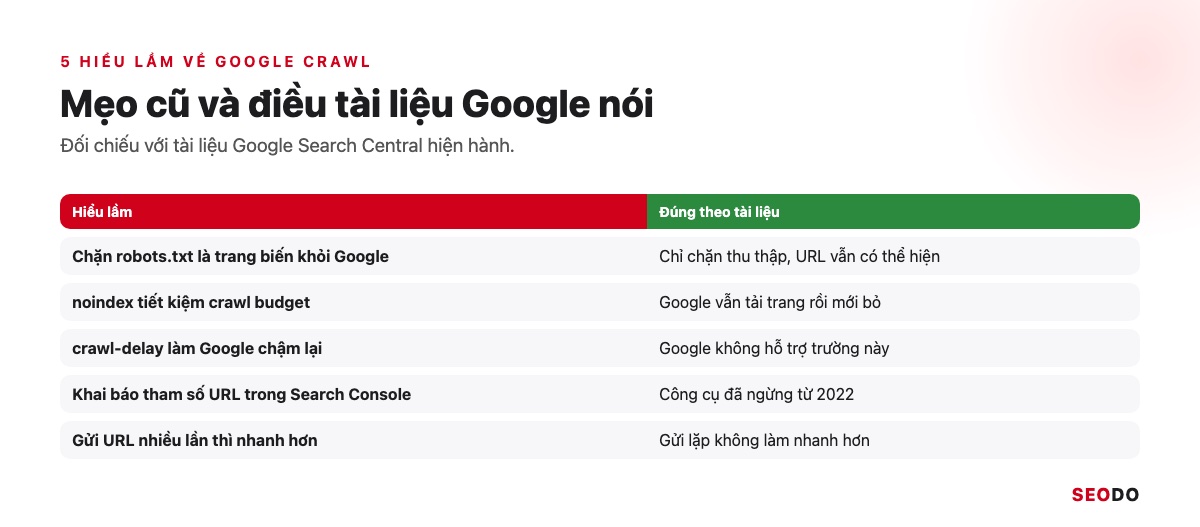
| Hiểu lầm | Đúng theo tài liệu |
| robots.txt ẩn trang | Chỉ chặn thu thập |
| noindex tiết kiệm lượt | Google vẫn tải trang |
| crawl-delay | Không được hỗ trợ |
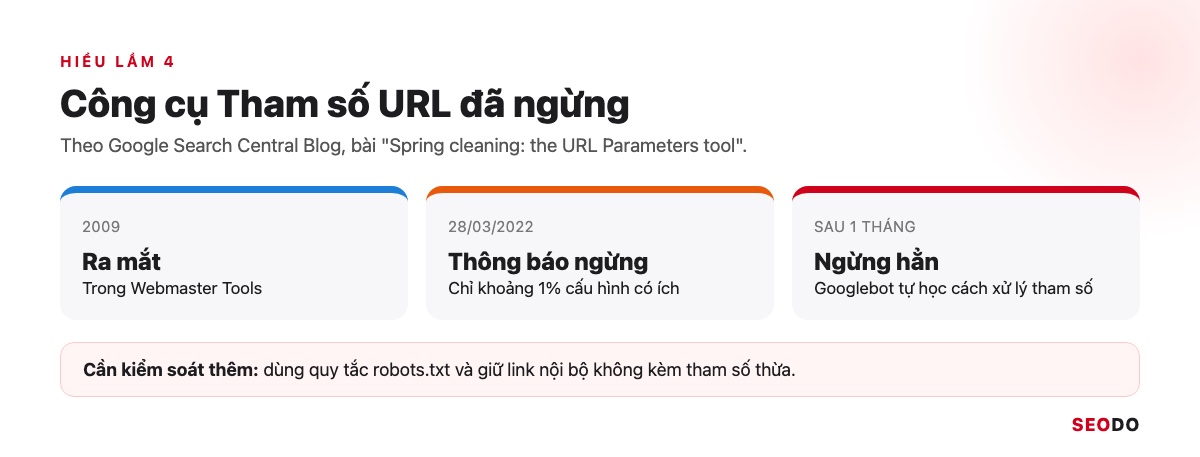
| Tham số URL | Ngừng từ 2022 |
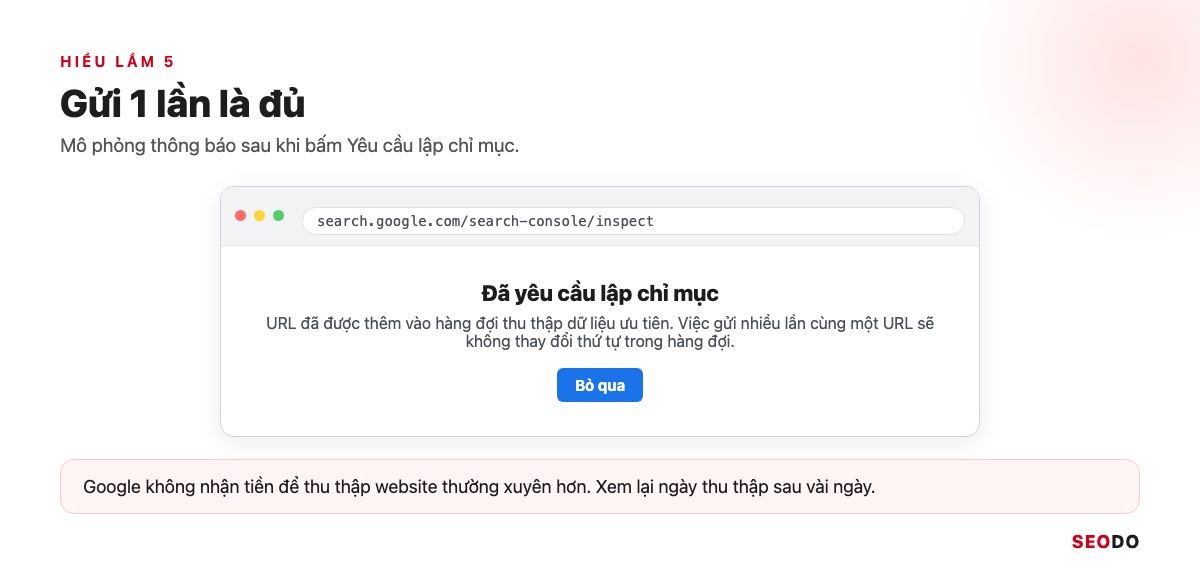
| Gửi URL nhiều lần | Không nhanh hơn |
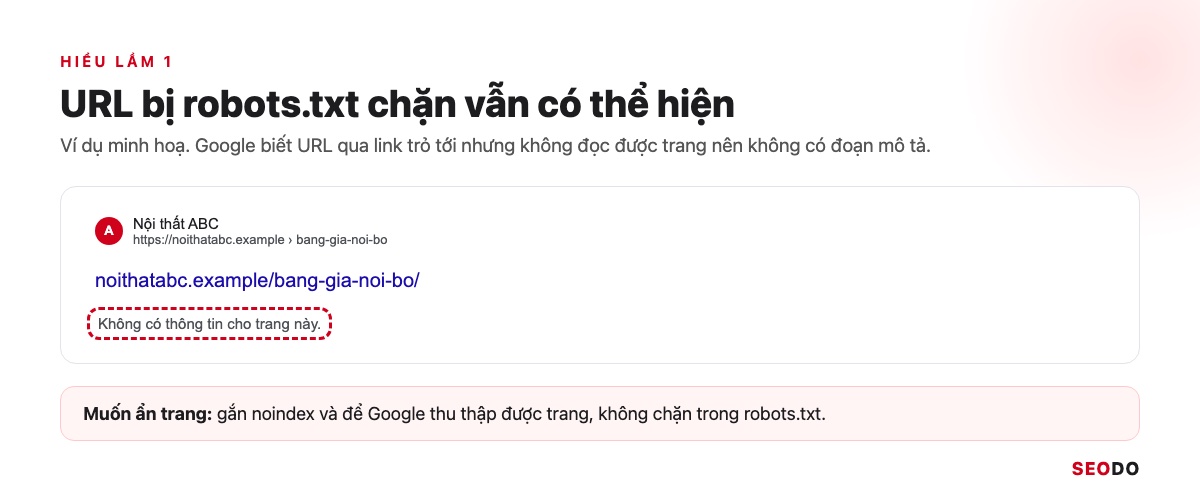
8.1. “Chặn bằng robots.txt là trang biến mất khỏi Google”
Sai. robots.txt chặn thu thập chứ không chặn lập chỉ mục, URL bị chặn vẫn có thể hiện nếu có link trỏ tới. Muốn ẩn thì dùng noindex và để Google vào được trang.
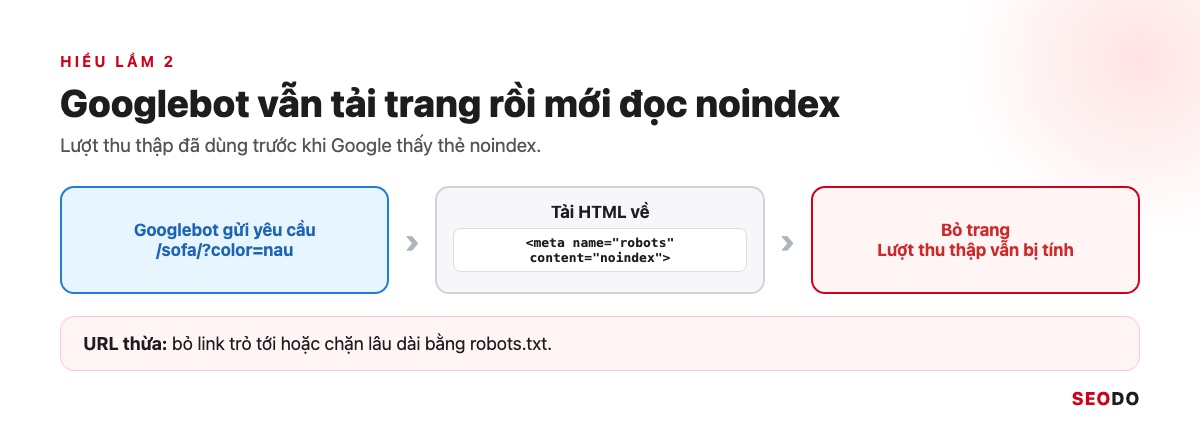
8.2. “Thêm noindex để tiết kiệm crawl budget”
Sai. Google phải tải trang mới đọc được noindex. URL thừa thì bỏ link hoặc chặn lâu dài bằng robots.txt.
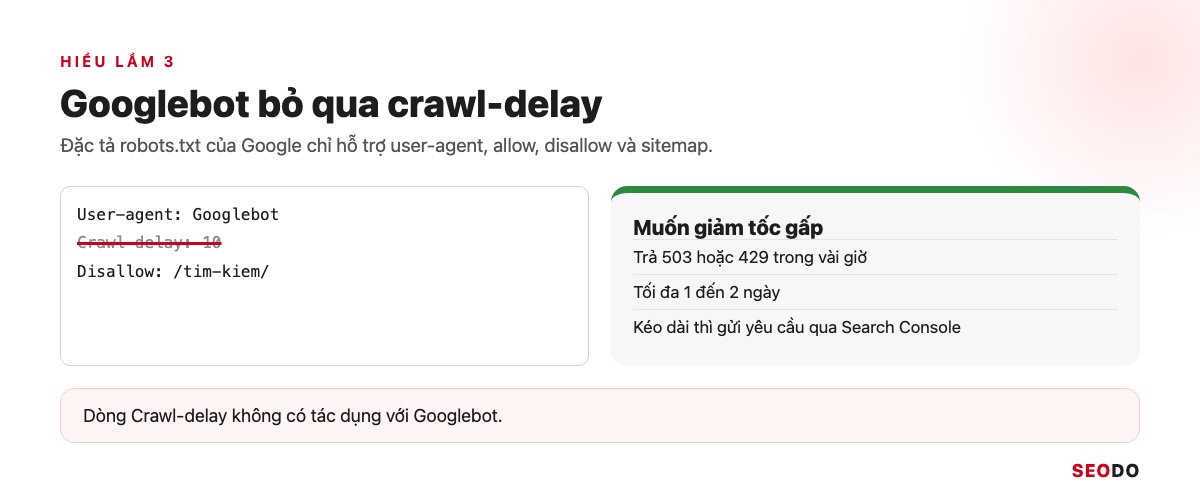
8.3. “Đặt crawl-delay để Google crawl chậm lại”
Không tác dụng, Google không hỗ trợ crawl-delay. Muốn giảm tốc gấp thì trả 503 hoặc 429 tối đa 1 đến 2 ngày.
8.4. “Khai báo tham số URL trong Search Console”
Công cụ này đã ngừng, Google báo ngày 28/03/2022 và tắt sau 1 tháng. Googlebot tự học cách xử lý tham số.
8.5. “Gửi URL nhiều lần thì Google crawl nhanh hơn”
Không nhanh hơn. Mỗi URL gửi 1 lần sau khi sửa xong, rồi xem lại ngày thu thập sau vài ngày.
9. Câu hỏi thường gặp về Google crawl
9.1. Crawl data để làm gì?
Trong SEO, Google crawl data để có nội dung đưa vào chỉ mục và hiển thị trên kết quả tìm kiếm. “Crawl data” bằng phần mềm để lấy dữ liệu website khác là việc khác.
9.2. Googlebot ghé website bao lâu một lần?
Google không công bố lịch cố định. Thuật toán quyết định tần suất dựa trên nhu cầu thu thập và sức chịu tải của máy chủ. Số lượt thực tế theo ngày nằm trong báo cáo Số liệu thống kê về hoạt động thu thập dữ liệu.
9.3. Website nhỏ có cần lo crawl budget không?
Không. Tài liệu Google ghi website ít trang, hoặc có trang mới được thu thập ngay trong ngày đăng, chỉ cần giữ sitemap cập nhật và xem báo cáo Lập chỉ mục trang định kỳ.
9.4. Chặn Google-Extended có làm Google ngừng crawl để xếp hạng không?
Không. Theo trang Google’s common crawlers (cập nhật 15/10/2026), Google-Extended không ảnh hưởng việc website có mặt trên Google Search và không phải tín hiệu xếp hạng. Nó chỉ kiểm soát việc dùng nội dung cho các mô hình Gemini.
9.5. Website mới bao lâu thì được Google crawl?
Google không công bố con số. Website đã gửi sitemap trong Search Console và có link từ website khác trỏ về thường được tìm thấy sớm hơn. Máy chủ phản hồi ổn định thì Googlebot không phải giảm tốc.
Nguồn tham khảo
- Google Search Central: In-depth guide to how Google Search works (cập nhật 18/12/2025)
- Google Search Central: What is Googlebot (cập nhật 03/02/2026)
- Google Search Central: Optimize your crawl budget (cập nhật 22/07/2026)
- Search Console Help: Báo cáo Số liệu thống kê về hoạt động thu thập dữ liệu
- Search Console Help: Công cụ Kiểm tra URL, Báo cáo Lập chỉ mục trang
- Google Crawling Infrastructure: Verify requests from Google crawlers and fetchers (cập nhật 20/03/2026)
- Google Crawling Infrastructure: How Google interprets the robots.txt specification (cập nhật 31/08/2026)
- Google Search Central: Reduce the Google crawl rate (cập nhật 06/10/2026)
- Google Search Central Blog: Crawling December, CDNs and crawling (24/12/2024)
- Google Search Central Blog: Spring cleaning, the URL Parameters tool (28/03/2022)
- Google Search Central: Ask Google to recrawl your URLs (cập nhật 10/12/2025)
- Google Search Central: Google’s common crawlers (cập nhật 15/10/2026)
- web.dev: Time to First Byte (TTFB)